llama.cpp v0.7.0 อัปเดตครั้งใหญ่ เพิ่ม MoE Cache เร่งการสร้างข้อความสูงสุด 2.2 เท่า พร้อมรองรับโมเดล AI รุ่นใหม่
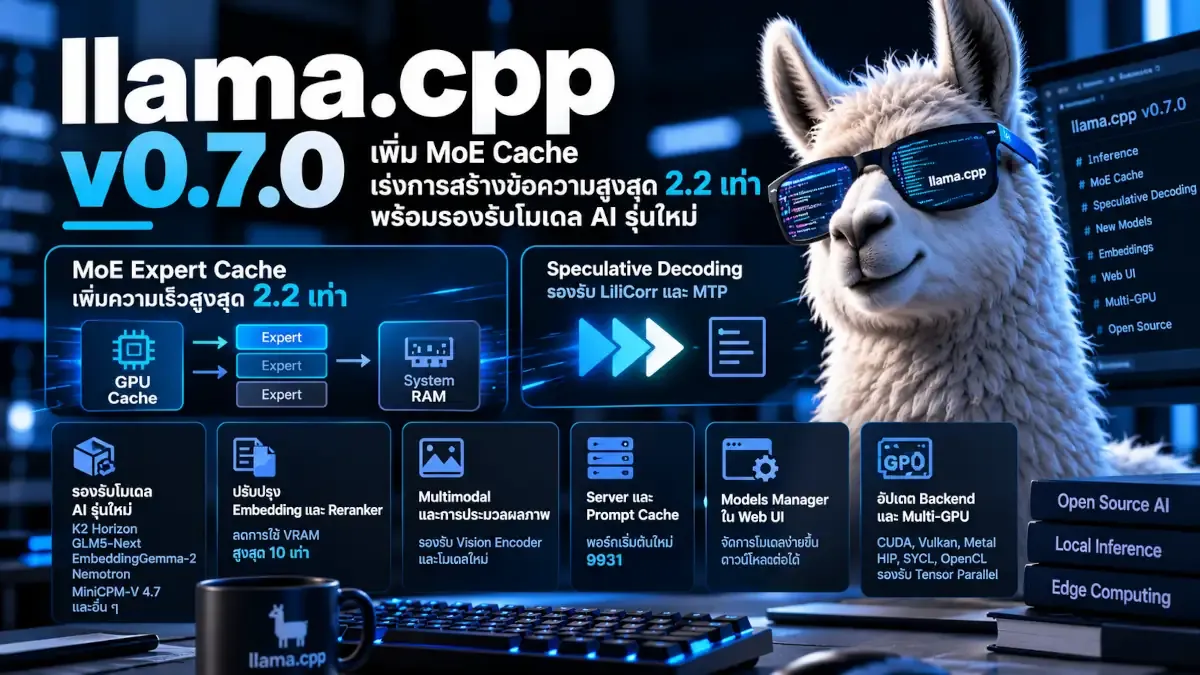
โครงการ llama.cpp เปิดตัวเวอร์ชัน 0.7.0 เมื่อวันที่ 15 ตุลาคม 2026 โดยเน้นปรับปรุงประสิทธิภาพการรัน LLM บน Local AI เพิ่มเทคนิคเร่งการสร้างข้อความ รองรับโมเดลรุ่นใหม่ และปรับปรุงระบบ Server สำหรับการให้บริการ AI ผ่าน API
จุดเปลี่ยนสำคัญอยู่ที่ MoE Expert Cache ซึ่งช่วยให้ GPU เรียกใช้ Expert ที่เก็บอยู่ในหน่วยความจำระบบได้ผ่านแคชบน GPU โดยโครงการรายงานว่าฟีเจอร์นี้สามารถเพิ่มความเร็วในการสร้างข้อความได้สูงสุดประมาณ 2.2 เท่าในกรณีที่ต้อง Offload Expert ไปยัง RAM นอกจากนี้ llama.cpp ยังปรับปรุง Speculative Decoding, ระบบจัดการ Prompt Cache และเพิ่มเครื่องมือจัดการโมเดลใน Web UI อีกด้วย
MoE Expert Cache ช่วยให้รันโมเดลใหญ่ได้มีประสิทธิภาพขึ้น
หัวข้อที่มีชื่อว่า “MoE Expert Cache ช่วยให้รันโมเดลใหญ่ได้มีประสิทธิภาพขึ้น”Mixture of Experts (MoE) เป็นสถาปัตยกรรมที่มี Expert หลายชุด แต่ละ Token จะเลือกใช้ Expert บางส่วนในการประมวลผล โมเดลประเภทนี้จึงอาจมีจำนวนพารามิเตอร์รวมสูงมาก แม้จะใช้พารามิเตอร์เพียงบางส่วนต่อ Token ก็ตาม
ปัญหาเกิดขึ้นเมื่อ VRAM ของ GPU ไม่เพียงพอเก็บ Expert ทั้งหมด ระบบต้องเก็บน้ำหนักโมเดลบางส่วนไว้ใน System RAM และเคลื่อนย้ายข้อมูลระหว่าง RAM กับ GPU ตามความจำเป็น ซึ่งอาจทำให้การสร้างข้อความช้าลง
llama.cpp v0.7.0 เพิ่มตัวเลือก --moe-cache-mib เพื่อกำหนดขนาดแคชสำหรับ Expert ที่อยู่ใน Host Memory โดยระบบจะใช้ GPU LRU Cache เก็บ Expert ที่ต้องเรียกใช้บ่อย และนำ Expert ออกจากแคชเมื่อจำเป็นต้องใช้พื้นที่ให้กับ Expert อื่น
โครงการรายงานว่าฟีเจอร์นี้ช่วยเพิ่มความเร็วในการสร้างข้อความได้สูงสุดประมาณ 2.2 เท่าในบางการตั้งค่า และยังรองรับการใช้ Expert Cache ร่วมกันระหว่าง GPU หลายตัวด้วย【อ้างอิง: GitHub Release v0.7.0】
คุณควรทดลองอย่างไร
หัวข้อที่มีชื่อว่า “คุณควรทดลองอย่างไร”หากคุณรันโมเดล MoE ที่มีขนาดใหญ่กว่า VRAM ของการ์ดจอ ให้ทดลองเปรียบเทียบการทำงานสองแบบ
- การทดสอบ A: รันโมเดลด้วยการตั้งค่าเดิม โดยไม่กำหนด MoE Cache
- การทดสอบ B: กำหนด
--moe-cache-mibแล้วทดลองปรับขนาดแคชหลายระดับ
ตัวอย่างคำสั่งสำหรับเริ่มทดสอบ โดยต้องตรวจสอบชื่อโมเดลและตัวเลือกอื่นให้ตรงกับระบบของคุณ
llama-cli \ -m /path/to/model.gguf \ -p "Explain how a mixture-of-experts model works." \ -n 256 \ --moe-cache-mib 2048ตัวอย่างนี้กำหนดแคชไว้ 2,048 MiB หรือประมาณ 2 GiB คุณสามารถเปลี่ยนค่านี้เพื่อทดสอบผลของขนาดแคชได้
ในการเปรียบเทียบ ให้บันทึก Token per second, เวลาที่ใช้สร้างข้อความ, VRAM ที่ใช้งาน และ System RAM ที่ใช้ โดยใช้โมเดล Prompt และจำนวน Token เท่ากันทุกครั้ง
ข้อสำคัญในการวิเคราะห์ผล: ค่า 2.2 เท่าเป็นผลสูงสุดที่โครงการรายงาน ไม่ใช่ค่าที่ทุก GPU หรือทุกโมเดลจะได้รับ การทดสอบควรแยก Prefill และ Decode ออกจากกัน เพราะ MoE Cache มุ่งแก้ปัญหาการเข้าถึง Expert ระหว่างประมวลผล และผลที่เห็นอาจแตกต่างตามลักษณะงาน
เพิ่มประสิทธิภาพ Speculative Decoding
หัวข้อที่มีชื่อว่า “เพิ่มประสิทธิภาพ Speculative Decoding”Speculative Decoding เป็นเทคนิคที่ใช้โมเดลร่าง (Draft Model) คาดการณ์ Token ล่วงหน้า จากนั้นโมเดลหลักตรวจสอบผลคาดการณ์ เพื่อลดเวลาที่ต้องใช้สร้างข้อความทีละ Token
llama.cpp v0.7.0 เพิ่มการรองรับเทคนิค LiliCorr และ Multi-Token Prediction (MTP) สำหรับ GLM5-Next พร้อมแก้ไขการจัดการ Draft Model และขั้นตอนตรวจสอบ Token ที่คาดการณ์
อีกหนึ่งตัวเลือกที่เพิ่มเข้ามาคือ --spec-draft-n-ubatch ซึ่งช่วยกำหนดขนาด Micro-batch ของ Draft Context แยกจากการตั้งค่าอื่น เพื่อลดการใช้ VRAM ในการทำ Speculative Decoding บางรูปแบบ
การปรับปรุงเหล่านี้มีประโยชน์กับผู้ที่ต้องการเร่ง Decode โดยเฉพาะเมื่อใช้โมเดลหลักที่สร้างข้อความได้ช้า อย่างไรก็ตาม ประสิทธิภาพขึ้นอยู่กับความเข้ากันได้ของ Draft Model, อัตราการยอมรับ Token และภาระงานของ GPU
หากคุณกำลังทดสอบ Local LLM ควรบันทึกทั้ง Token per second และคุณภาพของผลลัพธ์ ไม่ควรสรุปจากความเร็วเพียงอย่างเดียว เพราะการตั้งค่า Draft Model ที่ไม่เหมาะสมอาจไม่ช่วยให้ระบบเร็วขึ้น
เพิ่มการรองรับโมเดล AI รุ่นใหม่
หัวข้อที่มีชื่อว่า “เพิ่มการรองรับโมเดล AI รุ่นใหม่”เวอร์ชันนี้เพิ่มสถาปัตยกรรมและโมเดลหลายกลุ่ม ทั้งโมเดลภาษาทั่วไป โมเดล Multimodal โมเดล Embedding และโมเดลสำหรับตัดสินใจ
โมเดลและสถาปัตยกรรมที่น่าสนใจ ได้แก่
- K2 Horizon: รองรับทั้ง Dense และ MoVA พร้อมการแปลงโมเดลและการแบ่งการประมวลผลแบบ Tensor
- Prism Bonsai 2 27B: เพิ่มการรองรับโมเดลแบบ Ternary
- EmbeddingGemma-2: รองรับ Embedding จากข้อความ ภาพ และเสียง
- LiquidAI d1 และ d1-omni: เพิ่มโมเดลในกลุ่ม Decision Model
- vLLM Decision 2, vLLM d3 และ pplx-decider: เพิ่มการรองรับโมเดลสำหรับงานตัดสินใจ
- MiniCPM-V 4.7: เพิ่มโมเดล Multimodal สำหรับประมวลผลข้อมูลภาพและข้อความ
- Nemotron Super 3.5 VL และ Nemotron Bolt 74B A9B: เพิ่มการรองรับโมเดลตระกูล Nemotron รุ่นใหม่
- maion-coder: เพิ่มการรองรับสถาปัตยกรรมโมเดลสำหรับงานเขียนโค้ด
การเพิ่มรายชื่อโมเดลไม่ได้หมายความว่าทุกโมเดลจะทำงานได้ดีที่สุดบนทุก Backend คุณควรตรวจสอบไฟล์โมเดล รูปแบบ Quantization, Chat Template และ Backend ที่ใช้ ก่อนนำไปทดสอบจริง【อ้างอิง: GitHub Release v0.7.0】
ปรับปรุง Embedding และ Reranker
หัวข้อที่มีชื่อว่า “ปรับปรุง Embedding และ Reranker”llama.cpp ปรับปรุงเส้นทางการประมวลผล Embedding โดยหลีกเลี่ยงการสร้าง Logits Buffer และการคำนวณ Language Model Head ในกรณีที่ไม่จำเป็น เมื่อใช้ Pooling ที่เหมาะสม โครงการระบุว่าการปรับปรุงนี้สามารถลดการใช้ VRAM ได้สูงสุดถึง 10 เท่าในบางกรณี
การเปลี่ยนแปลงนี้สำคัญกับระบบ Retrieval-Augmented Generation (RAG) ที่ต้องสร้าง Embedding จากเอกสารจำนวนมาก เพราะการใช้หน่วยความจำลดลงอาจช่วยให้ประมวลผลข้อมูลได้สะดวกขึ้น
นอกจากนี้ ยังมีการปรับปรุงการรองรับ Reranker และแก้ไขการทำงานของ ModernBERT Encoder ให้ใช้ Exact GELU ตามที่โมเดลกำหนด
หากคุณพัฒนา RAG ด้วย Local AI ควรทดสอบ Embedding และ Reranker แยกจากการสร้างข้อความ โดยวัดจำนวนเอกสารต่อวินาที การใช้ VRAM และคุณภาพของผลการค้นคืน เพื่อดูว่าการอัปเดตส่งผลต่อระบบของคุณจริงเพียงใด
ปรับปรุง Multimodal และการประมวลผลภาพ
หัวข้อที่มีชื่อว่า “ปรับปรุง Multimodal และการประมวลผลภาพ”llama.cpp v0.7.0 เพิ่มการรองรับ Cohere2 Vision Encoder และปรับปรุงเส้นทาง Multimodal ให้ทำงานร่วมกับ Speculative Decoding ได้ดีขึ้น
อีกจุดที่น่าสนใจคือการรองรับ Image Embeddings สำหรับ Qwen3.8 Flash Next ในเส้นทาง MTP รวมถึงการเพิ่มโมเดล Multimodal รุ่นใหม่หลายรายการ
ผู้ที่ทดสอบโมเดลซึ่งรับทั้งภาพและข้อความควรตรวจสอบส่วนประกอบทั้งหมดของระบบ ไม่ว่าจะเป็นไฟล์โมเดลหลัก ตัวประมวลผลภาพ รูปแบบอินพุต และ Backend ที่รองรับ เพราะความสามารถในการโหลดโมเดลได้ไม่ได้รับประกันว่าทุกเส้นทางประมวลผลจะมีประสิทธิภาพเท่ากัน
6. ปรับปรุง Server และ Prompt Cache
หัวข้อที่มีชื่อว่า “6. ปรับปรุง Server และ Prompt Cache”llama.cpp ปรับโครงสร้างระบบ Chat Session ใหม่ โดยใช้ common_chat_session และเปลี่ยนรูปแบบผลลัพธ์ Chat ที่ผ่านการจัดรูปแบบให้แสดงเป็น Array ของ Parts แทน String เดียว
ระบบ Prompt Cache ยังปรับปรุงการบันทึกและกู้คืนสถานะของ Slot เพื่อหลีกเลี่ยงการเก็บสถานะที่ไม่สามารถกู้คืนได้ รวมถึงรักษาสถานะของงานที่ทำงานร่วมกันได้ดีขึ้น
สำหรับผู้ที่ใช้ llama.cpp เป็น Local AI Server การเปลี่ยนแปลงเหล่านี้อาจช่วยให้การจัดการคำขอหลายรายการและการนำสถานะเดิมกลับมาใช้มีประสิทธิภาพขึ้น โดยเฉพาะระบบที่ใช้ Prompt ซ้ำหรือมีหลาย Session
เปลี่ยนพอร์ตเริ่มต้นของ Server
หัวข้อที่มีชื่อว่า “เปลี่ยนพอร์ตเริ่มต้นของ Server”การเปลี่ยนแปลงที่ผู้ใช้ควรทราบทันทีคือ llama-server เปลี่ยนพอร์ตเริ่มต้นจาก 8080 เป็น 9931 ส่วน Docker Image ยังคงใช้พอร์ต 8080 ภายใน Container ตามที่ Release ระบุ
หากคุณมี Agent, Web UI หรือสคริปต์ที่เชื่อมต่อกับ http://localhost:8080 โดยตรง คุณควรตรวจสอบการตั้งค่าก่อนอัปเดต เพราะโปรแกรมที่เรียกใช้พอร์ตเดิมอาจเชื่อมต่อไม่ได้หลังเปลี่ยนเวอร์ชัน
7. เพิ่ม Models Manager ใน Web UI
หัวข้อที่มีชื่อว่า “7. เพิ่ม Models Manager ใน Web UI”Web UI เพิ่ม Models Manager สำหรับจัดการโมเดลในหน้าจอเดียว โดยมีความสามารถหลักดังนี้
- ค้นหา กรอง และเรียงลำดับโมเดล
- ดูตัวเลือก Quantization และข้อมูลโมเดล
- โหลดหรือ Unload โมเดล
- ลบไฟล์โมเดลออกจากดิสก์
- ซ่อนหรือแสดงโมเดล
- ดาวน์โหลดโมเดลต่อจากจุดที่หยุดไว้ พร้อมแสดงความคืบหน้า
- เปิดแผงตั้งค่าโมเดลและเลือก Chat Template
การเปลี่ยนแปลงนี้ช่วยลดขั้นตอนการจัดการโมเดลสำหรับผู้ที่ใช้ Web UI ของ llama.cpp เป็นประจำ อย่างไรก็ตาม ความสามารถดังกล่าวเป็นส่วนหนึ่งของ UI ที่โครงการจัดเตรียมไว้ ไม่ควรสรุปว่าโปรแกรมภายนอกที่เชื่อมต่อผ่าน API จะมีหน้าจอจัดการแบบเดียวกันโดยอัตโนมัติ
8. ปรับปรุง Backend และการทำงานหลาย GPU
หัวข้อที่มีชื่อว่า “8. ปรับปรุง Backend และการทำงานหลาย GPU”เวอร์ชันนี้อัปเดต ggml เป็น v0.27.0 พร้อมปรับปรุง Kernel และการจัดตารางงานในหลาย Backend เช่น CUDA, HIP, Vulkan, SYCL, OpenCL และ Metal
การเปลี่ยนแปลงครอบคลุมการประมวลผล MoE, Matrix Multiplication, Flash Attention และการจัดการหน่วยความจำ นอกจากนี้ RPC ยังอัปเดตเป็น Protocol v8 และเพิ่มการรองรับ Tensor Parallel ผ่าน RPC Server
สำหรับผู้ที่ใช้ GPU หลายตัว จุดนี้มีความสำคัญต่อการทดลองกระจายงานระหว่างอุปกรณ์ แต่ประสิทธิภาพจริงยังขึ้นอยู่กับ Backend, การเชื่อมต่อระหว่าง GPU, PCIe Bandwidth และวิธีแบ่ง Tensor หรือ Layer ของโมเดล
คุณควรทดสอบทั้งการใช้ GPU ตัวเดียว การแบ่ง Layer และ Tensor Parallel แยกกัน พร้อมบันทึก VRAM ของแต่ละการ์ดและความเร็ว Decode เพื่อหาการตั้งค่าที่เหมาะกับระบบจริง
แนวทางทดสอบ llama.cpp v0.7.0 สำหรับ Local AI
หัวข้อที่มีชื่อว่า “แนวทางทดสอบ llama.cpp v0.7.0 สำหรับ Local AI”หากคุณต้องการตรวจสอบว่าการอัปเดตนี้ช่วยระบบของคุณจริงหรือไม่ ควรเริ่มจากการทดสอบที่ควบคุมตัวแปรได้
- เลือกโมเดล GGUF ที่คุณใช้งานอยู่ และเก็บไฟล์เดิมไว้สำหรับเปรียบเทียบ
- บันทึกเวอร์ชัน llama.cpp, Backend, Driver, Quantization และพารามิเตอร์ที่ใช้
- ใช้ Prompt เดิมและจำนวน Token ที่สร้างเท่ากัน
- วัด Prompt Processing และ Token Generation แยกกัน
- ทดสอบ MoE Cache เฉพาะโมเดลที่ใช้ MoE และมีการ Offload Expert ไปยัง RAM
- ทดสอบ Speculative Decoding แยกจาก MoE Cache เพื่อระบุว่าฟีเจอร์ใดให้ผลต่างกัน
- ทดสอบ Server ด้วยคำขอซ้ำและหลาย Session หากคุณใช้ Local AI ผ่าน API
- ทำซ้ำหลายรอบและใช้ค่ามัธยฐานในการเปรียบเทียบ เพื่อลดผลจากความผันผวนของระบบ
ควรบันทึก Token per second, เวลาตอบสนอง, VRAM, System RAM และอุณหภูมิ GPU เพื่อให้ผลทดสอบนำไปเปรียบเทียบข้ามเวอร์ชันหรือข้ามเครื่องได้
llama.cpp v0.7.0 มุ่งแก้ปัญหาสำคัญของการรัน Local AI ตั้งแต่การจัดการ Expert ของโมเดล MoE การเร่ง Decode ด้วย Speculative Decoding การลดการใช้ VRAM ของ Embedding ไปจนถึงการจัดการ Server และโมเดลผ่าน Web UI
ฟีเจอร์ที่ควรทดลองเป็นอันดับแรกขึ้นอยู่กับลักษณะงานของคุณ หากคุณรัน MoE ที่ใหญ่กว่า VRAM ให้เริ่มจาก --moe-cache-mib หากต้องการเพิ่มความเร็วการสร้างข้อความ ให้ทดลอง Speculative Decoding ส่วนผู้พัฒนา RAG ควรตรวจสอบประสิทธิภาพ Embedding และ Reranker
การอัปเดตครั้งนี้มีประโยชน์ต่อการทดสอบ Local AI หลายรูปแบบ แต่คุณควรใช้ Benchmark บนฮาร์ดแวร์และโมเดลของตัวเองก่อนสรุปว่าเวอร์ชันใหม่เร็วขึ้นมากเพียงใด
แหล่งข้อมูล: llama.cpp v0.7.0 Release Notes บน GitHub