จับเครื่องเล่นเกมพกพา MSI Claw 8 EX AI+ มารัน Chatbot โดยใช้ CPU, GPU และ NPU ระดับ 46 TOPs: มาดูกันว่าทำงานได้ขนาดไหน
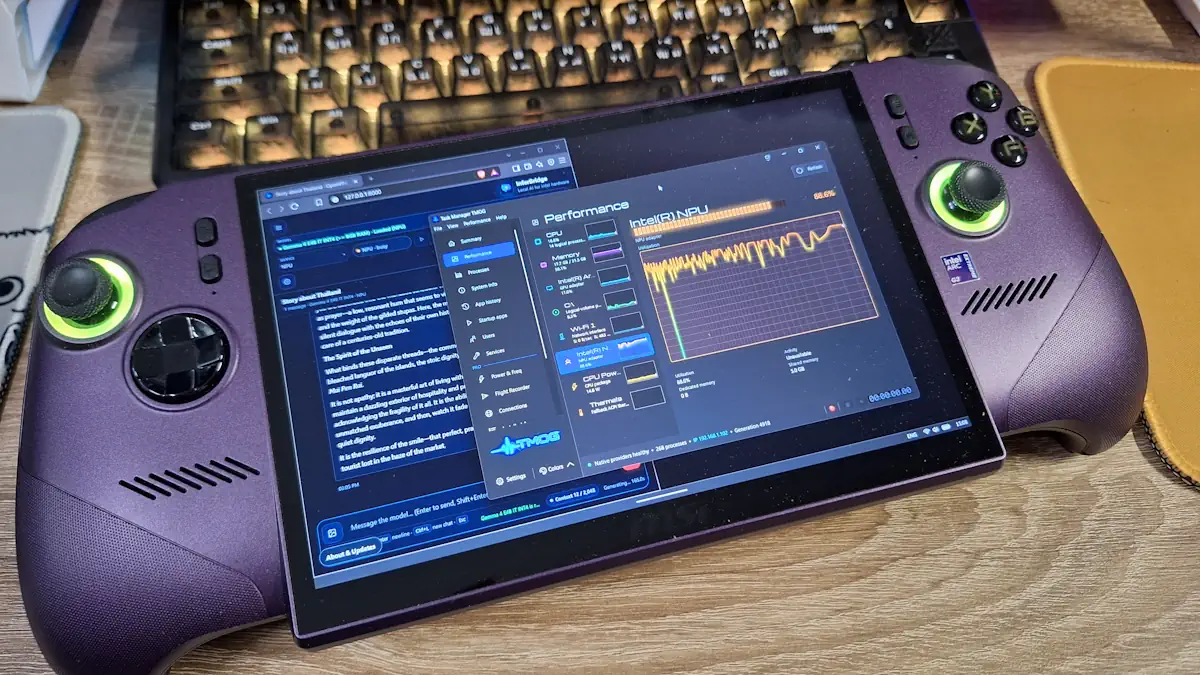
ครั้งนี้ผมนำเครื่องเล่นเกมพกพา MSI Claw 8 EX AI+ มาลองในมุมที่ต่างจากการเล่นเกม คือใช้เป็นเครื่องทดสอบ Local LLM และลองดูว่า NPU ที่อยู่ในชิป Intel Arc G3 Extreme รุ่นใหม่ของอินเทลจะสามารถช่วยงานด้าน LLM ได้มากน้อยแค่ไหน
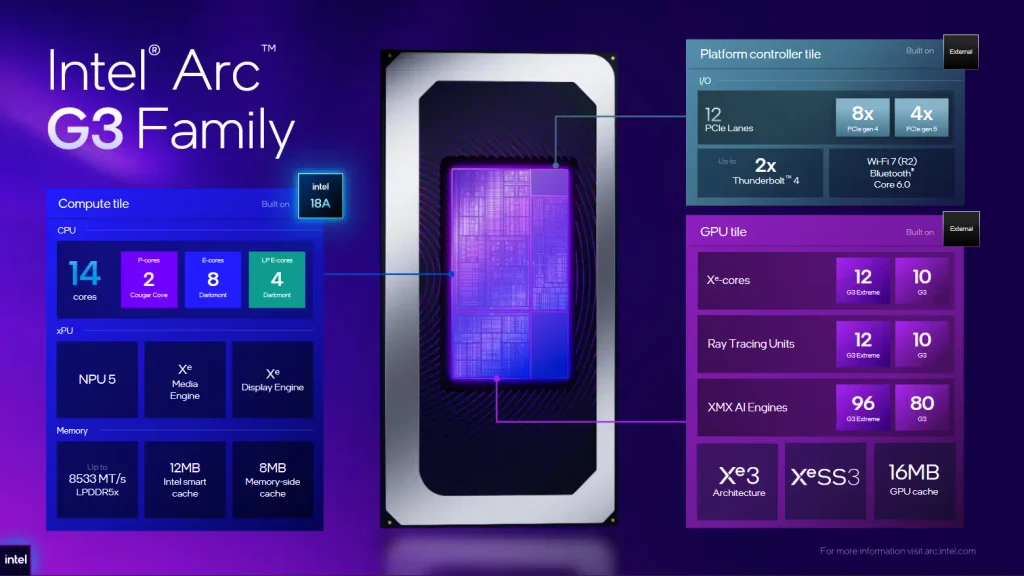
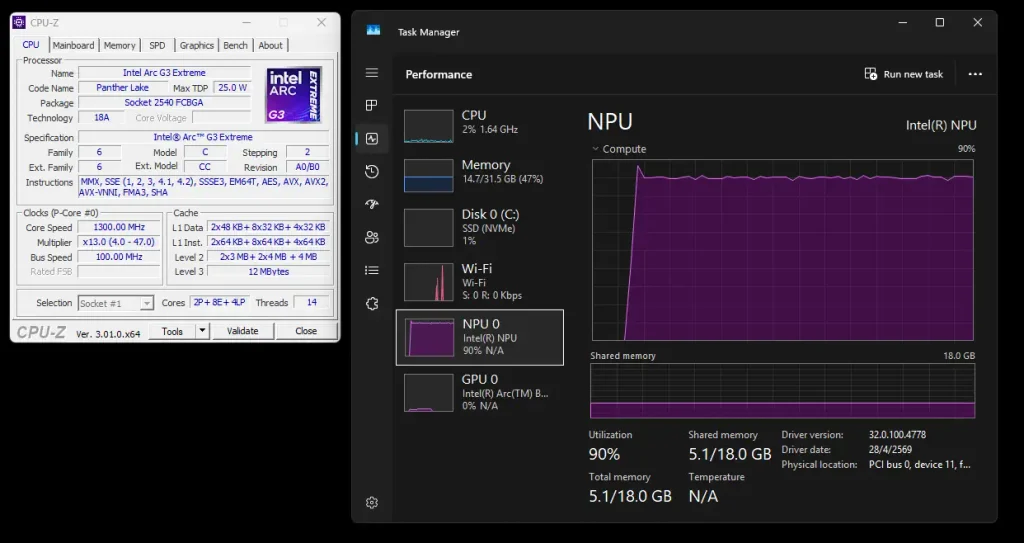
เครื่องเล่นเกมพกพา MSI Claw 8 EX AI+ มาพร้อมกับชิปประมวลผลแบบ SoC รุ่นใหม่ของอินเทลคือ Intel Arc G3 Extreme ที่ประกอบไปด้วยซีพียูจำนวน 14 คอร์ 14 เธรด (Panther Lake) แบ่งเป็น 2 P-Core, 8 E-Core และ 4 LP E-Core ส่วนกราฟิกหรือ GPU ก็จะเป็น Arc B390 ซึ่งได้ชื่อว่าเป็น iGPU ที่แรงที่สุดของอินเทลในเวลานี้ และยังมี Intel AI Boost NPU 5010 ประสิทธิภาพ INT8 ที่ 46 TOPs ซึ่งมากว่าพวก NPU ในซีพียูรุ่นก่อนราว ๆ สามเท่า และเครื่องนี้ก็มาพร้อมกับ RAM DDR5 32GB (8533MT/s) ซึ่งถือว่าเป็นแรมที่เร็วกว่าเดสก์ท็อปที่ผมใช้อยู่ด้วยซ้ำ, Windows 11 (build 26200)
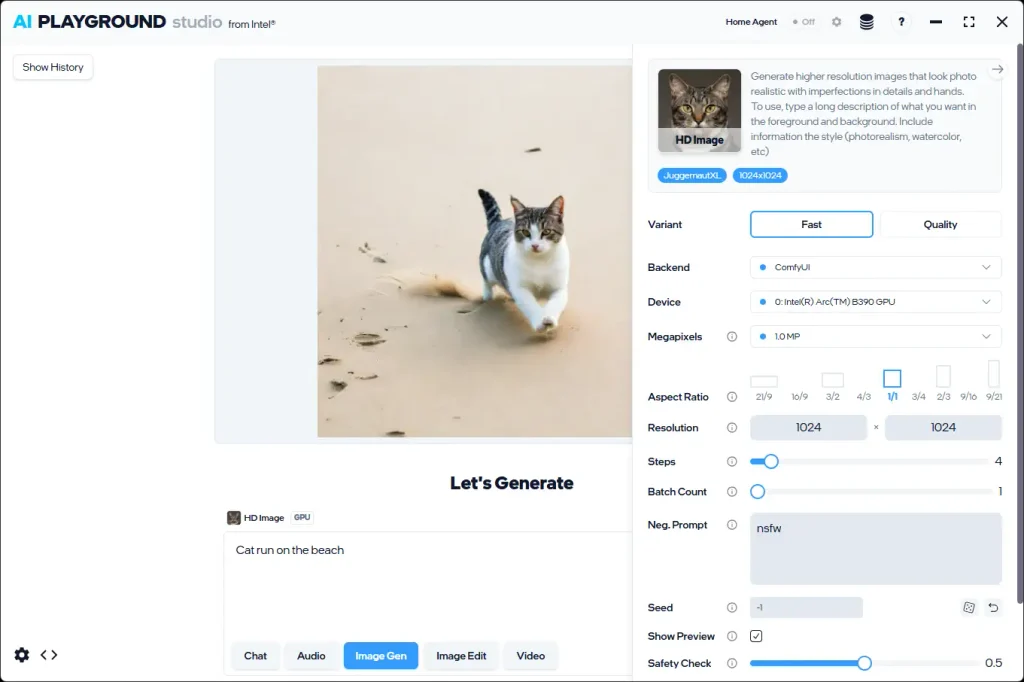
สำหรับใครที่มีเครื่องเล่นเกมรุ่นนี้ก็สามารถดาวน์โหลดเครื่องมือด้าน AI ของอินเทลอย่าง AI Playground ที่ทำงานได้หลายอย่างทั้งทำ Chatbot, เจนรูป, แปลงเสียงเป็นข้อความ, แก้ไขรูป และอื่น ๆ มาลองใช้งานได้นะครับ ก็สนุกดี เอาไว้ศึกษาเบื้องต้นได้ครับ
ส่วนการทดสอบของเรานั้นเราใช้เครื่องมือที่ชื่อว่า InferBridge ซึ่งออกแบบมาให้ทำงานด้าน LLM บนฮาร์ดแวร์ของอินเทลโดยเฉพาะ เหตุผลสำคัญที่เลือก InferBridge คือมันเปิดโอกาสให้กำหนดได้ว่าเราต้องการส่งโมเดลไปทำงานที่ใด เช่น GPU, CPU, NPU รวมถึงโหมด AUTO และ HETERO* จึงเหมาะกับการทดลองว่าอุปกรณ์แต่ละส่วนในเครื่องเดียวกันมีพฤติกรรมต่างกันอย่างไร
(*HETERO ย่อมาจาก Heterogeneous Computing หรือ Heterogeneous Architecture หมายถึง ระบบการประมวลผลที่ใช้หน่วยประมวลผลต่างชนิดกันมาทำงานร่วมกัน เพื่อให้เกิดประสิทธิภาพสูงสุด)
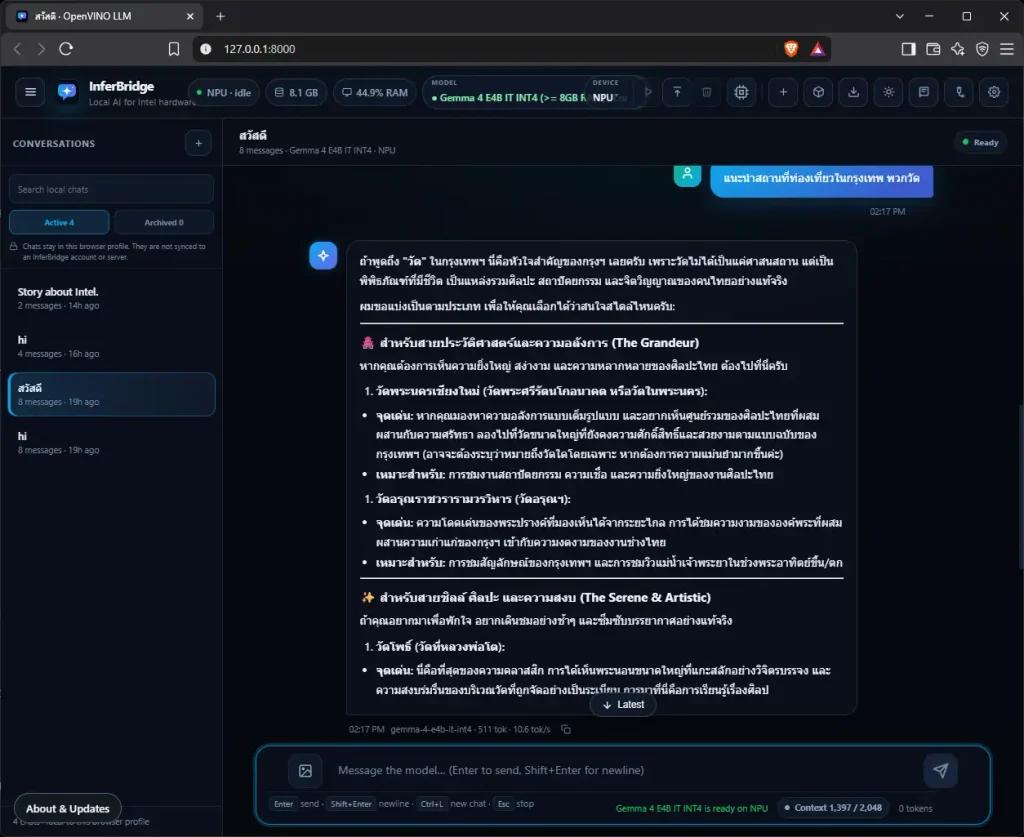
สำหรับโมเดลที่ใช้ทดสอบในครั้งนี้ก็คือ gemma-4-E4B-it ของ Google ซึ่งถูกแปลงเป็น OpenVINO IR INT4 และรันผ่าน InferBridge v0.9.6 ที่ใช้ OpenVINO GenAI 2026.3.1 ทำหน้าที่เป็น Inference engine อยู่เบื้องหลัง
ทดสอบอะไรบ้าง
การทดสอบของเราไม่ได้แชทผ่านทางอินเทอร์เฟซของ InferBridge นะครับ แต่เป็นการทดสอบผ่านทาง API
การทดสอบไม่ได้ดูเพียงจำนวน token ต่อวินาทีเท่านั้น แต่ดูพฤติกรรมการทำงานสองช่วงหลักของ LLM ได้แก่ Prefill เพื่อดู TTFT และช่วง Decode เพื่อดู Token generation
TTFT หรือ Time To First Token คือเวลาตั้งแต่ส่งคำถามเข้าไปจนกระทั่งโมเดลเริ่มตอบ token แรกออกมา ยิ่งต่ำ ผู้ใช้ก็จะยิ่งรู้สึกว่าโมเดลตอบสนองเร็ว
ส่วน Decode speed คือความเร็วหลังจากโมเดลเริ่มตอบแล้ว ว่าสามารถสร้างข้อความต่อเนื่องได้กี่ token ต่อวินาที
อีกส่วนที่สำคัญเมื่อ prompt เริ่มยาวคือ Prefill ซึ่งเป็นช่วงที่โมเดลต้องประมวลผลข้อมูล input ทั้งหมดก่อนเริ่มสร้างคำตอบ
เพื่อไม่ให้ผลจากการเริ่มต้นระบบรบกวนการวัด ผมทิ้งรอบแรกเป็น warm-up ทุกครั้ง แล้วทดสอบจริงอีก 5 รอบ ก่อนใช้ค่ามัธยฐานหรือ median เป็นตัวแทนของผลทดสอบ
เหตุผลที่ต้องทำแบบนี้คือการทดสอบครั้งแรกหลังจากโหลดโมเดลเข้าหน่วยความจำ แล้วใช่้งานทันทีมักจะช้ากว่ารอบหลังอย่างเห็นได้ชัดบนทุกอุปกรณ์ ดังนั้นหากวัดเพียงครั้งเดียวตัวเลขที่ได้ก็จะไม่ตรงกับประสิทธิภาพจริง
การทดสอบงานสั้น
เริ่มจาก prompt ขนาด 84 tokens และให้โมเดลสร้างคำตอบ 128 tokens
| อุปกรณ์ | TTFT | Decode |
|---|---|---|
| GPU | 181 ms | 32.5 tok/s |
| AUTO,CPU | 167 ms | 32.6 tok/s |
| HETERO,CPU | 186 ms | 31.8 tok/s |
| CPU | 429 ms | 20.0 tok/s |
| NPU | 1,614 ms | 6.2 tok/s |
สิ่งที่เห็นค่อนข้างชัดคือ GPU และ AUTO,CPU ให้ผลใกล้กันมาก โดยมีความเร็วในการสร้างข้อความประมาณ 32 token ต่อวินาที
CPU ช้าลงมาเหลือประมาณ 20 token ต่อวินาที แต่ยังอยู่ในระดับที่สามารถใช้สนทนาได้
ส่วน NPU แตกต่างออกไปอย่างชัดเจน ทั้งเวลารอ token แรกที่เพิ่มขึ้นเป็นประมาณ 1.6 วินาที และความเร็วในการสร้างข้อความประมาณ 6.2 token ต่อวินาที
ดังนั้น หากมองเฉพาะการใช้งานแชตแบบ interactive ที่ต้องการให้ระบบตอบทันที GPU ยังได้เปรียบมาก
เมื่อให้โมเดลตอบยาวขึ้น
การทดสอบถัดมาใช้ prompt เพียง 19 tokens แต่ให้โมเดลเขียนข้อความยาวประมาณ 700 tokens
| อุปกรณ์ | TTFT | Decode |
|---|---|---|
| AUTO,CPU | 162 ms | 31.2 tok/s |
| GPU | 176 ms | 30.8 tok/s |
| HETERO,CPU | 177 ms | 29.6 tok/s |
| CPU | 440 ms | 18.4 tok/s |
| NPU | 1,582 ms | 6.8 tok/s |
แนวโน้มยังเหมือนเดิม GPU และ AUTO อยู่ประมาณ 30 token ต่อวินาที ขณะที่ CPU อยู่ราว 18 token ต่อวินาที และ NPU อยู่ราว 6-7 token ต่อวินาที
NPU ขยับจาก 6.2 เป็น 6.8 token ต่อวินาที แต่ไม่ได้หมายความว่า NPU เร็วขึ้นเพราะงานยาวกว่าโดยตรง สิ่งที่เกิดขึ้นคือเวลารอเริ่มต้นประมาณ 1.6 วินาทีมีสัดส่วนต่อเวลาทั้งหมดลดลงเมื่อเราให้โมเดลสร้างข้อความยาวขึ้น
จุดที่เห็นความแตกต่างชัดที่สุด: Prompt ยาว
การทดสอบที่น่าสนใจกว่าคือการใช้ prompt ขนาด 1,793 tokens ซึ่งเป็นงานลักษณะ code review แล้วให้โมเดลสร้างคำตอบ 256 tokens
| DEVICE | PREFILL | DECODE | TTFT | เวลารวม |
|---|---|---|---|---|
| AUTO,CPU | 7,889 tok/s | 30.7 tok/s | 0.23 s | 8.6 s |
| GPU | 7,349 tok/s | 30.7 tok/s | 0.24 s | 8.6 s |
| CPU | 4,458 tok/s | 16.5 tok/s | 0.40 s | 15.9 s |
| HETERO,CPU | 2,686 tok/s | 27.0 tok/s | 0.67 s | 10.2 s |
| NPU | 614 tok/s | 7.8 tok/s | 2.92 s | 35.6 s |
ตารางนี้ทำให้เห็นข้อจำกัดของ NPU ชัดกว่าการทดสอบก่อนหน้า
ปัญหาหลักไม่ได้อยู่แค่ตอนสร้างข้อความ แต่เกิดขึ้นตั้งแต่ช่วง Prefill
GPU สามารถประมวลผล prompt ได้มากกว่า 7,000 token ต่อวินาที ขณะที่ NPU ทำได้ 614 token ต่อวินาที หรือแตกต่างกันประมาณ 12 เท่า
ผลที่ตามมาคือ prompt ยิ่งยาว ผู้ใช้ก็ยิ่งต้องรอนานกว่าที่ NPU จะเริ่มสร้างคำตอบ
ในกรณีนี้ NPU มี TTFT 2.92 วินาที ขณะที่ GPU อยู่เพียงประมาณ 0.24 วินาที
ส่วนความเร็วในช่วง Decode ของ NPU อยู่ที่ 7.8 token ต่อวินาที ซึ่งไม่ได้แตกต่างจาก GPU รุนแรงเท่าช่วง Prefill
ดังนั้น ข้อจำกัดสำคัญของ NPU ในการทดลองนี้คือ การรับมือกับ input หรือ context ขนาดใหญ่ มากกว่าการสร้าง token เพียงอย่างเดียว
AUTO กลับเป็นโหมดที่น่าสนใจที่สุด
ในการทดสอบหลายชุด AUTO:GPU,CPU ให้ผลใกล้เคียงหรือบางครั้งดีกว่าการบังคับใช้ GPU โดยตรงเล็กน้อย
แนวคิดของโหมด AUTO คือปล่อยให้ OpenVINO เลือกอุปกรณ์ที่เหมาะสมแทนที่จะกำหนดทุกอย่างด้วยตัวเอง
จากผลที่ได้ AUTO,CPU จึงดูเป็นตัวเลือกที่สมเหตุสมผลสำหรับการใช้งานทั่วไป เพราะไม่ต้องพยายามบังคับแบ่งงานเอง และผลที่ได้ก็อยู่ในกลุ่มที่เร็วที่สุดอย่างสม่ำเสมอ
โหมด HETERO ช่วยไหม
HETERO,CPU เป็นอีกแนวคิดหนึ่ง โดยพยายามแบ่งส่วนของโมเดลให้ GPU และ CPU ช่วยกันทำงาน
แต่จากการทดลองครั้งนี้ ผลไม่ได้ออกมาว่าการมีอุปกรณ์สองตัวทำงานร่วมกันจะต้องเร็วกว่าเสมอ
บางรอบ HETERO ทำได้ดี บางรอบใกล้เคียง GPU และบาง workload กลับช้ากว่า
ในการทดสอบ prompt 1,793 tokens HETERO มี Prefill เพียง 2,686 token ต่อวินาที เทียบกับ GPU ที่ 7,349 token ต่อวินาที
นอกจากนี้ การเริ่มระบบยังใช้เวลาประมาณ 25 วินาที เพราะต้อง compile สำหรับอุปกรณ์สองชนิด
ดังนั้นจึงไม่สามารถตีความได้ว่า CPU + GPU จะให้ประสิทธิภาพเพิ่มขึ้นโดยอัตโนมัติ การส่ง activation ระหว่างอุปกรณ์ก็มีต้นทุนของมันเอง เท่าที่ผมทดสอบเพิ่มเติมมันเหมือนกับต้องดูด้วยว่าในจังหวะนั้น CPU มีการรันงานอื่น ๆ อยู่ด้วยหรือไม่ ในขณะที่ตอบทดสอบเราปิดโปรแกรมทำงานทุกอย่างเพื่อเปิดทางในการทดสอบอย่างเดียว ดังนั้นการใช้งานจริงผลก็อาจจะเปลี่ยนไป
CPU ก็มีเรื่องน่าสนใจ
ในข้อมูลของ OpenVINO ระบบสามารถรายงานช่วงการทำงานได้ถึง 14 คอร์ (14 เธรด) แต่เมื่อตรวจจาก Task Manager พบว่าขณะ inference มีการใช้งานจริงประมาณ 10 คอร์
ผมจึงทดลองบังคับจำนวน thread เพิ่มเติมโดยตรง
เมื่อใช้ 10 threads ได้ TTFT 0.30 วินาที และงานจบใน 1.88 วินาทีอย่างสม่ำเสมอ
แต่เมื่อบังคับเป็น 14 threads ตามจำนวนคอร์จริงที่มี TTFT เพิ่มเป็น 0.33 วินาที และใช้เวลารวม 2.17 วินาที หรือช้าลงประมาณ 15%
ผลนี้แสดงให้เห็นว่าการใช้ทุกคอร์ไม่ได้หมายความว่าจะเร็วกว่าเสมอไปครับ โดยเฉพาะกับสถาปัตยกรรมของซีพียูรุ่นใหม่ ๆ อย่างตระกูล Panther Lake ของอินเทล อย่างในรุ่นนี้มี 2 P-Core, 8 E-Core และ 4 LP E-Core มันค่อนข้างชัดเจนว่าตัวจัดการตารางงานของ CPU นั้นจะไม่ส่งงานที่ต้องการพลังในการประมวลผลสูง ๆ มาให้ LP E-Core ทั้ง 4 ตัว เพราะเก็บไว้ให้งานที่ทำแบบฉากหลังมากกว่า และการทำงานของ LP E-Core ที่ช้ากว่ามาก มันสามารถไปหน่วง เพราะงานทั้งหมดต้องรอจากคอร์ที่ประมวลผลได้ค่อนข้างช้า
ซึ่งในกรณีนี้ค่าที่ซอฟต์แวร์ OpenVINO และตัวจัดการตารางงานในซีพียูที่เลือกไว้โดยอัตโนมัติจึงเหมาะสมกว่า
NPU ไม่ได้ไร้ประโยชน์ เพียงแต่เหมาะกับงานคนละแบบ
หากดูเฉพาะตัวเลข LLM จากการทดสอบ ก็อาจจะสรุปได้ง่ายว่า NPU นั้นไม่เหมาะกับ LLM ทั้งนี้ก็ไม่ได้หมายความว่า NPU จะไม่มีประโยชน์
แต่เราต้องเข้าใจก่อนว่า NPU ถูกออกแบบมาเพื่อมีบทบาทต่างจาก GPU และ CPU อย่างชัดเจน
จากการทดสอบนี้ NPU ไม่เหมาะกับงานที่มี context ยาวมาก หรือ workload ที่ต้องการตอบสนองเร็ว เช่น การป้อนเอกสารยาว ๆ แล้วถามคำถาม หรือใช้ LLM แบบที่ต้องโต้ตอบกันหนัก ๆ
ถ้าเราย้อนไปดูการทำงานจริงของแอปพลิเคชันจำนวนมากที่บอกว่ารองรับ AI ในตัวและมีการเรียกใช้ NPU ด้วยนั้น มันมักจะเป็นงานย่อย เช่นการแก้ไขภาพเฉพาะจุด ลบของ ลบคนออกจากรูป แบบนี้ NPU ถนัดมาก หรืองานที่ต้องแบ่งเป็นชิ้นเล็ก ๆ เช่นงานวิเคราะห์รูป ซึ่งงานพวกนี้มันจะถูกแบ่งเป็นงานเล็ก ๆ อย่างต่อเนื่องและส่งมาให้ NPU ประมวลผล ซึ่งทำได้เร็วและประหยัดพลังงานมาก
หรือถ้าอยากจะรัน LLM จริง ๆ ก็ต้องเลือกโมเดลที่มีขนาดเล็กในระดับ 1-2B ซึ่งจะเหมาะกว่า และมันจะเป็นโมเดลที่ทำหน้าที่เฉพาะทางอยู่เบื้องหลัง นี่อาจเป็นประโยชน์จริงของการมี CPU + GPU + NPU อยู่ในเครื่อง AI PC เครื่องเดียว
สรุปจากการทดลองครั้งนี้
สุดท้ายนี้ผมก็คิดว่าการทดสอบนี้ก็น่าจะช่วยคลายของสงสัยของใครหลายคนรวมถึงตัวผมเองด้วยว่า NPU ระดับ 40-50 TOPs มันสามารถเอามาใช้งานด้าน LLM ได้แค่ไหน
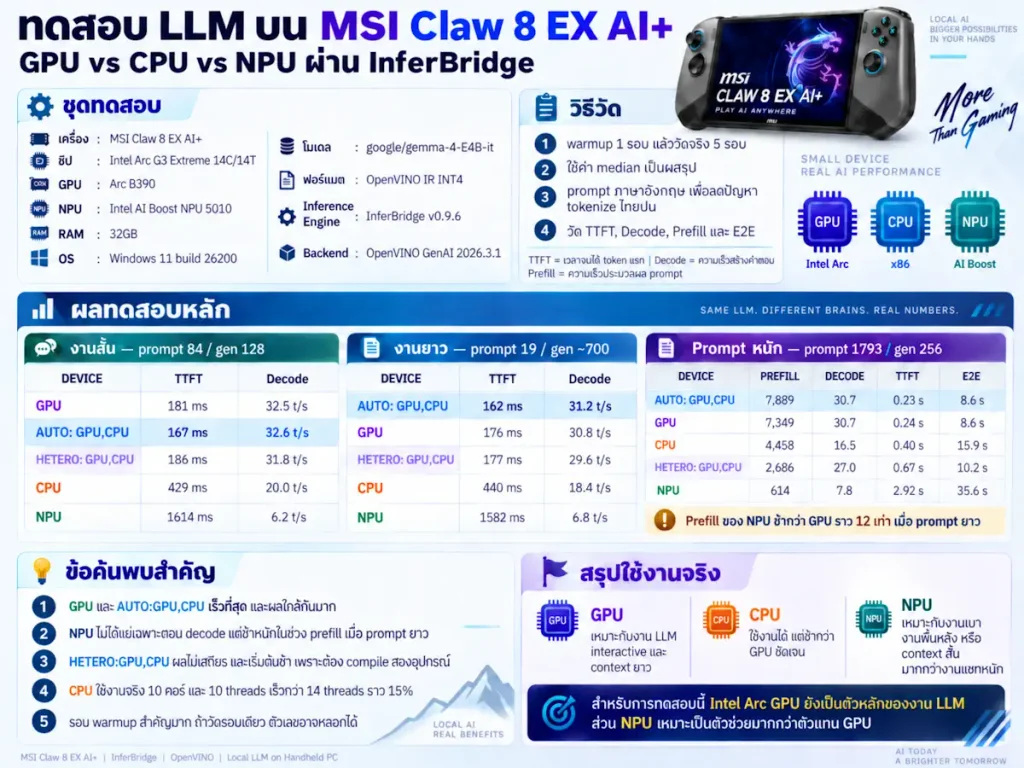
ในการทดสอบครั้งนี้พบว่า GPU ในชิป Intel Arc G3 Extreme ยังเป็นหน่วยประมวลผลหลักที่เหมาะกับ LLM แบบที่ใช้งานจริงได้มากที่สุด ทั้งด้านเวลาตอบสนอง ความเร็วในการประมวลผล prompt และความเร็วในการสร้างข้อความ
CPU แม้จะช้ากว่า GPU แต่ยังสามารถรันโมเดลได้ในระดับที่ใช้งานได้ และน่าสนใจตรงที่ระบบเลือกใช้เฉพาะคอร์ที่เหมาะสมแทนที่จะพยายามใช้ทุกคอร์
ส่วน NPU มีจุดอ่อนชัดเจนเมื่อเจอ prompt หรือ context ยาว เพราะ Prefill ช้ามากเมื่อเทียบกับ GPU ดังนั้นสิ่งที่จะทำให้ NPU ใช้ประโยชน์ได้จริงผมคิดว่ามันน่าจะเหมาะกับการทำงานแบบนี้ครับ เราส่งรูปและเขียนพร้อมถามไปว่าจงวิเคราะห์รูปนี้ ก็สามารถแตกงานได้สองทางโดยให้ CPU ทำหน้าที่ร่วมกับ NPU ก่อนแล้วจากนั้นก็ส่งให้ GPU ทำการประมวลผล ซึ่งมันจะช่วยลดเวลาและขั้นตอนลงได้ แต่ก็ขึ้นอยู่กับทางผู้พัฒนาแอปพลิเคชันด้วยว่าจะมีการวางเวิร์คโฟลว์อย่างไร
การทดลองนี้ก็ทำให้เห็นอีกมุมหนึ่งว่า NPU ที่อุตสาหกรรมกำลังผลักดันกันอยู่ ไม่ได้ถูกนำมาใช้แทน GPU ซึ่งยืนยันได้จากการทดสอบ แต่ NPU มีประโยชน์มากกว่าในฐานะหน่วยประมวลผล AI อีกชุดหนึ่งที่รับงานเล็กหรืองานเบื้องหลัง โดยปล่อยให้ GPU ทำเวิร์คโหลดหลักครับ