llama.cpp v0.5.0 อัปเดตใหญ่ ปรับ CUDA, Vulkan, SYCL และ Local AI Server ให้รองรับโมเดลยุคใหม่ดีขึ้น
ประเภท: News · วันที่: 2026-09-25
ทีมพัฒนา llama.cpp เปิดตัวเวอร์ชัน v0.5.0 เมื่อวันที่ 23 กันยายน 2026 โดยรอบนี้เน้นไปที่การเพิ่มประสิทธิภาพ backend, ปรับความถูกต้องในการประมวลผล, เพิ่มการรองรับโมเดลใหม่ และทำให้ llama-server ทำงานได้เสถียรมากขึ้น
สำหรับผู้ใช้ Local AI การอัปเดตครั้งนี้น่าสนใจเป็นพิเศษ เพราะมีการปรับปรุงทั้ง CUDA, HIP/ROCm, Vulkan, SYCL และ Metal พร้อมกัน รวมถึงเพิ่ม optimization สำหรับ Intel Arc, Gemma 4, MoE, Flash Attention และ MTP ด้วย
Intel Arc และ Vulkan ได้รับการปรับปรุงสำคัญ
หัวข้อที่มีชื่อว่า “Intel Arc และ Vulkan ได้รับการปรับปรุงสำคัญ”หนึ่งในการเปลี่ยนแปลงที่น่าสนใจที่สุดของ v0.5.0 คือการเพิ่ม Flash Attention kernel ที่ปรับแต่งมาสำหรับ GPU Intel Xe โดยรองรับตั้งแต่ Xe-LPG Plus, Xe2 ไปจนถึง Xe3
นอกจากนี้ Vulkan backend ยังเพิ่ม kernel สำหรับ quantization แบบ IQ4_XS และปรับปรุงการคำนวณ matrix multiplication หลายจุด ซึ่งอาจช่วยให้การรันโมเดล GGUF บน Intel Arc มีประสิทธิภาพดีขึ้นในบาง workload
ฝั่ง SYCL ก็มีการเพิ่ม fusion หลายประเภท เช่น GLU fusion, RMSNorm + Scale และ SSM Conv + SiLU รวมถึงการแก้ปัญหาด้าน memory และ device context
สำหรับผู้ใช้ Intel Arc B-Series เช่น Arc B580 หรือ Arc Pro B70 เวอร์ชันนี้จึงเป็นรุ่นที่ควรจับตามองและทดสอบใหม่ โดยเฉพาะโมเดลที่ใช้ Flash Attention และ MoE
Gemma 4 ได้ optimization เพิ่ม
หัวข้อที่มีชื่อว่า “Gemma 4 ได้ optimization เพิ่ม”llama.cpp v0.5.0 เพิ่มการปรับแต่ง Flash Attention สำหรับ Gemma 4 บน NVIDIA GPU ตั้งแต่สถาปัตยกรรม Ampere ขึ้นไป
ทีมพัฒนายังปรับ performance สำหรับ shape ที่ใช้กับ Gemma 4 26B A4B โดยเฉพาะ และแก้ parser บางส่วนของ Gemma 4 เพื่อให้การใช้งาน tool calling และ chat template มีความถูกต้องมากขึ้น
ผู้ใช้ RTX 30, RTX 40 และ RTX 50 Series จึงอาจเห็นประโยชน์จากการอัปเดตครั้งนี้ โดยเฉพาะเมื่อเปิด Flash Attention
CUDA เร่ง conv2d และรองรับ MTP ดีขึ้น
หัวข้อที่มีชื่อว่า “CUDA เร่ง conv2d และรองรับ MTP ดีขึ้น”CUDA backend ได้รับการปรับปรุงหลายจุด โดยหนึ่งในรายการหลักคือการเปลี่ยนการประมวลผล conv2d ให้ใช้ implicit GEMM เพื่อเพิ่มประสิทธิภาพ
llama.cpp ยังเปิดใช้งาน CUDA Graph สำหรับ MTP drafting ซึ่งช่วยลดการใช้ทรัพยากรในการเรียก kernel ซ้ำ ๆ ใน workload ที่ใช้ Multi-Token Prediction
นอกจากนี้ยังมีการเพิ่ม sparse Flash Attention สำหรับสถาปัตยกรรมโมเดลรุ่นใหม่ เช่น Qwen4 และ DeepSeek V4
ทิศทางนี้สะท้อนว่า llama.cpp กำลังเตรียม backend สำหรับโมเดลรุ่นใหม่ที่มีโครงสร้างซับซ้อนกว่า Transformer แบบเดิมมากขึ้น
AMD ROCm/HIP ปรับ IQ2 และ IQ3
หัวข้อที่มีชื่อว่า “AMD ROCm/HIP ปรับ IQ2 และ IQ3”ฝั่ง AMD มีการ optimize kernel สำหรับ quantization แบบ IQ2 และ IQ3 บน HIP โดยใช้เทคนิค SWAR เพื่อเพิ่มประสิทธิภาพการประมวลผลข้อมูลจำนวนหลายค่าในคำสั่งเดียว
การปรับปรุงนี้ไม่ได้หมายความว่าโมเดลทุกตัวจะเร็วขึ้นทันที เพราะผลลัพธ์จะขึ้นอยู่กับ quantization และ workload ที่ใช้งาน
แต่ถ้าคุณใช้ Radeon สำหรับรันโมเดลขนาดใหญ่ด้วย quantization ต่ำ เช่น IQ2 หรือ IQ3 เวอร์ชันนี้ถือว่าน่าทดสอบเทียบกับรุ่นก่อน
Metal เพิ่ม optimization สำหรับ MoE และ SSM
หัวข้อที่มีชื่อว่า “Metal เพิ่ม optimization สำหรับ MoE และ SSM”Apple Silicon ก็ได้รับการปรับปรุงในรอบนี้เช่นกัน
Metal backend เพิ่ม fusion สำหรับ MoE และ SSM_CONV พร้อมปรับ Flash Attention และแก้ปัญหาด้าน memory access หลายรายการ
การเพิ่ม fusion ช่วยลดจำนวนตัวดำเนินการที่ต้องส่งแยกไปยัง GPU ซึ่งสามารถลดการใช้ทรัพยากรระบบและเพิ่ม throughput ได้ในเวิร์คโหลดที่เหมาะสม
เพิ่มการรองรับโมเดลใหม่
หัวข้อที่มีชื่อว่า “เพิ่มการรองรับโมเดลใหม่”llama.cpp v0.5.0 เพิ่มและขยายการรองรับโมเดลหลายตระกูล ได้แก่
- HRM-Text หรือ DFM Mimir 1B
- MiMo-V2.6
- HunyuanOCR พร้อม DFlash
- Nemotron MTP
- Nemotron-H
- Qwen4Exp
- Muse Glimmer
นอกจากนี้ยังมีการแก้ parser สำหรับ Ling 3.0, DeepSeek V3.2/V4, Qwen3-Coder, Muse Glimmer และ Gemma 4
จุดนี้สำคัญ เพราะโมเดล AI รุ่นใหม่เริ่มมีสถาปัตยกรรมและการดำเนินการเฉพาะทางมากขึ้น ทำให้ runtime ต้องรองรับมากกว่าการโหลดน้ำหนักของไฟล์ GGUF เพียงอย่างเดียว
HunyuanOCR เริ่มรองรับ DFlash
หัวข้อที่มีชื่อว่า “HunyuanOCR เริ่มรองรับ DFlash”อีกจุดที่น่าสนใจคือการรองรับ DFlash สำหรับ HunyuanOCR
DFlash เป็นแนวทาง speculative decoding ที่ช่วยลดเวลาการสร้าง token โดยใช้โมเดลหรือกลไกช่วยคาดการณ์ token ล่วงหน้า ก่อนให้โมเดลหลักตรวจสอบอีกครั้ง
การเพิ่มส่วนนี้ทำให้ llama.cpp เริ่มน่าสนใจมากขึ้นสำหรับ workflow ที่เกี่ยวข้องกับเอกสาร เช่น
- รูปภาพหรือ PDF → OCR → LLM → JSON หรือ Table
โดยเฉพาะระบบ Local AI ที่ต้องการทำงานกับข้อมูลภายในองค์กรโดยไม่ส่งเอกสารออกไปยัง Cloud
llama-server รองรับหลาย Network Address
หัวข้อที่มีชื่อว่า “llama-server รองรับหลาย Network Address”llama-server ใน v0.5.0 สามารถ bind หลาย network address พร้อมกันได้แล้ว โดย –host รองรับทั้ง TCP address หลายชุดและ UNIX socket
ตัวอย่างเช่น เซิร์ฟเวอร์หนึ่งตัวอาจเปิดให้เครื่องภายใน LAN เข้าถึงผ่าน IP หนึ่ง ขณะเดียวกันก็ให้ service ภายในเครื่องเชื่อมผ่าน UNIX socket ได้
ทีมพัฒนายังแก้ race condition ใน router, ปรับการจัดการ child process และปรับระบบ logging
สำหรับคนที่ใช้ llama.cpp เป็น Local AI Server ตลอดเวลา การเปลี่ยนแปลงกลุ่มนี้อาจสำคัญกว่าความเร็ว token generation เสียอีก
Function Calling รองรับภาพมากขึ้น
หัวข้อที่มีชื่อว่า “Function Calling รองรับภาพมากขึ้น”API ของ llama-server สามารถรับ input_image จาก function_call_output ได้แล้ว
นอกจากนี้ server ยังรองรับ OpenAI-compatible video_url และ Data URI สำหรับวิดีโอ ส่วน Web UI ก็เพิ่มการรองรับไฟล์ WEBM
แนวทางนี้ทำให้ llama.cpp ค่อย ๆ ขยายจาก runtime สำหรับ Text LLM ไปสู่ runtime ที่รองรับ multimodal workflow มากขึ้น
ggml อัปเดตเป็น 0.25.x
หัวข้อที่มีชื่อว่า “ggml อัปเดตเป็น 0.25.x”llama.cpp v0.5.0 มาพร้อมการอัปเดต ggml เป็นสาย 0.25.x ซึ่งเพิ่มความสามารถด้าน Hyper-Connection, Flash Attention, fused MoE, SSM และ backend optimization หลายรายการ
นอกจากนี้ RPC protocol ได้เปลี่ยนเป็น major version 7 ด้วย
ผู้ใช้ทั่วไปที่รัน llama-cli หรือ llama-server บนเครื่องเดียวอาจไม่รู้สึกถึงส่วนนี้มากนัก
แต่ถ้าคุณใช้ llama.cpp แบบ RPC, ใช้หลายเครื่อง หรือฝัง llama.cpp เข้าไปในซอฟต์แวร์ของตัวเอง ควรตรวจสอบความเข้ากันได้ก่อนอัปเกรด
ควรอัปเดตหรือไม่
หัวข้อที่มีชื่อว่า “ควรอัปเดตหรือไม่”ถ้าคุณใช้ llama.cpp กับฮาร์ดแวร์รุ่นใหม่ เช่น NVIDIA RTX, AMD Radeon, Intel Arc หรือ Apple Silicon การอัปเดตเป็น v0.5.0 ถือว่าน่าสนใจ เพราะมีการปรับ backend เกือบทุกแพลตฟอร์ม
กลุ่มที่น่าทดสอบใหม่เป็นพิเศษคือ
- Intel Arc + Vulkan/SYCL
- NVIDIA RTX + Gemma 4
- AMD Radeon + IQ2/IQ3
- โมเดล MoE
- โมเดลที่ใช้ MTP หรือ speculative decoding
- ระบบที่ใช้ llama-server เป็น AI API ภายในเครือข่าย
อย่างไรก็ตาม ไม่ควรคาดหวังว่า v0.5.0 จะทำให้ทุกโมเดลเร็วขึ้น เพราะการปรับแต่งส่วนใหญ่เป็นการทำแบบเฉพาะเจาะจงกับสถาปัตยกรรมของโมเดล, quantization และ backend บางประเภท
ถ้าคุณใช้ llama.cpp สำหรับ benchmark ควรทดสอบเวอร์ชันเก่าและใหม่ด้วย prompt, context size, quantization และ GPU offload เดิม เพื่อดูผลที่เกิดขึ้นจริงบนฮาร์ดแวร์ของคุณ
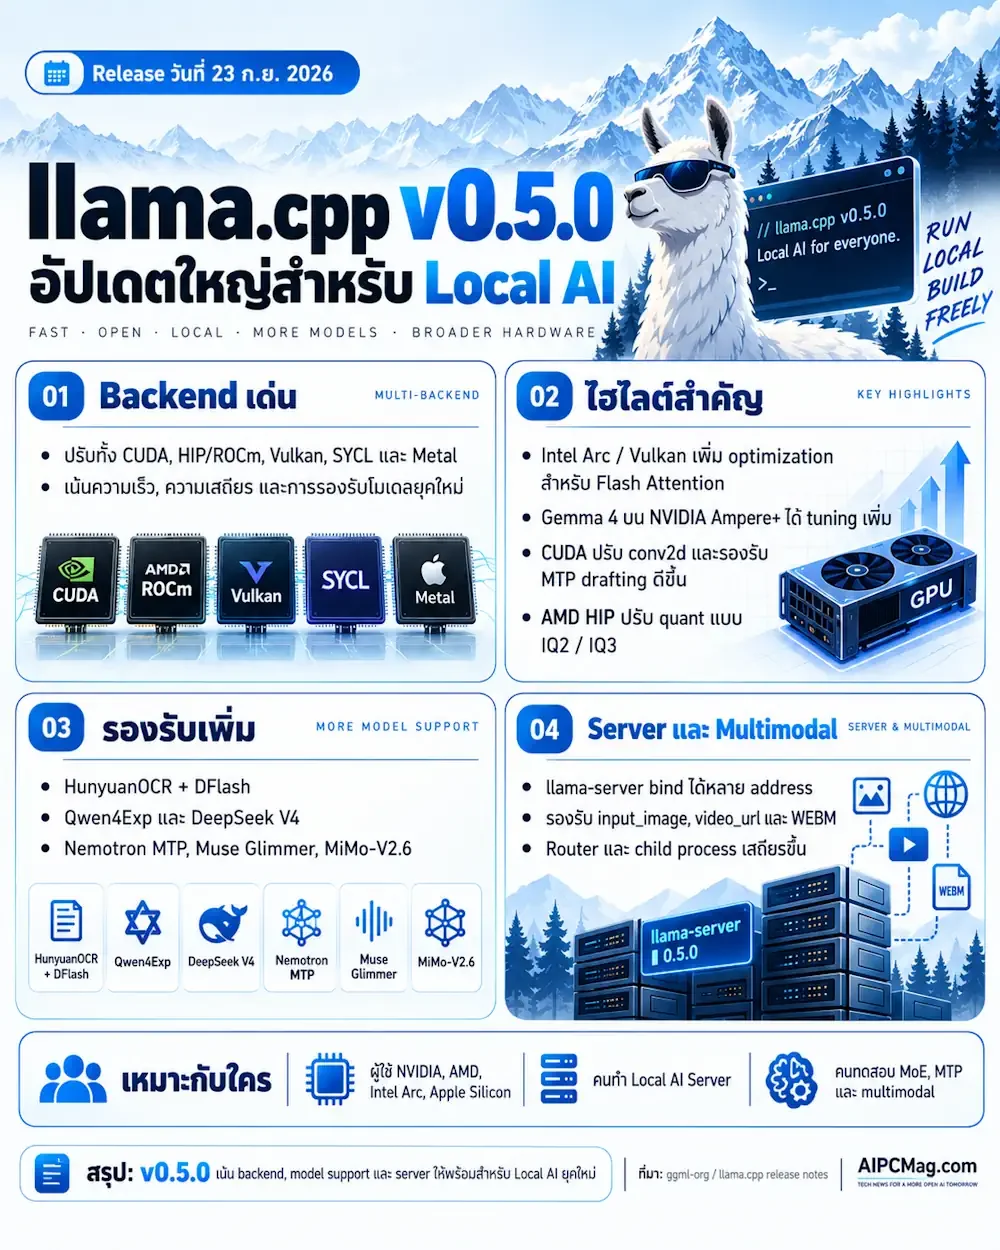
llama.cpp v0.5.0 เป็นการอัปเดตที่เน้นการวางพื้นฐานสำหรับ Local AI รุ่นถัดไปมากกว่าการเพิ่มฟีเจอร์ใหญ่เพียงตัวเดียว
CUDA, HIP, Vulkan, SYCL และ Metal ได้รับการปรับปรุงพร้อมกัน ขณะที่ระบบภายในเริ่มรองรับ MoE, MTP, sparse attention, multimodal และโมเดล architecture ใหม่มากขึ้น
สำหรับผู้ใช้ทั่วไป ความเปลี่ยนแปลงอาจเห็นเป็นความเร็วหรือความเสถียรที่ดีขึ้นในบางโมเดล
แต่ในภาพใหญ่ v0.5.0 แสดงให้เห็นว่า llama.cpp กำลังพัฒนาจากเครื่องมือรัน GGUF ไปสู่ runtime สำหรับ Local AI ที่รองรับ workload หลากหลายขึ้นเรื่อย ๆ
ข้อมูล: https://github.com/ggml-org/llama.cpp/releases/tag/v0.5.0
ดาวน์โหลด/ติดตั้ง: https://github.com/ggml-org/llama.cpp