Strata 0.2.11 รองรับ Qwen3.8-Flash-Next จาก Unsloth Dynamic v3.1 ปรับปรุง Multi-GPU, NVIDIA CUDA, AMD Radeon และการจัดการ VRAM พร้อมแก้ไขปัญหาการบันทึก Chat และความเสถียร
Tag: Quantization
- Strata 0.2.11 อัปเดต รองรับ Qwen3.8-Flash-Next รุ่นใหม่จาก Unsloth เพิ่มประสิทธิภาพ Multi-GPU และเร่งความเร็ว Prompt Processing
- MAI-Code-1.1-Flash: โมเดล MoE 137.9B บีบเหลือ 53 GB รันบน Windows ด้วย RTX Spark
Microsoft เผยวิธีบีบโมเดลเขียนโค้ด MAI-Code-1.1-Flash จากประมาณ 276 GB เหลือ 53.0 GiB พร้อม speculative decoding และผลวัดบน RTX Spark 128GB (ผลวัดของ Microsoft ไม่ใช่ผลทดสอบของเรา)
- Qwen3.8-Flash-Next GGUF จาก Unsloth ใช้ Dynamic V3.1 ลดขนาดโมเดล 125B ให้รันบนเครื่องที่มีแรมจำกัดได้ง่ายขึ้น
Unsloth ปล่อย GGUF ของ Qwen3.8-Flash-Next ด้วยอัลกอริทึม Dynamic V3.1 (preview) พร้อมตัวเลือก MTP และ engram แบบเลือกความละเอียดได้ บทความนี้สรุปว่าใครควรสนใจ และตัวเลขไหนเป็นคำอ้างของผู้ผลิต
- รันโมเดล 125B บนการ์ด Radeon AI PRO R9700 สองใบ (Qwen3.8-Flash-Next)
ทดสอบโมเดล MoE ขนาด 75.8 GB ที่การ์ดใบเดียวรับไม่ไหว บน Radeon AI PRO R9700 สองใบ ด้วย ROCm และ Vulkan ทั้งบริบทสั้นและบริบทยาวถึง 128K พร้อมผลทดลอง MTP
- เมื่อโมเดลถูกลดขนาดยังตอบคำถามได้เหมือนเดิมไหม: กรณีศึกษา Qwen3.8 27B ตั้งแต่ Q8 ถึง Q2
ทดสอบ Qwen3.8 27B 7 ระดับ quantization ตั้งแต่ Q8_0 ถึง Q2_K_XL บน Radeon AI PRO R9700 ดูทั้งคุณภาพ (PPL, KLD, HellaSwag และโจทย์จริง 764 ข้อ) ความเร็ว และ VRAM
- คู่มือ VRAM 16GB: โมเดล 12B สบาย แต่ 27B ที่ Q4 ยังไม่พอดีบนการ์ดใบเดียว
คู่มือสำหรับการ์ดจอ VRAM 16GB สรุปความพอดีของโมเดลและ quantization พร้อมผลวัดจริงจากการต่อการ์ด 16GB สองใบ (RX 9060 XT คู่ และ RX 9070 XT + RX 6800 XT)
- คู่มือ VRAM 8GB: รันโมเดลอะไรได้บ้าง
คู่มือสำหรับการ์ดจอ VRAM 8GB สรุปว่าโมเดลขนาดไหนและ quantization ระดับไหนพอดี เหลือที่ให้ context เท่าไร และทางเลือกเมื่อไม่พอ
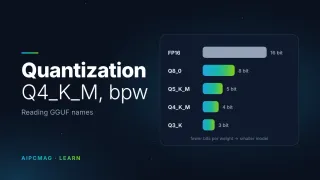
- ถอดรหัสโมเดล Q4_K_M, Q3_K_XL หมายถึงอะไร
อธิบาย Quantization ของโมเดล Local AI ผ่านชื่อ GGUF อย่าง Q4_K_M, Q5_K_M และ Q8_0 ว่าแต่ละส่วนหมายถึงอะไร พร้อมแนวคิด bpw ที่ใช้คำนวณขนาดและหน่วยความจำ
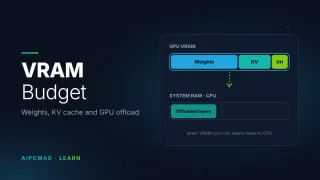
- พื้นที่ VRAM ของการ์ดจอถูกใช้ไปกับอะไรบ้าง และจัดการได้อย่างไรถ้ามีไม่พอ
แนวทางคำนวณงบหน่วยความจำ VRAM จากน้ำหนักโมเดล KV cache และ overhead พร้อมอธิบายการทำ GPU offload และการแบ่งชั้นไป CPU เมื่อหน่วยความจำไม่พอ
- Alibaba เปิดตัว Qwen-Image-2.1 โมเดลสร้างภาพขนาดเพียง 7B ที่เก่งเกินตัว สร้างภาพได้หลากหลายสไตล์
Qwen-Image-2.1 ถูกออกแบบให้สร้างสมดุลระหว่างคุณภาพของภาพ ความเร็วในการประมวลผล และต้นทุนการใช้งาน โดยเปิดซอร์สโมเดลผ่าน GitHub, Hugging Face และ ModelScope แล้ว
- llama.cpp v0.5.0 อัปเดตใหญ่ ปรับ CUDA, Vulkan, SYCL และ Local AI Server ให้รองรับโมเดลยุคใหม่ดีขึ้น
สำหรับผู้ใช้ Local AI การอัปเดต llama.cpp v0.5.0 ครั้งนี้น่าสนใจเป็นพิเศษ เพราะมีการปรับปรุงทั้ง CUDA, HIP/ROCm, Vulkan, SYCL และ Metal พร้อมกัน
- รายงานผลการทดสอบ: AMD Radeon RX 9070 XT 16GB กับการรัน Local LLM บน Windows — ประชัน ROCm vs Vulkan บน 8 โมเดล LLM พร้อมทดสอบขีดจำกัด Concurrency
ผลการทดสอบเชิงลึกการ์ดจอ AMD Radeon RX 9070 XT 16GB (สถาปัตยกรรม RDNA 4) ด้วย PromptMark v0.4.0 และ Concurrent Text Benchmark เปรียบเทียบรันไทม์ ROCm vs Vulkan ทั้งโมเดล MoE, Dense และฟอร์แมตควอนไทซ์ NVFP4 พร้อมวัดประสิทธิภาพการรองรับผู้ใช้พร้อมกัน 16 ผู้ใช้
- รายงานผลการทดสอบ: Intel Arc B580 Dual GPU (2x 12GB รวม 24GB VRAM) กับการรัน Local LLM บน Windows
ผลการทดสอบเชิงลึกการ์ดจอคู่ Intel Arc B580 24GB VRAM ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ SYCL vs Vulkan และสถาปัตยกรรม MoE vs Dense บน 8 โมเดล LLM ยอดนิยม
- รายงานผลการทดสอบ: Intel Arc B580 12GB กับการรัน Local LLM บน Windows (Vulkan vs SYCL)
ผลการทดสอบการ์ดจอ Intel Arc B580 12GB (สถาปัตยกรรม Xe2) ด้วย PromptMark เปรียบเทียบรันไทม์ Vulkan vs SYCL บน 5 รูปแบบโมเดล LLM พร้อมวิเคราะห์ Prefill, Decode และการสเกล Context 8K
- bpw (Bits per Weight)
จำนวนบิตเฉลี่ยที่ใช้เก็บ weight หนึ่งตัวในไฟล์โมเดล ยิ่งต่ำไฟล์ยิ่งเล็ก
- GGUF
รูปแบบไฟล์สำหรับเก็บโมเดล ที่โปรแกรมอย่าง llama.cpp, LM Studio และ Ollama อ่านและรันได้ โดยรวม weights และข้อมูลประกอบ (metadata) ไว้ด้วยกัน
- NVFP4
รูปแบบตัวเลขทศนิยม 4 บิต (4-bit floating point) ของ NVIDIA ที่ออกแบบมาให้ Tensor Core ของ GPU สถาปัตยกรรม Blackwell คำนวณได้โดยตรง ใช้ลดขนาดโมเดลและ memory ที่ต้องอ่านตอนรัน
- Quantization
การลดความละเอียดของตัวเลข weights ในโมเดล (เช่น จาก 16-bit เหลือ 4-bit) เพื่อให้ไฟล์เล็กลงและใช้ RAM/VRAM น้อยลง โดยแลกกับคุณภาพที่อาจลดลง