รีวิว AMD Radeon AI PRO R9700 กับประสิทธิภาพการทำงาน Local LLM
AMD Radeon AI PRO R9700 เป็นการ์ดจอระดับ Workstation / Professional รุ่นสำคัญจากเอเอ็มดีที่เปิดตัวมาเพื่อเจาะตลาด AI โดยเฉพาะ ไม่ว่าจะเป็นการพัฒนา Local AI, Machine Learning Inference และ Generative AI Workflows ด้วยจุดขายหลักคือการให้ VRAM 32GB GDDR6 บนสถาปัตยกรรม RDNA4 ในระดับราคาที่เข้าถึงได้ง่ายกว่าการ์ดระดับ Data Center หรือการ์ดระดับองค์กรของเจ้าตลาด
ผู้อ่านหลายท่านอาจจะไม่ได้ติดตามเรื่องราวทางด้านฮาร์ดแวร์มากนักก็อาจจะคิดว่าเอเอ็มดีนั้นเป็นน้องใหม่ในวงการ AI แต่อันที่จริงเรื่องงานด้าน AI ทางเอเอ็มดีเองก็เริ่มมานานพอสมควรแล้วเช่นกัน
แต่ถ้าจะเจาะจงในเรื่องของการพัฒนาฮาร์ดแวร์ที่ช่วยเร่งความเร็ว AI training และ inference ก็เริ่มจากปี 2020 เอเอ็มดีได้เพิ่ม Matrix Core เข้าไปกับสถาปัตยกรรม CDNA ที่เป็นการ์ดประมวลผลระดับ Data center
ส่วนฮาร์ดแวร์ในระดับผู้ใช้ทั่วไปและผู้ใช้ระดับมืออาชีพ เอเอ็มดีก็ได้เริ่มในช่วงเวลาใกล้กันกับสถาปัตยกรรม RDNA 2 หรือที่หลายคนคุ้นเคยกับ Radeon RX 6000 Series ในครั้งนั้นเอเอ็มดีได้เริ่มใส่ dot-product ALU เช่น DP4A/DP2A สำหรับ inference และ deep learning เบื้องต้น แต่ยังไม่ใช่ Matrix Core แบบเดียวกันกับ CDNA ที่อยู่บน Data center
จากนั้นในปี 2022 เอเอ็มดีก็ออกสถาปัตยกรรม RDNA 3 (Radeon RX 7000) และมีการเพิ่ม WMMA (Wave Matrix Multiple-Accumulator) และ AI Accelerator เขามาเป็นส่วนหนึ่งของ Compute Unit (CU) ด้วยเลย แต่วัตถุประสงค์ในตอนนั้นคือเป็นเรื่องการใช้ AI ร่วมกับเกมมากกว่า
ต่อมาในปี 2025 ได้เปิดตัวสถาปัตยกรรม RDNA 4 ที่เพิ่มจำนวน AI Accelerator เป็น 2 หน่วยต่อ CU และยังเป็น AI Accelerator เจนเนอร์เรชันที่ 2 อีกด้วย นอกจากนี้ยังรองรับ FP8/BF8 รวมทั้งเพิ่ม throughput ของ INT8/INT4 จากรุ่นก่อนอย่างมาก ซึ่งช่วยให้ประมวลผลเวิร์คโหลดด้าน AI ให้ดียิ่งขึ้น ซึ่งสถาปัตยกรรม RNDA 4 นี้ก็อยู่ในการ์ดจอในตระกูล Radeon RX 9000 Series รวมถึง Radeon AI Pro R9700 ที่เราจะกำลังทดสอบกันด้วยครับ
คุณสมบัติทางเทคนิคของ Radeon AI PRO R9700
| คุณสมบัติ (Specifications) | รายละเอียดทางเทคนิค |
|---|---|
| GPU Architecture | RDNA 4.0 (Navi 48 XTW) |
| Compute Units (CUs) | 64 CUs (4,096 Stream Processors) |
| AI Matrix Accelerators | 128 Units (2nd Gen AI Accelerators) |
| ความจุ VRAM | 32 GB GDDR6 (รองรับ ECC เมื่อใช้บน Linux) |
| Memory Bus / Bandwidth | 256-bit / สูงสุด ~640 GB/s |
| พลังประมวลผล (FP16/BF16) | ~95.7 TFLOPS |
| AI Compute Throughput (INT4 / FP8) | สูงสุดกว่า 1,500+ TOPS (เมื่อใช้ Sparsity Acceleration) |
| Form Factor & การระบายความร้อน | Dual-Slot Blower Fan (ออกแบบสำหรับ Multi-GPU Workstation) |
| Interface & Displays | PCIe 5.0 x16, 3x DisplayPort 2.1a, 1x HDMI 2.1b |
ไฮไลต์ด้านสถาปัตยกรรมสำหรับงาน AI
- AI Matrix Engines เจนเนอร์เรชัน 2: ปรับปรุงคำสั่งระดับ Hardware ให้รองรับประเภทข้อมูล FP8, BF16, INT8 และ INT4 ส่งผลให้การทำ Quantized Inference ทำได้รวดเร็วและใช้พลังงานต่ำลง
- VRAM 32GB: จุดสำคัญที่ทำให้สามารถโหลดโมเดลขนาดใหญ่ลงในหน่วยความจำของการ์ดจอได้ทั้งหมด 100% โดยไม่ต้องทำ CPU Offloading ซึ่งช่วยตัดปัญหาคอขวดด้าน Latency
อย่างไรก็ตามพื้นที่ VRAM 32GB ไม่ได้มีไว้เก็บน้ำหนักโมเดลอย่างเดียว ในงาน LLM ยังต้องเผื่อ KV Cache สำหรับข้อมูลบริบท และบัฟเฟอร์ที่รันไทม์ใช้ระหว่างคำนวณ ส่วนงานสร้างภาพหรือวิดีโออาจมีทั้งโมเดลหลัก ตัวแปลงข้อความ และตัวเข้ารหัสหรือถอดรหัสภาพทำงานเป็นลำดับ ดังนั้นการดูเพียงขนาดไฟล์โมเดลแล้วเทียบกับ VRAM จึงยังไม่เพียงพอครับในการใช้งานจริงครับ
ดีไซน์ของตัวการ์ด
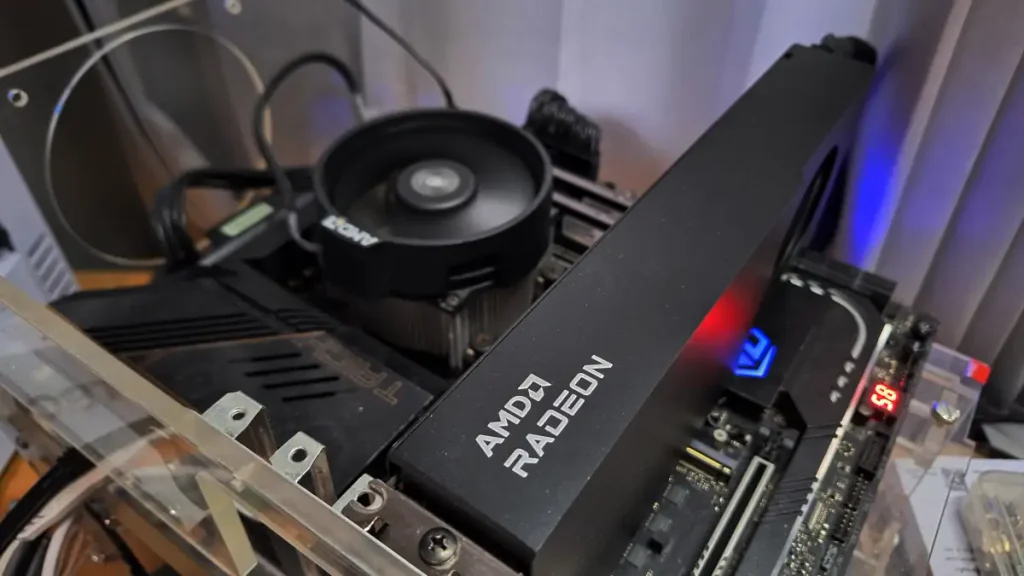
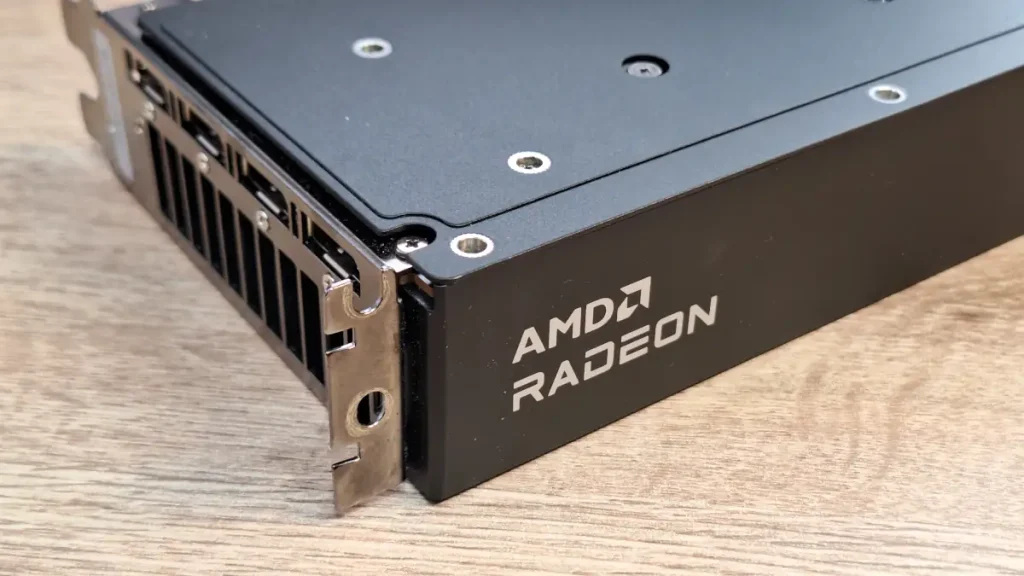
AMD Radeon AI Pro R9700 เป็นการ์ดจอที่ได้รับการออกแบบมาเพื่อให้ติดตั้งได้ง่าย โดยใช้พื้นที่เพียงสองสล๊อตเท่านั้น และใช้สไตล์การออกแบบโดยใช้พื้นฐานของการ์ดสำหรับเวิร์คสเตชันและเซิร์ฟเวอร์ที่สามารถตั้งและใช้งานพร้อมกันได้หลายการ์ดในพื้นที่จำกัด
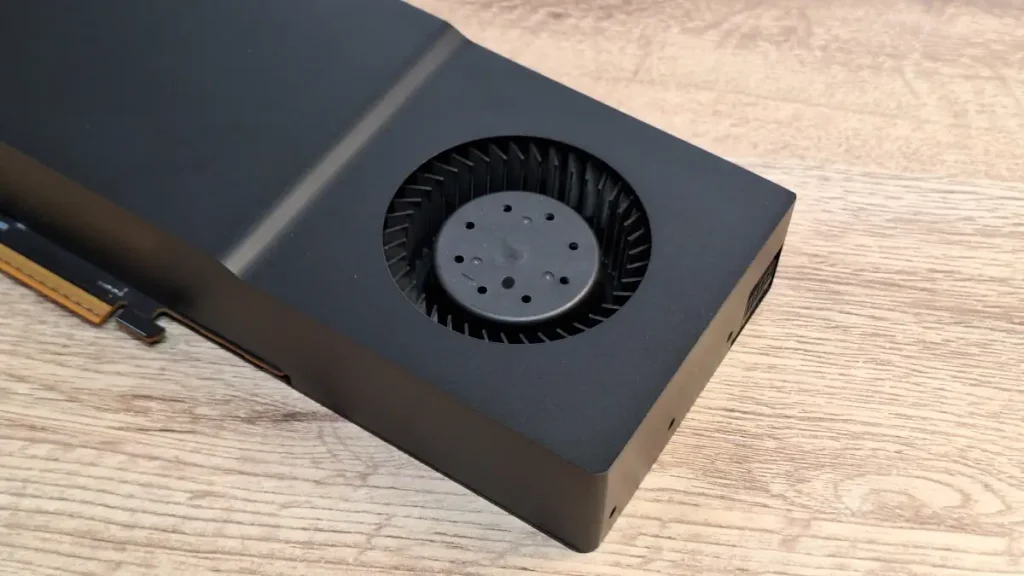
แม้ว่าหน้าตาของการ์ดอาจจะดูไม่ทันสมัยและมีฮีตซิงค์ที่ใหญ่เหมือนการ์ดจอตัวท็อป แต่ในการใช้งานจริงเราก็พบว่าเอเอ็มดีออกแบบการ์ดมาให้ทำงานในแบบรองรับเวิร์คโหลดสูงได้อย่างต่อเนื่องโดยไม่มีเรื่องความร้อนสะสม ด้วยพัดลมสไตล์โบลเวอร์
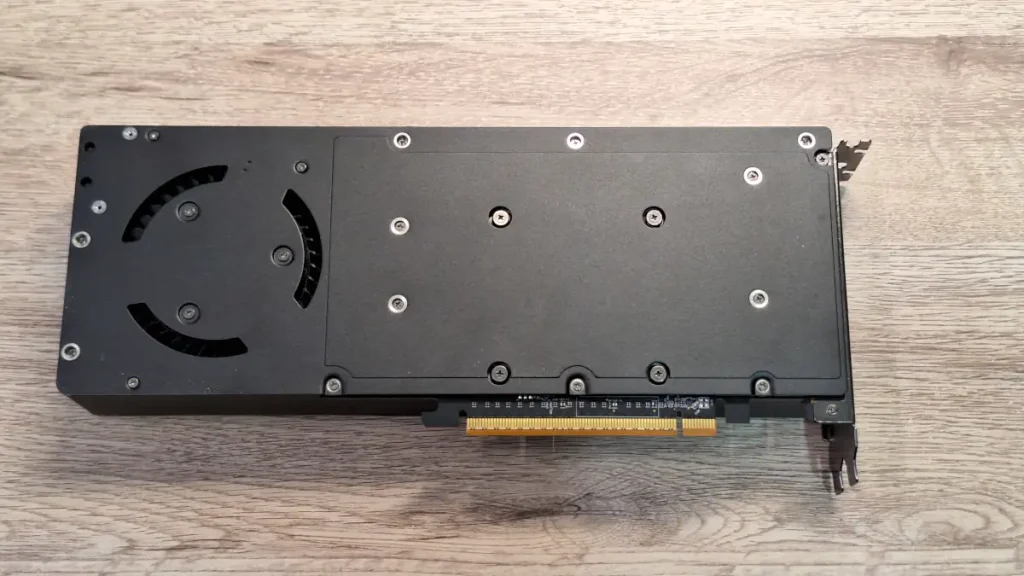
ส่วนทางด้านหลังของตัวการ์ดก็จะเป็น backplate โลหะที่ช่วยเสริมความแข็งแรงของตัวการ์ดและทำหน้าที่ระบายความร้อนไปด้วยในตัว
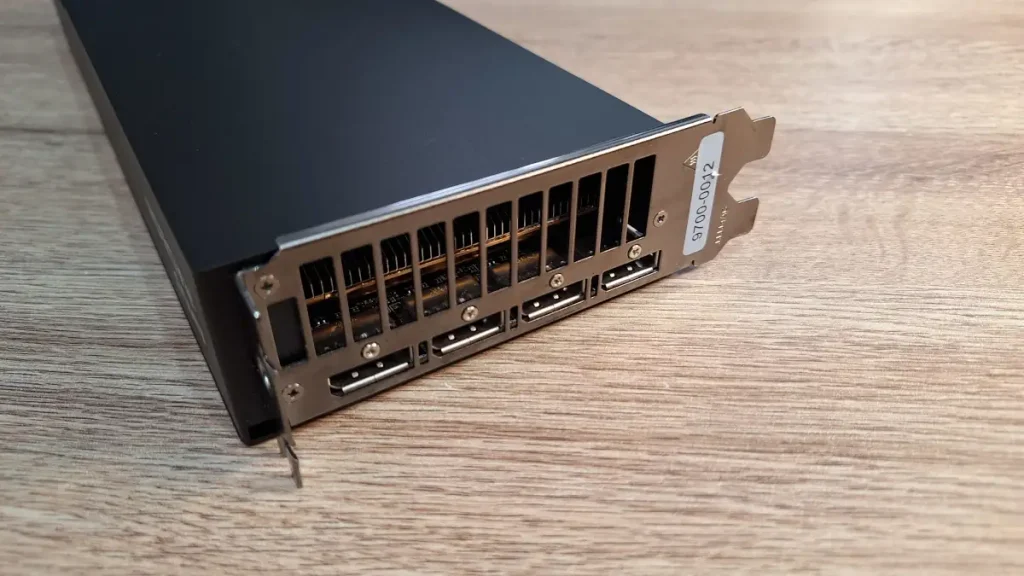
ถึงชื่อจะบอกว่าเป็น AI Pro ที่จับตลาด AI แต่จริง ๆ แล้วการ์ดรุ่นนี้ก็ยังคงสามารถใช้งานเป็นการ์ดสำหรับกลุ่มกราฟิกเวิร์คสเตชันได้เช่นเดียวกับ Radeon Pro รุ่นก่อน ๆ ครับ มาพร้อมกับช่องต่อจอภาพได้สูงสุดถึง 4 จอพร้อมกัน
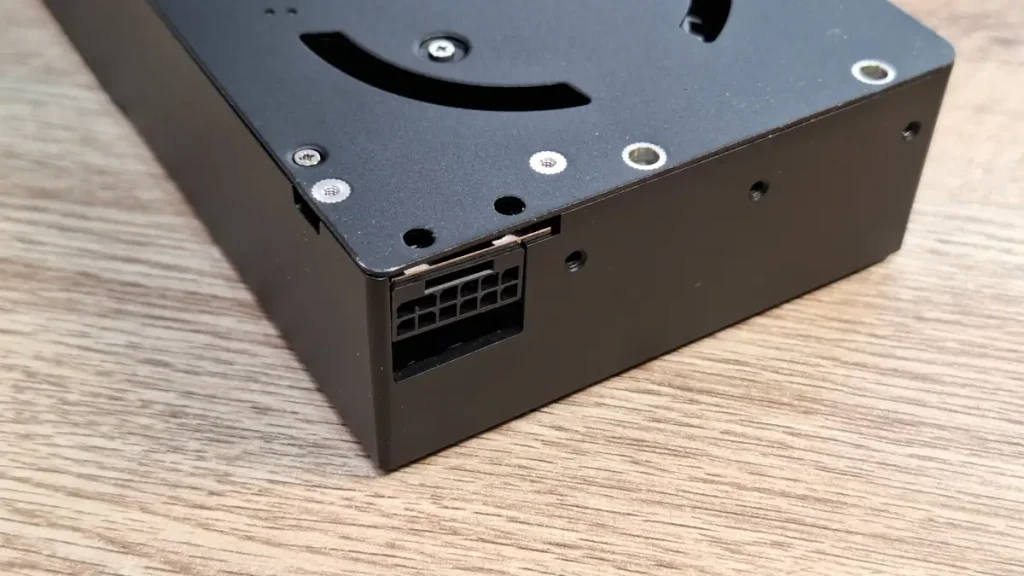
การจอรุ่นนี้ใช้พลังงานสูงสุดตามสเปคที่ 300W แต่จริง ๆ สามารถใช้พลังงานที่พีคมากกว่านั้นได้ในระยะเวลาสั้น ๆ ครับ ส่วนคอนเน็คเตอร์ที่ใช้ก็เป็นแบบ 12V-2×6 รุ่นล่าสุด ทางเอเอ็มดีแนะนำให้ใช้พาวเวอร์ซัพพลายขนาด 750W ขึ้นไป
เขียนมามากมายหลายคนเริ่มรำคาญ ตอนนี้ก็ไปเข้าเรื่องของการทดสอบกันได้เลยครับ
โมเดลที่ใช้ในการทดสอบ
| โมเดลทดสอบ | สถาปัตยกรรม/พารามิเตอร์ | VRAM ที่ใช้ประมาณ | จุดประสงค์ในการทดสอบ GPU |
| gemma-4-31B-it-QAT | Dense (31B) | ~20 GB | Compute Performance & VRAM Stress |
| gemma-4-26B-A4B-it-QAT | MoE (26B / Act 4B) | ~16 GB | Throughput, Memory Bandwidth |
| gemma-4-12B-it-QAT | Dense (12B) | ~8-10 GB | การใช้งานทั่วไปการ์ดจอระดับแมส (VRAM 8-12GB) |
| Qwen3.6-35B-A3B | MoE (35B / Act 3B) | ~22 GB | Throughput, Memory Bandwidth |
| Qwen3.8-27B-Q4_K_M | Dense (27B) | ~16 GB | Compute Performance & VRAM Stress |
(ทุกโมเดลที่ใช้ในการทดสอบเราเลือก Quantized แบบ Q4)
- กลุ่มโมเดลแบบ Dense (พารามิเตอร์หนาแน่น ทำงานร่วมกันทั้งหมด):
- Gemma-4-31B-it-QAT & Qwen3.8-27B: โมเดลในกลุ่มนี้จะนำพารามิเตอร์ทั้งหมด 27,000 – 31,000 ล้านตัวมาประมวลผลในทุก ๆ โทเคนที่สร้างขึ้น จุดเด่นคือ ความแม่นยำของเหตุผล (Reasoning Depth), ความสามารถในการจับความหมายซับซ้อน และความรู้เชิงลึกเฉพาะทาง ซึ่งนักพัฒนาและนักวิจัยมักเลือกใช้เมื่อต้องการผลลัพธ์ที่มีคุณภาพสูงสุด แม้จะต้องแลกกับภาระในการโหลด Weight (น้ำหนักของโมเดล) จำนวนมหาศาลผ่านช่องทางรับส่งข้อมูลของหน่วยความจำ
- Gemma-4-12B-it-QAT: โมเดล Dense ขนาดกะทัดรัด ให้ความสมดุลระหว่างความลึกในการตอบสนองกับความคล่องตัวในการทำงาน ใครที่มีการ์ดจอ VRAM 8GB – 12GB นี่เป็นหนึ่งในโมเดลที่น่าลองใช้งานอย่างจริงจังครับ เพราะเป็นโมเดลที่มีความสามารถหลากหลายมากเลย
- กลุ่มโมเดลแบบ MoE (Mixture-of-Experts: แยกสายความเชี่ยวชาญ):
- Qwen3.6-35B-A3B (รวม 35B / ใช้งานจริงครั้งละ 3B) และ Gemma-4-26B-A4B (รวม 26B / ใช้งานจริงครั้งละ 4B): โมเดลกลุ่มนี้ใช้สถาปัตยกรรมกระจายงาน โดยมีฐานความรู้ขนาดใหญ่รวม 26B–35B แต่ระบบเราเตอร์จะเลือกเปิดใช้เฉพาะส่วนพารามิเตอร์ที่เป็น “ผู้เชี่ยวชาญ” เฉพาะด้านเพียง 3B–4B ต่อหนึ่งโทเคน จุดเด่นคือ ความเร็วในการตอบสนองที่สูงมาก และการประหยัดพลังงาน เหมาะกับงานที่ต้องการความกว้างของฐานความรู้และการตอบโต้ที่ฉับไว
เวิร์คโหลดที่ใช้ในการทดสอบ
เนื่องจากผลการทดสอบจะมีตารางและตัวเลขจำนวนมาก รวมถึงงานที่เราใช้ทดสอบโมเดลร่วมกับการ์ดจอมีมากถึง 7 รูปแบบ ดังนั้นเราจึงใช้รหัสย่อขึ้นมาเพื่อใช้แทนการเรียกชื่อการทดสอบแบบยาว ๆ และจะทำให้บทความกระชับมากขึ้น (คิดว่านะ)
| รหัส | งาน/เวิร์คโหลด | prompt เป้าหมาย (token) | เอาต์พุตสูงสุด (token) |
|---|---|---|---|
| CG-512 | Content Generation | 512 | 256 |
| CW-512 | Creative Writing | 512 | 512 |
| Sum-2K | Summarization | 2,048 | 256 |
| Sum-4K | Summarization | 4,096 | 256 |
| Sum-8K | Summarization | 8,192 | 256 |
| Code-4K | Code Analysis | 4,096 | 256 |
| Thai | Thai Summary | ~1,078–1,391 | 256 |
ที่สำคัญเวิร์คโหลดหรืองานของเราจะทำหน้าที่เป็นตัวควบคุมการทดลองไปด้วยในตัวครับ เช่น CG-512 กับ CW-512 ใช้ prompt ยาวเท่ากัน (512 token) ต่างกันแค่ความยาวเอาต์พุต ส่วน Sum-4K กับ Code-4K ใช้ทั้ง prompt และเอาต์พุตเท่ากัน ต่างกันแค่ชนิดงาน เมื่อเอามาเทียบกันจะทำให้เรามองเห็นเรื่องของความยาว prompt และชนิดของงานด้วยว่าจะส่งผลต่อการทดสอบอย่างไร
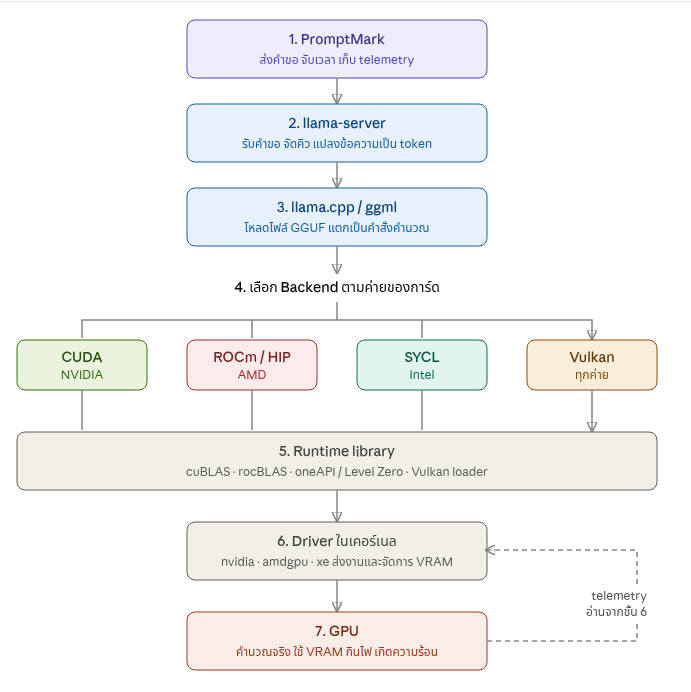
การทดสอบ (GPU + model + backend)
นอกจากเราจะใช้โมเดล 5 ตัว กับเวิร์คโหลด 7 รูปแบบ ในการทดสอบนี้เรายังเลือกใช้ backend สองแบบคือ ROCm 10 และ Vulkan/RADV รวม 10 รัน แต่ละรันยิงคำขอทั้งหมด 7 เวิร์คโหลดที่จำลองงานคนละแบบ แต่ละเวิร์คโหลดวัด 5 รอบและรายงานเป็นค่ามัธยฐาน (median) นอกจากนี้ยังมีการทดสอบเรื่อง Concurrent เพื่อดูการใช้งานของผู้ใช้หลายคนพร้อมกัน และการทดสอบเรื่อง Speculative ที่เป็นเทคนิคการเพิ่มความเร็วให้กับโมเดลแบบ Dense รวม ๆ แล้วก็เป็นการทดสอบกว่า 900 request ซึ่งก็คิดว่าน่าจะตอบข้อสงสัยต่าง ๆ ของการ์ดจอ Radeon AI Pro R9700 สำหรับงาน Local LLM ได้ในระดับหนึ่งครับ
อุปกรณ์ที่ใช้ในการทดสอบ
- CPU: AMD Ryzen 7 7700 (8C/12T)
- RAM: Thermaltake DDR5, 16GB x 4 รวม 64GB (5200MT/s)
- Mainboard: ASRock Taichi X670E
- PSU: Thermaltake DOCKPOWER FI 1200W
ซอฟต์แวร์
- OS: Ubuntu
- Ilama.cpp v0.6.0-dev build 11429 (commit d81235049)
- ROCm 10.0.0
- Mesa 26.2.4 ผ่าน Vulkan/RADV
- PromptMark 0.5.0
- โหมดมาตรฐาน: context 12,288, warm-up 1 รอบ บวกวัด 5 รอบ, ห่าง 15 วินาทีต่อคำขอ, ตั้งค่า decode แบบ greedy (T=0, seed 1234, ignore_eos), ครบทุก workload
- โหมด concurrent: context รวม 32,768 / 8 slots (4,096 ต่อผู้ใช้), workload สรุปเอกสาร (In 2K, out 256 token), ทดสอบ 5 รอบ
หมายเหตุ: การทดสอบและผลการทดสอบเหล่านี้เป็นเรื่องชั่วคราวเท่านั้นครับ ผมไม่อยากให้คุณผู้อ่านต้องไปยึดติดกับเรื่องความเร็วในการทำงานหรือพวกตัวเลข tok/s มากเกินไปนัก เพราะระหว่างที่เราทดสอบเสร็จ llama.cpp ก็อัปเดตเวอร์ชันใหม่แล้ว และเรื่องของแอปพลิเคชันด้าน AI ช้าสุดคือเปลี่ยนกันรายสัปดาห์ครับ รวมถึงการเปลี่ยนแปลงไดรเวอร์พวกนี้ก็มีผลต่อความเร็วแล้วครับ ให้ดูผลทดสอบเป็นแนวทางหรือทำความเข้าใจการทำงานพื้นฐาน หรือดูว่าการทำงานของ GPU กับโมเดลแต่ละแบบเป็นอย่างไรก็เพียงพอครับ เพราะในการใช้งานจริง ผมก็คิดว่าทุกคนคงไม่มาเปลี่ยนโมเดลไปมาเหมือนกับการทดสอบนี้ครับ น่าจะมีเวลาปรับจูนการทำงานต่าง ๆ ให้ได้ประสิทธิภาพสูงสุดกันอยู่แล้ว และนอกจาก llama.cpp ก็ยังมีเครืองมือสำหรับการรันโมเดลต่าง ๆ อีกมากมาย ไม่ว่าจะเป็น vLLM หรือ SGLang รวมถึงโปรแกรมที่สร้างมาเฉพาะสำหรับโมเดลใดโมเดลหนึ่งซึ่งจะให้ความเร็วที่เหนือกว่าโปรแกรมที่รองรับหลากหลายโมเดลมากครับ
Decode: ความเร็วในการสร้างคำตอบ
ประสิทธิภาพการ Decode (tg: token generation) หรือประสิทธิภาพในการสร้างโทเคนเพื่อตอบคำถาม
| โมเดล | Backend | CG-512 | CW-512 | Sum-2K | Sum-4K | Sum-8K | Code-4K | Thai |
|---|---|---|---|---|---|---|---|---|
| gemma-4-31B | Vulkan | 29.92 | 29.76 | 29.20 | 28.99 | 28.48 | 29.02 | 29.29 |
| gemma-4-31B | ROCm | 28.04 | 27.89 | 27.09 | 26.86 | 26.42 | 26.84 | 27.07 |
| gemma-4-26B-A4B | Vulkan | 133.33 | 133.59 | 130.39 | 129.30 | 126.16 | 129.27 | 131.03 |
| gemma-4-26B-A4B | ROCm | 96.09 | 96.00 | 92.41 | 92.12 | 90.69 | 91.87 | 91.78 |
| gemma-4-12B | Vulkan | 65.40 | 65.16 | 64.33 | 63.78 | 63.29 | 63.75 | 64.41 |
| gemma-4-12B | ROCm | 60.59 | 60.46 | 58.70 | 58.36 | 57.89 | 58.33 | 58.47 |
| Qwen3.6-35B-A3B | Vulkan | 134.24 | 134.86 | 133.25 | 131.02 | 127.87 | 130.82 | 133.63 |
| Qwen3.6-35B-A3B | ROCm | 88.51 | 88.98 | 87.55 | 87.47 | 86.20 | 87.62 | 86.75 |
| Qwen3.8-27B | Vulkan | 31.31 | 31.38 | 31.16 | 30.86 | 30.44 | 30.98 | 31.24 |
| Qwen3.8-27B | ROCm | 29.67 | 29.65 | 29.52 | 29.32 | 28.93 | 29.32 | 29.40 |
(หน่วยเป็น token/s, เป็นค่า median ของ 5 รอบ, ตัวหนา = สูงสุดของคอลัมน์)
สิ่งที่ตารางนี้บอกเป็นอย่างแรกคือความเร็วของการ decode แทบไม่ขึ้นกับชนิดงานเลย ลองดูโจทย์ที่ให้สรุปเนื้อหา Sum-4K กับวิเคระห์โค้ด Code-4K ที่ใช้ prompt ยาวเท่ากันและเอาต์พุตเท่ากัน คำตอบกลับออกมาเท่ากันจนแทบเป็นตัวเลขเดียวกันทุกโมเดล โดยเฉพาะบน Vulkan ได้แก่ Qwen3.6 (131.02 กับ 130.82), Gemma-26B (129.30 กับ 129.27), Gemma-12B (63.78 กับ 63.75) และ Gemma-31B (28.99 กับ 29.02) แม้เนื้อหาของสองงานจะต่างกันอย่างมากระหว่าง “สรุปเอกสาร” กับ “วิเคราะห์โค้ด”
ผลทดสอบอีกคู่คือ CG-512 กับ CW-512 ที่ใช้ prompt ยาวเท่ากัน ให้ผลต่างกันไม่ถึง 0.6% ทุกโมเดล สรุปได้ว่าตัวแปรเดียวที่ทำให้ decode ขยับคือความยาว context (ผ่านขนาด KV cache) ไม่ใช่ชนิดงาน เมื่อไล่จาก 512 ไป 8K โมเดลทุกตัวช้าลง 3–6% เท่านั้น ช่วงที่แกว่งมากที่สุดคือ Gemma-26B Vulkan (126.16–133.59, ราว 5.9%) และน้อยที่สุดคือ Qwen3.8 Vulkan (30.44–31.38, ราว 3.1%)
ลำดับชั้นของความเร็วชัดเจนและไม่สลับกันเลยตลอดทั้ง 7 เวิร์คโหลด โมเดล MoE สองตัว (Qwen3.6 และ Gemma-26B) อยู่ช่วง 88~135 tok/s, Gemma-12B อยู่ราว 58~65 tok/s, และโมเดล dense ใหญ่ (Qwen3.8 กับ Gemma-31B) อยู่ที่ 27~31 tok/s ส่วน Vulkan ชนะ ROCm ทุกช่องทั้ง 7 เวิร์คโหลด โดยช่องที่ห่างที่สุดคือ MoE (+51%) และช่องที่ห่างน้อยที่สุดคือ dense (+6%) ซึ่งเดี๋ยวเราจะวิเคราะห์สาเหตุกันในช่วงต่อไป
Prefill: ความเร็วในการอ่านโจทย์
ประสิทธิภาพด้าน Prefill (pp: prompt processing) หรือความเร็วในการประมวลผล/ความเร็วในการอ่าน prompt ซึ่งส่วนนี้จะมีผลมาก ๆ เวลาที่เราส่งคำถามหรือเอกสารให้โมเดลตอบคำถามเพราะต้องแปลงเอกสารจำนวนมากทั้งหมดให้เป็น token ก่อนที่จะส่งให้โมเดลนำไปประมวลผลเพื่อหาคำตอบ
| โมเดล | Backend | CG-512 | CW-512 | Sum-2K | Sum-4K | Sum-8K | Code-4K | Thai |
|---|---|---|---|---|---|---|---|---|
| gemma-4-31B | Vulkan | 781 | 849 | 999 | 1,043 | 1,060 | 1,034 | 907 |
| gemma-4-31B | ROCm | 808 | 885 | 975 | 953 | 890 | 952 | 943 |
| gemma-4-26B-A4B | Vulkan | 2,927 | 3,008 | 3,935 | 4,320 | 4,475 | 4,303 | 3,605 |
| gemma-4-26B-A4B | ROCm | 3,173 | 3,185 | 3,858 | 4,019 | 3,810 | 3,988 | 3,584 |
| gemma-4-12B | Vulkan | 1,994 | 2,039 | 2,491 | 2,688 | 2,752 | 2,703 | 2,281 |
| gemma-4-12B | ROCm | 2,231 | 2,296 | 2,542 | 2,571 | 2,416 | 2,571 | 2,421 |
| Qwen3.6-35B-A3B | Vulkan | 2,453 | 2,421 | 3,477 | 3,735 | 3,808 | 3,672 | 2,884 |
| Qwen3.6-35B-A3B | ROCm | 2,500 | 2,505 | 3,237 | 3,411 | 3,431 | 3,386 | 2,775 |
| Qwen3.8-27B | Vulkan | 777 | 781 | 1,005 | 1,062 | 1,076 | 1,058 | 874 |
| Qwen3.8-27B | ROCm | 848 | 850 | 1,001 | 1,031 | 1,030 | 1,031 | 932 |
(หน่วยเป็น token/s, เป็นค่า median ของ 5 รอบ, ตัวหนา = สูงสุดของคอลัมน์)
ผลตรงนี้ต่างจาก decode อย่างสิ้นเชิง prefill เป็นงานแบบ GEMM (GEneral Matrix Multiply หรือการคูณเมทริกซ์) ที่ใช้พลังของการ compute อย่างเต็มที่ ค่านี้จะปรับเปลี่ยนไปตามความยาวของ prompt แล้วเริ่มคงที่ราว 2K~8K โดย Gemma-26B บน Vulkan ไล่จาก 2,927 tok/s ที่ prompt 512 ขึ้นไปถึง 4,475 tok/s ที่ prompt 8K (+53%)
จากตารางทดสอบนี้ prompt ขนาด 512 token บน ROCm กลับทำได้เร็วกว่า Vulkan ทั้ง 5 โมเดล ทั้ง CG-512 และ CW-512 ตัวอย่างชัดคือ Gemma-26B ROCm 3,173 เทียบ Vulkan 2,927 หรือ Qwen3.8 ROCm 848 เทียบ Vulkan 777 แต่พอ prompt ยาวขึ้นเป็น 2K~8K ฝั่ง Vulkan พลิกแซงและทิ้งห่างขึ้นเรื่อย ๆ จนถึง 8K คือ Gemma-31B 1,060 เทียบ 890 tok/s (+19%)
ถ้าดูเฉพาะการทดสอบนี้เส้นแบ่งอยู่ในช่วงประมาณ 1,000 – 2,000 token ต่ำกว่านั้นงานเล็ก ROCm รับมือได้ดีกว่า แต่เมื่อ GEMM ใหญ่ขึ้นจนประสิทธิภาพด้าน compute กลายเป็นปัจจัยหลักที่ทำให้ Vulkan ทำได้ดีกว่า สังเกตได้จากงาน Thai ที่มี prompt เพียง ~1,078 – 1,391 token ซึ่ง ROCm ยังชนะใน 3 จาก 5 โมเดล (Gemma-31B, Gemma-12B, Qwen3.8) ซึ่งเป็นการยืนยันตำแหน่งของเส้นแบ่งนี้ครับ
อีกเรื่องที่เห็นชัดในตารางคือโมเดลแบบ MoE ให้ prefill สูงกว่าโมเดล Dense อย่างมีนัยสำคัญ Gemma-26B ทำได้ 4,475 tok/s ที่ 8K เทียบกับ Gemma-31B ทำได้ที่ 1,060 tok/s (ต่างกันราว 4.2 เท่า) ตรงข้ามกับความเข้าใจที่ว่า MoE ช่วยได้เฉพาะการ decode (แต่ก็ต้องไม่ลืมว่าจำนวนพารามิเตอร์หลักก็ต่างกันพอสมควร)
TTFT: ระยะเวลาในการสร้างโทเคนแรก
TTFT (Time to First Token) คือระยะเวลาตั้งแต่ผู้ใช้กดส่งคำถาม (หรือส่ง Prompt) จนกระทั่งโมเดลสร้างโทเค็นแรกออกมาให้เห็น ซึ่งอาจจะเห็นโทเคนในส่วนของความคิด หรือโทเคนที่แรกที่แสดงคำตอบบนหน้าจอให้เราเห็นก็ว่าได้ แล้วแต่ว่าโมเดลนั้นจะมีลักษณะการทำงานอย่างไร หรือเรากำหนดรูปแบบไว้อย่างไร
| โมเดล | Backend | CG-512 | CW-512 | Sum-2K | Sum-4K | Sum-8K | Code-4K | Thai |
|---|---|---|---|---|---|---|---|---|
| gemma-4-31B | Vulkan | 1,822 | 1,081 | 2,632 | 5,155 | 9,000 | 5,469 | 2,810 |
| gemma-4-31B | ROCm | 1,745 | 1,014 | 2,630 | 5,464 | 10,412 | 5,719 | 2,691 |
| gemma-4-26B-A4B | Vulkan | 490 | 332 | 708 | 1,304 | 2,219 | 1,356 | 737 |
| gemma-4-26B-A4B | ROCm | 457 | 307 | 706 | 1,359 | 2,517 | 1,403 | 725 |
| gemma-4-12B | Vulkan | 732 | 506 | 1,105 | 2,058 | 3,531 | 2,085 | 1,137 |
| gemma-4-12B | ROCm | 686 | 456 | 1,074 | 2,094 | 3,933 | 2,133 | 1,080 |
| Qwen3.6-35B-A3B | Vulkan | 358 | 327 | 711 | 1,267 | 2,352 | 1,333 | 553 |
| Qwen3.6-35B-A3B | ROCm | 356 | 322 | 758 | 1,372 | 2,584 | 1,422 | 569 |
| Qwen3.8-27B | Vulkan | 1,006 | 919 | 2,320 | 4,260 | 8,100 | 4,439 | 1,667 |
| Qwen3.8-27B | ROCm | 944 | 862 | 2,323 | 4,360 | 8,420 | 4,503 | 1,574 |
(มีหน่วยเป็นมิลลิวินาที · ยิ่งน้อยยิ่งดี, ตัวหนา = เร็วสุดของคอลัมน์)
TTFT โตเกือบเป็นเส้นตรงกับจำนวน token อินพุต ไล่จากไม่ถึงครึ่งวินาทีที่ prompt 512 ไปจนเกิน 10 วินาทีที่ 8K สำหรับโมเดล dense ใหญ่ แต่ว่าการใช้ทรัพยากรต่อ token กลับลดลงเมื่อ prompt ยาวขึ้น เพราะการใช้ทรัพยากรระบบบางส่วนมันคงที่ (การเตรียมกราฟ การยิง kernel) ถูกเฉลี่ยทิ้งไป ตัวอย่างจาก Qwen3.6 บน Vulkan คือ 358 ms ต่อ 512 token (0.70 ms/token) ที่ CG-512 แต่เหลือ 2,352 ms ต่อ 8,192 token (0.29 ms/token) ในการทดสอบ Sum-8K
มีข้อสังเกตเล็ก ๆ คือ CG-512 ให้ TTFT สูงกว่า CW-512 ทั้งที่ prompt ยาวเท่ากัน (Gemma-31B 1,822 เทียบกับ 1,081 ms) เพราะ CG-512 เป็นคำขอแรกของชุดทดสอบ จึงยังมีผลของ cold cache หลงเหลืออยู่แม้จะผ่าน warm-up หนึ่งรอบแล้ว นี่เป็นการเตือนว่าตัวเลขของเวิร์คโหลดแรกสุดควรอ่านอย่างระวัง
TTFT ในชุดนี้กว้างมาก ที่ 8K ไล่จาก 2,219 ms (Gemma-26B) ถึง 10,412 ms (Gemma-31B ROCm) เกือบห้าเท่า และส่วนต่างระหว่าง backend ก็กว้างสุดที่งานยาวเช่นกัน งานที่มี system prompt และ context ยาวจึงเป็นจุดที่ตัวเลือกโมเดล และการเลือกใช้ backend ก็สร้างความต่างที่ผู้ใช้รู้สึกได้จริง (นั่นเป็นหนึ่งเหตุผลที่เราทำไมต้องทดสอบถึงสอง backend)
ความเร็วกับภาษาไทย
เป็นหนึ่งเวิร์คโหลดที่เราเพิ่มเข้ามาก่อนที่จะเริ่มทดสอบเก็บคะแนนของการ์ดจอรุ่นนี้ครับ โจทย์คือให้โมเดลสรุปบทความเทคโนโลยีภาษาไทยประมาณ 3,850 ตัวอักษร (10.6 KB) เรื่องการเลือกการ์ดจอสำหรับรัน Local AI โดยต้องตอบเป็นภาษาไทยและแบ่งหัวข้อ จุดประสงค์คือวัดความเร็ว prefill/decode ของภาษาไทย และดูว่า tokenizer ของแต่ละโมเดลเข้ารหัสภาษาไทยได้คุ้มกว่ากัน โดยทุกโมเดลได้ข้อความเดียวกัน
| โมเดล | Backend | token/ตัวอักษร | อ่าน (ตัวอักษร/s) | เขียน (ตัวอักษร/s) | TTFT (s) | token อินพุต |
|---|---|---|---|---|---|---|
| gemma-4-31B | Vulkan | 0.3767 | 2,218 | 62.8 | 2.810 | 1,391 |
| gemma-4-31B | ROCm | 0.3767 | 2,305 | 57.1 | 2.691 | 1,391 |
| gemma-4-26B-A4B | Vulkan | 0.3767 | 8,813 | 342.2 | 0.737 | 1,391 |
| gemma-4-26B-A4B | ROCm | 0.3767 | 8,762 | 239.7 | 0.725 | 1,391 |
| gemma-4-12B | Vulkan | 0.3767 | 5,578 | 136.9 | 1.137 | 1,391 |
| gemma-4-12B | ROCm | 0.3767 | 5,919 | 124.1 | 1.080 | 1,391 |
| Qwen3.6-35B-A3B | Vulkan | 0.2917 | 9,098 | 351.1 | 0.553 | 1,078 |
| Qwen3.6-35B-A3B | ROCm | 0.2917 | 8,754 | 255.5 | 0.569 | 1,078 |
| Qwen3.8-27B | Vulkan | 0.2917 | 2,758 | 80.4 | 1.667 | 1,078 |
| Qwen3.8-27B | ROCm | 0.2917 | 2,941 | 76.1 | 1.574 | 1,078 |
จากโจทย์ชุดเดียวกัน Gemma 4 ใช้ 0.3767 token ต่อตัวอักษร ขณะที่ Qwen ใช้ 0.2917 หรือพูดง่าย ๆ ว่า Gemma 4 ใช้ token มากกว่า Qwen ราว 29% สำหรับเนื้อหาเดียวกัน นี่คือความเสียเปรียบเชิงโครงสร้างที่เกิดขึ้นก่อนที่การ์ดจะเริ่มทำงานด้วยซ้ำ เมื่อดูที่ context เท่ากัน โมเดลตระกูล Gemma 4 จะเก็บเนื้อความไทยได้น้อยกว่าอย่างมีนัยสำคัญ และทำให้ต้นทุนต่อคำขอสูงกว่าโดยไม่เกี่ยวกับประสิทธิภาพของ GPU เลย
ประเด็นที่สองคือช่องว่างระหว่าง backend ในงานไทยกว้างกว่าที่อื่นมาก ค่าความเร็วในการเขียนภาษาไทย (ตัวอักษรต่อวินาที) ของ Gemma-4-26B บน Vulkan สูงถึง 342.2 เทียบ 239.7 บน ROCm ต่างกันถึง 43% มากกว่าที่เห็นในตัวเลข decode ทั่วไป และน่าสังเกตว่าฝั่ง ROCm กลับอ่านได้เร็วกว่าเล็กน้อยในงานภาษาไทย (Gemma-12B 5,919 เทียบ 5,578) ซึ่งสอดคล้องกับเส้นแบ่งเรื่องความยาว prompt
สำหรับงานภาษาไทยที่ตอบยาว ความต่างระดับนี้คือคำตอบว่าควรเลือกโมเดลแบบใด (เรื่องคุณภาพของโมเดลเรากำลังเตรียมทดสอบอยู่อีกชุดครับ งานนี้ไม่เกี่ยวว่าจะใช้ GPU อะไรเป็นเรื่องของซอฟต์แวร์ล้วน ๆ ครับรอติดตามกันได้ครับ)
End-to-End: จากคำถามจนถึงคำตอบ
| โมเดล | Backend | CG-512 | CW-512 | Sum-2K | Sum-4K | Sum-8K | Code-4K | Thai |
|---|---|---|---|---|---|---|---|---|
| gemma-4-31B | Vulkan | 10,345 | 18,245 | 11,358 | 13,954 | 17,952 | 14,251 | 11,523 |
| gemma-4-31B | ROCm | 10,838 | 19,329 | 12,036 | 14,961 | 20,060 | 15,219 | 12,114 |
| gemma-4-26B-A4B | Vulkan | 2,405 | 4,153 | 2,664 | 3,273 | 4,241 | 3,330 | 2,681 |
| gemma-4-26B-A4B | ROCm | 3,111 | 5,629 | 3,466 | 4,128 | 5,335 | 4,178 | 3,502 |
| gemma-4-12B | Vulkan | 4,631 | 8,347 | 5,071 | 6,056 | 7,567 | 6,083 | 5,097 |
| gemma-4-12B | ROCm | 4,898 | 8,910 | 5,417 | 6,466 | 8,340 | 6,506 | 5,443 |
| Qwen3.6-35B-A3B | Vulkan | 2,256 | 4,114 | 2,625 | 3,214 | 4,346 | 3,283 | 2,460 |
| Qwen3.6-35B-A3B | ROCm | 3,237 | 6,065 | 3,667 | 4,286 | 5,542 | 4,330 | 3,509 |
| Qwen3.8-27B | Vulkan | 9,144 | 17,204 | 10,511 | 12,514 | 16,490 | 12,680 | 9,823 |
| Qwen3.8-27B | ROCm | 9,537 | 18,095 | 10,962 | 13,055 | 17,232 | 13,190 | 10,247 |
(มิลลิวินาที · ยิ่งน้อยยิ่งดี, ตัวหนา = เร็วสุดของคอลัมน์)
E2E คือผลรวมของ TTFT กับเวลาที่ใช้สร้างเอาต์พุตทั้งหมด ดังนั้น E2E จึงผูกกับสองอย่างพร้อมกัน ความยาว prompt (ผ่าน TTFT) และความยาวเอาต์พุต (ผ่าน decode) ด้วยเหตุนี้ CW-512 จึงกลายเป็นเวิร์คโหลดที่ใช้เวลานานที่สุดในเกือบทุกโมเดล ทั้งที่มี prompt เพียง 512 token เพราะต้องสร้างเอาต์พุต 512 token ซึ่งมากกว่าเวิร์คโหลดอื่นเป็นเท่าตัว ตัวอย่างที่ชัดที่สุดคือ Gemma-31B ใช้เวลา 18.2–19.3 วินาที ขณะที่ Qwen3.6 ใช้เพียง 4.1–6.1 วินาที (ต่างกันราว 4.4 เท่า)
ในมุมของการให้บริการ Qwen3.6 บน Vulkan ชนะ E2E ทุกเวิร์คโหลด โดยทิ้งห่างที่สุดในงานที่ออกเอาต์พุตยาว (CW-512) และห่างน้อยที่สุดในงานสรุปที่ prompt ยาวและเอาต์พุตสั้น (Sum-8K ห่างจาก Gemma-26B เพียงเล็กน้อย) ซึ่งสอดคล้องกับธรรมชาติของงาน เมื่อเอาต์พุตสั้น ความต่างของ decode ซึ่งเป็นจุดแข็งที่สุดของ MoE จะมีโอกาสแสดงผลน้อยลง และการใช้ทรัพยากรระบบของ prefill มากน้อยกลับเป็นตัวกำหนดเวลารวมแทน
ความเสถียร
การทดสอบส่วนใหญ่จะโฟกัสไปที่เรื่อง prefill, decode และ TTFT แต่ชุดทดสอบของเราได้บันทึกค่าความผันผวนของการทำงานในระหว่างการทดสอบเอาไว้ด้วย เพื่อดูว่าเมื่อเราสั่งทดสอบเป็นระยะเวลานานอย่างต่อเนื่อง ความร้อนของ GPU และ VRAM จะส่งผลต่อประสิทธิภาพหรือไม่ หรือมีเรื่องอื่น ๆ ที่ส่งผลต่อความผันผวนนี้หรือไม่ เช่นไดรเวอร์ ซอฟต์แวร์ระบบ หรือค่าอื่น ๆ
และผลทดสอบของเราก็น่าสนใจครับการใช้อุณหภูมิของ GPU และ VRAM ไม่ได้ส่งผลต่อเสถียรภาพในการทำงานเลย แต่สิ่งที่มีจริง ๆ ในการทดสอบนี้เรากลับพบผู้ต้องสังสัยคือ Vulkan + driver ไม่ใช่ว่า Vulkan ทำงานช้า ถ้าไปดูผลการทดสอบจะเห็นได้ว่าส่วนใหญ่ Vulkan ทำคะแนนได้ดีกว่ามาก แต่ค่าความผันผวนของการทดสอบนั้นสูงเกิน 3% ที่เรากำหนดไว้สำหรับเป็นข้อสังเกตในระหว่างการทดลอง แต่ความผันผวนที่เกิน 3% มานี้ ก็เกินมาเพียงเล็กน้อยเท่านั้นนะครับ ไม่ได้ขนาดพุ่งไประดับ 4-5% เพียงแต่ว่าเมื่อเทียบกับ ROCm ที่มีความผันผวนอยู่ระหว่าง 1-2% เท่านั้น จึงรู้สึกว่ามีความเปลี่ยนแปลงมากกว่า
| โมเดล | Backend | CG-512 | CW-512 | Sum-2K | Sum-4K | Sum-8K | Code-4K | Thai |
|---|---|---|---|---|---|---|---|---|
| gemma-4-31B | Vulkan | 3.13 | 1.27 | 0.88 | 0.48 | 0.19 | 0.17 | 0.19 |
| gemma-4-31B | ROCm | 0.54 | 0.27 | 0.23 | 0.07 | 0.13 | 0.10 | 0.05 |
| gemma-4-26B-A4B | Vulkan | 7.72 | 8.12 | 2.52 | 3.13 | 1.91 | 2.71 | 0.69 |
| gemma-4-26B-A4B | ROCm | 0.91 | 0.46 | 0.31 | 0.09 | 0.08 | 0.07 | 0.78 |
| gemma-4-12B | Vulkan | 1.19 | 5.12 | 5.22 | 2.08 | 1.14 | 1.68 | 0.18 |
| gemma-4-12B | ROCm | 1.97 | 1.32 | 0.53 | 0.31 | 0.05 | 0.27 | 0.70 |
| Qwen3.6-35B-A3B | Vulkan | 9.48 | 0.40 | 0.29 | 3.23 | 1.52 | 1.09 | 0.63 |
| Qwen3.6-35B-A3B | ROCm | 0.52 | 0.42 | 0.12 | 0.05 | 0.04 | 0.13 | 0.24 |
| Qwen3.8-27B | Vulkan | 7.51 | 6.18 | 2.37 | 1.09 | 0.09 | 0.13 | 2.80 |
| Qwen3.8-27B | ROCm | 0.71 | 0.69 | 0.16 | 0.09 | 0.10 | 0.14 | 0.32 |
(CV% ของ prefill · ตัวหนา = เกินเกณฑ์ 3%)
เมื่อแยกเป็นรายเวิร์คโหลด รูปแบบของความไม่เสถียรก็ชัดเจนขึ้นมาก เกณฑ์ CV ≤ 3% เกิดขึ้นเฉพาะในกรณีที่เป็น Vulkan + prefill + prompt สั้น เท่านั้น อาการที่มีในการทดสอบได้แก่ CG-512 (Gemma-31B 3.13, Gemma-26B 7.72, Qwen3.6 9.48, Qwen3.8 7.51) และ CW-512 (Gemma-26B 8.12, Gemma-12B 5.12, Qwen3.8 6.18) ส่วนงานที่ prompt ยาวตั้งแต่ 4K ขึ้นไปแทบไม่เคยเจอเลย
ฝั่ง ROCm ไม่เกินเกณฑ์แม้แต่ช่องเดียวในทั้ง 70 ช่องของตาราง (สูงสุด 1.97%) และค่า CV ของ decode เองก็ต่ำกว่า 1.3% ทุกช่องทั้งสอง backend พูดอีกแบบคือ decode ของทั้งสองฝั่งเชื่อถือได้เต็มที่ ความแปรปรวนทั้งหมดกระจุกตัวอยู่ที่ prefill ของ prompt สั้นบน Vulkan
อย่างไรก็ตามความผันผวนที่เกิน 3% นี้ไม่ได้ส่งผลต่อคุณภาพคำตอบหรือคุณภาพการใช้งานจริงครับ ยิ่งถ้าเป็นกรณีของผู้ใช้จำนวนน้อย หรือใช้คนเดียว แต่ถ้าตัวเลข 3% นี้ไปอยู่บนระบบเซิร์ฟเวอร์ที่ให้บริการขนาดใหญ่นั่นก็เป็นอีกประเด็นครับ
ส่วนสาเหตุที่ทำให้ ROCm นั้นนิ่งกว่า Vulkan ก็เป็นเพราะว่า ROCm/HIP ถูกออกแบบมาสำหรับงานคำนวณ AI เวิร์คโหลดโดยตรง การจัดสรรคิวงานลง GPU จึงเป็นแบบ Direct Compute Queue ที่มีความเสถียรสูง แต่ Vulkan ถูกออกแบบมาให้เกลี่ยทรัพยากรระหว่างกราฟิกและการประมวลผลทั่วไป ทำให้ไดรเวอร์ (เช่น RADV หรือ AMDVLK) อาจมีการสลับคิว หรือมีการทำงานของตัวไดรเวอร์การ์ดจอเล็กๆ น้อยๆ แทรกเข้ามาในระดับมิลลิวินาที ส่งผลให้เกิดความผันผวน (Jitter/Variance) ได้ง่ายกว่าครับ
เพดานของ bandwidth หน่วยความจำ
ในการ decode แบบผู้ใช้คนเดียว ทุกโทเค็นที่สร้างขึ้นต้องอ่านน้ำหนักทั้งหมดของโมเดลผ่าน VRAM หนึ่งรอบ และเนื่องจาก KV cache ที่ context ขนาดนี้มีน้ำหนักเบามาก จึงนำขนาดไฟล์โมเดลคูณกับความเร็วที่วัดได้ (tok/s) เพื่อย้อนกลับไปหาค่า effective bandwidth ซึ่งสามารถบอกได้ว่าหน่วยความจำของการ์ดถูกใช้งานจริงที่ความเร็วเท่าไร
| โมเดล | ขนาดไฟล์ | ROCm (Sum-8K) | Vulkan (Sum-8K) |
|---|---|---|---|
| Qwen3.8-27B | 15.7 GiB | 28.9 × 15.7 = 454 GiB/s | 30.4 × 15.7 = 478 GiB/s |
| Gemma-4-31B | 16.4 GiB | 26.4 × 16.4 = 433 GiB/s | 28.5 × 16.4 = 467 GiB/s |
| Gemma-4-12B | 6.5 GiB | 57.9 × 6.5 = 376 GiB/s | 63.3 × 6.5 = 411 GiB/s |
(สูตร: ขนาดไฟล์ × tok/s ให้หน่วยเป็น GiB/s แต่สเปกการ์ดเป็น GB/s (640 GB/s = 596 GiB/s))
ในการ decode ผลทดสอบขยับไม่เกิน 6% ตลอดทั้ง 7 เวิร์คโหลด ตัวเลข bandwidth ที่คำนวณได้จึงแทบไม่เปลี่ยนตามชนิดงานเช่นกัน ไม่ว่าจะคำนวณจาก CW-512 หรือ Sum-8K คำตอบก็อยู่ในกรอบเดิมเสมอ โมเดลแบบ dense ทั้งสองก็แสดงผลทดสอบแบบเดียวกัน คือ Qwen3.8-27B และ Gemma-4-31B แม้มีขนาดไฟล์ต่างกัน แต่ทั้งคู่จบลงที่ bandwidth ใกล้เคียงกันมาก ราว 440–460 GiB/s บน ROCm และ 470–490 GiB/s บน Vulkan
ส่วน Gemma-4-12B ให้ค่าต่ำกว่าเพดานเล็กน้อย (376~411 GiB/s) โมเดลมีขนาดไม่ใหญ่นัก และที่ความเร็วระดับ 60 tok/s ต้นทุนด้าน latency ต่อโทเค็นในการส่งข้อมูลไป kernel และขั้นตอน sampling เริ่มมีน้ำหนักพอ ๆ กับปริมาณข้อมูลที่อ่านจริง จุดนี้คือสัญญาณว่าโมเดลขนาดเล็กกำลังหลุดออกจากภาวะที่ถูกจำกัดด้วย bandwidth ล้วน ๆ หรือจะเทียบให้ดูง่ายด้วยหน่วย GB/s ที่ยึดจากตัวเลข 640GB/s แบนด์วิธด์ของสเปคจาก AMD ก็จะได้ดังนี้ครับ
| โมเดล | คำนวณได้ | คิดเป็น GB/s | % ของสเปก 640GB/s | % ของเพดานจริง (~0.87×สเปก) |
|---|---|---|---|---|
| Qwen3.8-27B | 464~491 GiB/s | 498~527 GB/s | 78~82% | ~88-95% |
| Gemma-4-31B | 459~489 GiB/s | 493~525 GB/s | 77~82% | ~88-95% |
| Gemma-4-12B | 393~423 GiB/s | 422~454 GB/s | 66~71% | ~76-82% |
ดังนั้นถ้าจะมองในแง่ของการเพิ่มประสิทธิภาพของการ์ดจอรุ่นถัดไป โจทย์ใหญ่ของ AMD ก็คือการเพิ่มแบนด์วิธด์ของ VRAM ให้สูงขึ้น เพราะพลังของ GPU ยังมีอย่างเหลือเฟือ
พูดแบบนี้หลายคนอาจจะตัดใจจากการ์ดรุ่นนี้ อย่าเพิ่งครับการทดสอบเรื่อง LLM นี่มันเป็นเพียงแค่ส่วนเดียวของเวิร์คโหลดด้าน AI เท่านั้นครับ ด้วยการ์ดจอที่มีพลังด้าน Compute สูงแบบนี้ เหมาะอย่างมาสำหรับงานประเภทที่ต้องนำเข้าข้อมูล เช่นงาน OCR เอกสารที่มีข้อมูลจำนวนมากเพื่อแปลงเข้า vector DB, จัดหมวดหมู่/สกัดข้อมูลจากเอกสารยาว, สรุปเอกสาร batch (ยิงรวดเดียวหลายฉบับ) หรืองาน RAG ที่ต้องทำงานร่วมกับการใช้ prompt ขนาดใหญ่ และยังมีงานที่ให้บริการกับผู้ใช้พร้อมกันหลายคน ซึ่งเรายังมีการทดสอบเรื่องพวกนี้รออยู่ครับ
MoE ก็เจอข้อจำกัดอีกแบบ
Qwen3.6-35B-A3B มีพารามิเตอร์ที่ active จริงต่อโทเค็นประมาณ 3B จากทั้งหมด 35B เมื่อประมาณการว่าการอ่าน experts ที่ active ต่อโทเค็นใช้พื้นที่ราว 2.5 ถึง 3 GiB ความเร็วที่วัดได้ 89 ถึง 135 tok/s จะแปลงกลับเป็นการอ่านข้อมูลประมาณ 220 ถึง 400 GiB/s ซึ่งต่ำกว่าเพดาน bandwidth อย่างชัดเจน นั่นหมายความว่า MoE บนการ์ดใบนี้ไม่ได้ถูกจำกัดด้วย bandwidth อีกต่อไป แต่ไปติดเงื่อนไขใหม่คือการทำ expert routing และ overhead ของ forward pass ที่ต้องคำนวณชิ้นเล็ก ๆ จำนวนมากในแต่ละวินาที
นี่คือเหตุผลที่ ROCm กับ Vulkan ให้ผลต่างกันถึง 51% บนโมเดลนี้ ในขณะที่ dense 27B ต่างกันเพียง 6% เพราะเมื่อชนเพดานแล้ว ทั้งสอง backend ต้องรอความเร็วหน่วยความจำเท่ากันพอดี ข้อควรระวังที่ได้จากตรงนี้คือ การคาดเดาประสิทธิภาพจากขนาดไฟล์หรือจำนวนพารามิเตอร์รวมนั้นใช้ไม่ได้ทั้งคู่ สิ่งที่สำคัญจริง ๆ มีเพียงอย่างเดียวคือจำนวน active bytes ต่อโทเค็น
ลองเร่งความเร็วโมเดล Dense ด้วย speculative
เนื่องจากโมเดลแบบ Dense นั้นมีน้ำหนักมากจึงมีการคิดค้นเทคนิคที่เรียกว่า Speculative ขึ้นมา โดยจะมีโมเดลขนาดเล็ก ที่ทำหน้าที่คาดเดาโทเคนไว้ล่วงหน้าเพื่อให้โมเดลใหญ่ตรวจสอบถ้าการคาดเดานั้นใช้ได้ก็จะเป็นการประหยัดเวลาในการสร้างโทเคนที่เป็นคำตอบได้ดีมาก โดยเทคนิค Speculative นี้ที่เห็นใช้งานกันบ่อย ๆ ก็คือ MTP, DFlash และ DFlash2
MTP (Multi-Token Prediction)
- หลักการ: แทนที่จะให้โมเดลทายโทเคนถัดไปทีละ 1 โทเคน (Next-token prediction) แบบดั้งเดิม เราปรับสถาปัตยกรรมหรือเทรนโมเดลให้มีหัวทำนายพิเศษ (Prediction Heads) งอกออกมา เพื่อสร้างโทเคนถัดไปออกมา พร้อมกันทีละหลายๆ คำในรอบ Forward Pass เดียว
- MTP นี้อาจจะฝังรวมไปกับโมเดลใหญ่ไปเลยก็ได้ หรือจะแยกออกมาเป็นไฟล์ขนาดเล็กเพื่อใช้เรียกแยกในภายหลังได้ เพราะบางทีการรวมไปกับโมเดลหลักเลยก็ทำให้ใช้พื้นที่หน่วยความจำมากขึ้น ซึ่งฮาร์ดแวร์บางรุ่นทำความเร็วได้น่าพอใจอยู่แล้ว ก็อาจจะไม่ต้องเรียนส่วนนี้เพิ่มเติม และรวมถึงการปรับปรุงส่วนของ MTP เองได้อย่างอิสระอีกด้วย
พูดไปยืดยาวมาดูผลการทดสอบกันครับ การทดสอบนี้เราเลือกใช้โมเดล Qwen3.8-27B เพียงโมเดลเดียวมาทำการทดสอบนะครับ
| Mode | Backend | CG-512 | CW-512 | Sum-2K | Sum-4K | Sum-8K | Code-4K | Thai |
|---|---|---|---|---|---|---|---|---|
| normal | ROCm | 29.71 | 29.63 | 29.52 | 29.34 | 28.95 | 29.32 | 29.42 |
| MTP | ROCm | 51.18 | 45.99 | 49.79 | 51.59 | 48.28 | 53.04 | 50.17 |
| DFlash | ROCm | 38.28 | 35.22 | 41.54 | 41.55 | 39.78 | 37.81 | 34.15 |
| DFlash2 | ROCm | 47.53 | 44.53 | 54.03 | 51.45 | 44.75 | 48.09 | 42.58 |
| normal | Vulkan | 31.80 | 31.80 | 31.62 | 31.39 | 30.96 | 31.42 | 31.72 |
| MTP | Vulkan | 59.96 | 51.96 | 56.47 | 59.90 | 57.40 | 60.39 | 57.69 |
| DFlash | Vulkan | 48.45 | 44.43 | 50.07 | 51.56 | 46.34 | 51.91 | 43.64 |
| DFlash2 | Vulkan | 60.86 | 58.85 | 62.30 | 60.03 | 58.29 | 62.56 | 55.09 |
(หน่วยเป็น tok/s · ตัวหนา = สูงสุดของคอลัมน์)
ตารางเปรียบเทียบเป็นอัตราที่เพิ่มขึ้น
| Mode | Backend | CG-512 | CW-512 | Sum-2K | Sum-4K | Sum-8K | Code-4K | Thai |
|---|---|---|---|---|---|---|---|---|
| MTP | ROCm | +72% | +55% | +69% | +76% | +67% | +81% | +71% |
| DFlash | ROCm | +29% | +19% | +41% | +42% | +37% | +29% | +16% |
| DFlash2 | ROCm | +60% | +50% | +83% | +75% | +55% | +64% | +45% |
| MTP | Vulkan | +89% | +63% | +79% | +91% | +85% | +92% | +82% |
| DFlash | Vulkan | +52% | +40% | +58% | +64% | +50% | +65% | +38% |
| DFlash2 | Vulkan | +91% | +85% | +97% | +91% | +88% | +99% | +74% |
(อัตราเร่ง decode เทียบ normal ใน backend เดียวกัน)
สิ่งที่ตารางเผยคืออัตราเร่งไม่ใช่ค่าเดียวตายตัว แต่ผูกกับลักษณะของงานอย่างชัดเจน งานที่มีโครงสร้างชัดและทำนายต่อได้ง่ายอย่างการสรุปความและวิเคราะห์โค้ด (Sum-2K/4K/8K, Code-4K) ให้ผลดีที่สุด โดย DFlash2 บน Vulkan แตะ +97% ถึง +99% ส่วนงานที่ต้องใช้ความคิดสร้างสรรค์หรือภาษาที่ tokenizer แตกตัวถี่อย่างภาษาไทยได้น้อยที่สุด (CW-512 +85%, Thai +74%) หลักการคือ ยิ่งงานทำนายง่าย draft model ยิ่งทายถูก อัตราเร่งก็ยิ่งสูง
บน Vulkan, DFlash2 ชนะ 6 จาก 7 เวิร์คโหลด ยกเว้นงาน Thai ที่ MTP แซงกลับ (57.69 กับ 55.09) เพราะงานภาษาไทยมีค่า acceptance ที่ต่ำกว่า ทำให้การเสนอ token แบบสั้นแต่แม่นของ MTP ได้เปรียบกว่าการเสนอแบบยาวของ DFlash2 นี่เป็นอีกหลักฐานว่าไม่มีโหมดใดดีที่สุดสำหรับทุกงาน
ส่วนที่ต้องแลกมาก็คือ prefill ที่ลดลง 3 ถึง 13% และ VRAM ที่เพิ่มขึ้น 2.0 ถึง 3.3 GiB สำหรับโหลด draft ซึ่งงานที่ prompt ยาวมากแต่อยู่ในรูปของ “อ่านเยอะ ตอบสั้น” คือกรณีที่คุ้มมากที่สุดในการเปิดใช้ ก็ต้องลองพิจารณากันเป็นกรณีไปครับ
ROCm 10 ปะทะ Vulkan
ตารางผลทดสอบนี้คือ Vulkan เทียบ ROCm ในเชิงผลต่าง (+ หมายถึง Vulkan เร็วกว่า)
| การทำงาน | Qwen3.6-35B-A3B | Gemma-4-26B-A4B | Gemma-4-12B | Qwen3.8-27B | Gemma-4-31B |
|---|---|---|---|---|---|
| Decode | +51% | +39% | +8% | +6% | +7% |
| Prefill ที่ 8K | +11% | +17% | +14% | +4% | +19% |
| TTFT ที่ 4K | -8% | -4% | -2% | -2% | -6% |
| ไฟเฉลี่ย W | 221 vs 223 | 218 vs 214 | 271 vs 243 | 289 vs 287 | 270 vs 270 |
ข้อได้เปรียบของ Vulkan แปรผันตามสัดส่วนของ compute ต่อ byte ของแต่ละงาน ยิ่งงานเป็นแบบ compute-bound เช่น MoE decode และ speculative decoding ยิ่งทิ้งห่าง ROCm มากถึง 39 ถึง 51% ส่วนงานที่ติดเพดาน VRAM อย่างการ decode ของโมเดล Dense ห่างกันแค่ 6 ถึง 8% เพราะเมื่อชนเพดานแล้วทั้งสอง backend ต้องรอความเร็วหน่วยความจำเท่ากันพอดี ไม่มีช่องว่างให้ฝ่ายใดแซงหน้า
และนี่ไม่ใช่เรื่องของ GPU Clock เพราะระหว่างการ decode MoE ของ Qwen3.6 บน ROCm shader clock เฉลี่ยอยู่ที่ 3,307 MHz ซึ่งสูงที่สุดในแทบทุกสภาวะที่ทดสอบ ขณะที่ Vulkan ในงานเดียวกันมี clock เฉลี่ยเพียง 3,192 MHz แต่กลับเร็วกว่าถึง 51% ทั้งที่ GPU Clock ต่ำกว่า หากเป็นเพียงเรื่องความถี่สัญญาณนาฬิกา ความต่างจะไม่มีทางถึงขนาดนี้ จึงสรุปได้ว่าสาเหตุที่แท้จริงคือคุณภาพของ code path ใน kernel ทั้ง GEMM ที่ใช้ใน prefill และ GEMV ที่ใช้ใน decode รวมถึงวิธีจัดกลุ่มคำสั่ง MMA และการจัดลำดับการเข้าถึงหน่วยความจำ ซึ่ง ROCm 10.0.0 เวอร์ชันปัจจุบันยังทำได้ไม่ดีเท่า ACO compiler ของ RADV ในงานที่ compute มีมากกว่าการอ่านหน่วยความจำ ส่วนงานแบบ memory-bound นั้นทั้งสอง backend ถูกจำกัดด้วย bandwidth ตัวเดียวกัน จึงจบลงที่ความเร็วใกล้เคียงกันในช่วง 460 ถึง 490 GiB/s เสมอ ไม่ว่าจะโมเดลใด
การใช้พลังงาน และความร้อน
ตัวเลขต่อไปนี้มาจาก telemetry ระดับ 1 Hz ตลอดทั้งการทดสอบโดยวัด GPU package power ของทั้งการ์ดครับ เป็นค่าที่อ่านมาจากซอฟต์แวร์ที่ตัวการ์ดรายงานออกมาโดยตรง
| โมเดล หรือโหมด | ไฟเฉลี่ยตอน decode (W) | พลังงาน J/token | หมายเหตุ |
|---|---|---|---|
| Qwen3.8-27B dense บน ROCm/Vulkan | 296 / 300 | 10.3 / 10.1 | ใช้สูงสุดในชุด |
| Gemma-4-31B dense | 285 / 290 | 10.7 / 10.3 | ใช้สูงเช่นกัน |
| Gemma-4-12B | 255 / 281 | 4.4 / 4.6 | กลาง |
| Gemma-4-26B-A4B MoE | 215 / 231 | 2.4 / 1.9 | ดีมาก |
| Qwen3.6-35B-A3B MoE | 223 / 210 | 2.6 / 1.7 | ดีที่สุด |
| Qwen3.8-27B กับ speculative | 286 / 286 | 5.4 ถึง 6.8 | ดีขึ้น 1.6 ถึง 1.9 เท่าจาก decode ล้วน |
ข้อมูลการใช้พลังงานเผยให้เห็นพฤติกรรมสี่เรื่องที่ตัวเลขความเร็ว tok/s เพียงอย่างเดียวไม่เพียงพอสำหรับวิเคราะห์การใช้งานการ์ดจอในงาน Local AI
เรื่องแรก โมเดล dense ขนาด 27 ถึง 31B ใช้พลังงานชนเพดาน power cap ที่ 300 W ตลอดทั้งงาน เช่น ROCm กับ Qwen3.8 ใช้พลังงานเฉลี่ย 296.5 W อุณหภูมิ junction เฉลี่ย 83.7 องศาเซลเซียสและขึ้นถึง 91 องศาในงาน summary_8k แต่สิ่งที่น่าสังเกตคือ shader clock ยังคงอยู่ที่ราว 3,000 MHz โดยไม่มีสัญญาณของการ throttle เลย แสดงว่าการ์ดนี้ถูกออกแบบมาให้ระบายความร้อนที่ 300 W ต่อเนื่องได้จริง โดยพัดลมหมุนที่ประมาณ 2,000 rpm ซึ่งพอได้ยินเสียงดังพอควรในห้องที่เงียบ
เรื่องที่สอง MoE เร็วกว่า dense ถึง 4.5 เท่า และยังใช้พลังงานเฉลี่ยน้อยกว่าราว 30% ด้วย ผลรวมการใช้พลังงานต่อโทเค็นต่างกันมาก คือ 1.7 J/token เทียบกับ 10.3 J/token ความได้เปรียบนี้ไม่ได้มาจากการ์ดที่แรงขึ้น แต่มาจากการเลือกโมเดลที่ใช้ทรัพยากรต่อโทเค็นต่ำกว่าอย่างมีนัยสำคัญ
เรื่องที่สาม ขั้น prefill ทำให้พลังงานพุ่งขึ้นเป็น spike ได้ถึง 300 ถึง 408 W โดยจุดสูงสุดพบใน Vulkan กับ Qwen3.8 ในงาน summary_8k ทั้งที่ค่าเฉลี่ยของงานเดียวกันอยู่ที่เพียง 271 W หากงานของคุณมี prefill ยาวและเกิดซ้ำ ๆ การคำนวณขนาด PSU หรือ UPS ควรอิงจากค่า spike สูงสุด ไม่ใช่ค่าเฉลี่ย (งานนี้ต้องขอบคุณ Thermaltake ที่ส่ง PSU 1200W ตัวแรงมาให้เราได้ใช้งานร่วมกับ GPU รุ่นนี้ได้ทันเวลาพอดี)
เรื่องที่สี่ speculative decoding เป็นตัวอย่างที่ชัดเจนที่สุด ความเร็วเพิ่มขึ้น 1.5 ถึง 1.9 เท่า พร้อมกับ J/token ที่ลดลงทันทีจาก 12.5 เหลือ 6.8 เพราะต้นทุนของ forward pass ที่ใช้ทรัพยากรสูงถูกแบ่งใช้กับหลายโทเค็นพร้อมกัน แม้ draft model จะเพิ่มภาระงานเล็กน้อย แต่ค่า GPU กลับลดลงจาก 97~98% เหลือประมาณ 91~94% เท่านั้น เพราะการ์ดยังมีกำลังเหลือพอให้ใช้งานในส่วนนี้
การทดสอบแบบหลายผู้ใช้พร้อมกัน
การทดสอบนี้คือการจำลองให้มีผู้ใช้งานหลายคนส่ง prompt ไปพร้อม ๆ กันตั้งแต่ C1 คือหนึ่งคน ไปจนถึง C8 คือ 8 คน โดยตั้ง context รวมไว้ที่ 32,768 หรือ 4,096 ต่อผู้ใช้, ใช้เวิร์คโหลดสรุปเนื้อหา ซึ่งมี input 2K ตอบจำกัดที่ 256 token, ทดลอง 5 รอบ ต่อจำนวนผู้ใช้
| โมเดลและ Backend | C1 รวม | C2 | C4 | C8 | Scaling ที่ C8 | Efficiency ที่ C8 | ต่อผู้ใช้ที่ C8 (tok/s) | TTFT p50 | TTFT p95 |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B ROCm | 71.4 | 105.7 | 138.5 | 148.9 | 2.08 เท่า | 26% | 31.5 | 5.33 s | 6.81 s |
| Qwen3.6-35B-A3B Vulkan | 101.7 | 132.6 | 155.9 | 168.1 | 1.65 เท่า | 21% | 38.3 | 5.18 s | 6.60 s |
| Qwen3.8-27B ROCm | 23.8 | 34.6 | 44.1 | 46.4 | 1.95 เท่า | 24% | 9.5 | 15.88 s | 20.72 s |
| Qwen3.8-27B Vulkan | 25.4 | 38.1 | 50.0 | 55.9 | 2.20 เท่า | 28% | 13.3 | 16.21 s | 20.97 s |
ตารางต่อไปแสดงรายละเอียดทุกระดับผู้ใช้พร้อมกันจำนวน 1-8 ช่วยให้เห็นว่าความเร็วต่อผู้ใช้ (C, Concurrent) พลังงานต่อโทเค็น และ VRAM ขยับอย่างไรเมื่อเพิ่มระดับการทำงานพร้อมกัน
| โมเดล | Backend | C | agg tok/s | user decode | user prefill | TTFT p50 | TTFT p95 | J/token | W | VRAM |
|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B | Vulkan | 1 | 101.7 | 132.9 | 3,458 | 601 | 707 | 2.10 | 214 | 21.2 GiB |
| Qwen3.6-35B-A3B | Vulkan | 2 | 132.6 | 102.0 | 1,669 | 1,374 | 1,518 | 1.62 | 215 | 21.2 GiB |
| Qwen3.6-35B-A3B | Vulkan | 4 | 155.9 | 72.4 | 805 | 2,916 | 3,201 | 1.50 | 234 | 21.2 GiB |
| Qwen3.6-35B-A3B | Vulkan | 8 | 168.1 | 38.3 | 471 | 5,175 | 6,604 | 1.39 | 234 | 21.2 GiB |
| Qwen3.6-35B-A3B | ROCm | 1 | 71.4 | 87.1 | 3,165 | 657 | 659 | 3.08 | 220 | 21.6 GiB |
| Qwen3.6-35B-A3B | ROCm | 2 | 105.7 | 75.6 | 1,560 | 1,435 | 1,487 | 2.13 | 225 | 21.6 GiB |
| Qwen3.6-35B-A3B | ROCm | 4 | 138.5 | 59.1 | 778 | 2,963 | 3,268 | 1.71 | 237 | 21.6 GiB |
| Qwen3.6-35B-A3B | ROCm | 8 | 148.9 | 31.5 | 447 | 5,331 | 6,813 | 1.69 | 251 | 21.6 GiB |
| Qwen3.8-27B | Vulkan | 1 | 25.4 | 31.7 | 1,022 | 2,023 | 2,026 | 11.68 | 297 | 18.6 GiB |
| Qwen3.8-27B | Vulkan | 2 | 38.1 | 28.7 | 493 | 4,566 | 5,051 | 7.27 | 277 | 18.6 GiB |
| Qwen3.8-27B | Vulkan | 4 | 50.0 | 23.3 | 243 | 9,249 | 10,090 | 5.43 | 271 | 18.6 GiB |
| Qwen3.8-27B | Vulkan | 8 | 55.9 | 13.3 | 140 | 16,209 | 20,972 | 4.74 | 265 | 18.6 GiB |
| Qwen3.8-27B | ROCm | 1 | 23.8 | 29.4 | 990 | 2,087 | 2,094 | 12.48 | 297 | 18.9 GiB |
| Qwen3.8-27B | ROCm | 2 | 34.6 | 25.1 | 480 | 4,553 | 4,697 | 8.43 | 292 | 18.9 GiB |
| Qwen3.8-27B | ROCm | 4 | 44.1 | 18.6 | 243 | 9,072 | 9,948 | 6.43 | 283 | 18.9 GiB |
| Qwen3.8-27B | ROCm | 8 | 46.4 | 9.5 | 141 | 15,879 | 20,721 | 6.04 | 280 | 18.9 GiB |
(workload = สรุป prompt 2K, ตอบ 256 token · ตัวเลขเป็น median ของ 5 รอบ ต่อระดับ)
จากผลการทดสอบนี้นี้มีเจ็ดเรื่องที่ควรวิเคราะห์ (ประเด็นเยอะจัด)
เรื่องที่หนึ่ง C4 คือจุดสมดุลที่ดีที่สุดของทั้งสองโมเดล เพราะได้ throughput รวมเพิ่มขึ้นราว 1.9 เท่า ขณะที่ยังรักษาความเร็วต่อผู้ใช้ไว้ได้ 54 ถึง 68% ของตอนใช้งานคนเดียว ส่วน C8 จะเอียงไปทาง throughput ล้วน ๆ เพราะความเร็วต่อผู้ใช้เหลือเพียง 29 ถึง 42% เท่านั้น หากต้องการรักษาระดับ 30 tok/s ต่อผู้ใช้ ไม่ควรเปิดใช้งานถึงแปด slot พร้อมกัน
เรื่องที่สอง ความเร็ว prefill ต่อผู้ใช้ลดลงเหลือเพียงหนึ่งในเจ็ดทันทีที่ C8 คือจาก 3,165 ลดเหลือ 447 tok/s บน Qwen3.6 ด้วย ROCm เพราะต้องแย่งใช้ compute ของขั้นตอน GEMM ร่วมกัน การทำ batching ไม่ได้ทำให้คำขอแต่ละรายการเสียเปรียบน้อยลง แต่เป็นการย้ายภาระจากต่อผู้ใช้ไปเป็นภาพรวม (aggregate) แทน
เรื่องที่สาม tail latency เป็นหลักฐานของการรอคิว โดย TTFT ที่ p95 ห่างจาก p50 ประมาณ 30% ในทุกคอนฟิกูเรชัน เช่น Qwen3.8 บน ROCm มี p50 อยู่ที่ 15.88 วินาที แต่ p95 ขยับขึ้นไปถึง 20.72 วินาที เมื่อ slot เต็มทุกช่อง คำขอจะต้องรอคิวกันเองแบบเรียงลำดับ ดังนั้นหากจะตั้งค่าระบบเพื่อรองรับผู้ใช้หลายคนก็ควรอิงจากค่า p95 ไม่ใช่ p50
เรื่องที่สี่ batching ยังเป็นเครื่องมือประหยัดพลังงานด้วย เพราะ J/token ที่ C8 ลดลงอย่างสม่ำเสมอเมื่อเทียบกับ C1 เช่น Qwen3.8 บน ROCm ลดจาก 12.5 เหลือ 6.0 คือลดลง 52% และ Qwen3.6 บน Vulkan ลดจาก 2.1 เหลือ 1.4 เพราะน้ำหนักของโมเดลถูกอ่านจาก DRAM เพียงครั้งเดียวแล้วนำไปใช้ร่วมกันระหว่างผู้ใช้หลายคน การเพิ่มความหนาแน่นของงานจึงเท่ากับการแบ่งเฉลี่ยต้นทุนการอ่าน DRAM ให้ต่ำลง
เรื่องที่ห้า การตรวจสอบไขว้ระหว่างชุดทดสอบพบว่าความเร็ว decode ต่อผู้ใช้ที่ C1 ตรงกับตัวเลขหลักของชุดมาตรฐานในช่วง 1 ถึง 2% เช่น Qwen3.6 บน Vulkan ได้ 132.9 เทียบกับ 134.9 tok/s ยืนยันว่าวิธีวัดทั้งสองชุดให้ผลสอดคล้องกัน
เรื่องที่หก VRAM ไม่ใช่ข้อจำกัดในกรณีนี้ เพราะ C8 ใช้พื้นที่เพียง 21.2 ถึง 21.6 GiB สำหรับโมเดลขนาด 19.7 GiB บวกกับ C8 เนื่องจาก context 4K ต่อผู้ใช้ค่อนข้างสั้น ทำให้ KV cache ใช้พื้นที่น้อย และ 32 GiB ยังเหลือเพียงพอ แต่หากเพิ่มจำนวน slot มากกว่านี้ ความเร็วต่อผู้ใช้จะยิ่งถูกแบ่งลงไปเรื่อย ๆ
เรื่องที่เจ็ด มีหมายเหตุเรื่องการวัดที่ควรบอกไว้ คือค่า CV (ความผันผวน) ของ aggregate throughput บน Vulkan ที่ C8 อยู่ที่ 3.31% ซึ่งเกินเกณฑ์ 3% ไปเพียงเล็กน้อย สอดคล้องกับความแปรปรวนที่กล่าวถึงในหัวข้อที่ 3 แต่คำขอทั้ง 20 รายการสำเร็จครบ ไม่มี error เกิดขึ้นเลย
สิ่งที่อยากทดสอบต่อและผลทดสอบชุดนี้ยังไม่ตอบ
เพื่อความตรงไปตรงมา บทความนี้ยังไม่ได้ตอบคำถามหลายข้อสำหรับผู้ใช้ที่ออกแบบระบบอาจอยากรู้ เพราะอยู่นอกขอบเขตของชุดข้อมูลที่ทดสอบในครั้งนี้ เนื่องจากโปรแกรมทดสอบอย่าง PromptMark ผมออกแบบมาสำหรับการ์ดเกมมิ่งทั่วไประดับ VRAM 16GB จึงจำกัด context ไว้ที่ 8K เท่านั้น ส่วนการ์ดระดับ Pro ที่มี VRAM 32GB ทำงานกับ context ยาวกว่านี้ได้ ซึ่งเราจะทดสอบแยกในบทความถัดไป ผลในบทความนี้จึงบอกพฤติกรรมที่ context ไม่เกิน 8K เท่านั้น
ประการแรก หากลดเพาเวอร์แคปจาก 300 W ลงมาเป็น 250 หรือ 200 W เส้นกราฟ efficiency จะเปลี่ยนไปอย่างไร เพราะ MoE ดูเหมือนยังมีช่องว่างให้ลดพลังงานได้โดยที่ throughput อาจไม่ลดลงตาม เรื่องนี้น่าจะคุ้มค่าแก่การทดสอบเพิ่มเติม (ในเบื้องต้นผมลองปรับดูเล่น ๆ พบว่าการลดการใช้พลังงานไม่ทำให้ประสิทธิภาพลดลง แต่เดี๋ยวต้องไปเก็บข้อมูลอย่างเป็นทางการก่อนครับว่าปรับลงแค่ไหนถึงจะไม่กระทบต่อเสถียรภาพและประสิทธิภาพการทำงาน)
ประการที่สอง โมเดลขนาด 70B ในระดับการบีบอัด Q2 หรือ Q3 บางรุ่นหากสามารถใส่ลงใน 32 GiB ได้ จะคุ้มค่าแค่ไหน ข้อควรจำคือ active bytes ต่างหากที่เป็นตัวกำหนดผลลัพธ์จริง R9700 อาจทำได้ดีกว่าที่ประเมินจากขนาดไฟล์เพียงอย่างเดียว
ประการที่สาม การทดสอบที่ context ยาวขึ้นถึง 32K หรือ 64K เพื่อดูผลกระทบของ KV cache ต่อ bandwidth ในเมื่อที่ 8K decode ช้าลงแล้ว 3 ถึง 6% จึงน่าสนใจว่าจะแย่ลงอีกเท่าไรเมื่อ context ยาวขึ้นกว่านี้ (การเพิ่ม context หรือเวิร์คโหลดให้ใหญ่ขึ้นเราต้องไปออกแบบอีกครับว่าควรจะเป็นแบบใด Code, เนื้อหา หรือมีเนื้อหาพร้อมรูปสำหรับโมเดลที่รองรับ VL ด้วย เป็นโจทย์ใหญ่ที่ต้องทดสอบก่อนผมจึงไม่ได้รีบใส่แค่เวิร์คโหลดที่มากขึ้นมาในทันทีระหว่างการทดสอบนี้ครับ)
ประการที่สี่ การทดสอบไล่ขนาด draft model อย่างเป็นระบบ รวมถึงการเปิดปิด speculative decoding แบบไดนามิกตามลักษณะของแต่ละคำขอ ซึ่งตอนนี้เรารู้แล้วผลการทดสอบเบื้องต้น speculative เพิ่มประสิทธิภาพให้เราได้ แต่ก็ไม่ถึงกับฟรี เพราะต้องแลกกับ prefill ที่ช้าลง แต่ยังไม่รู้ว่าขนาด draft model เท่าไรในหน่วย VRAM จึงจะคุ้มค่าที่สุด (น่าจะเป็นการคุมในการทดสอบที่ยากเหมือนกัน และผมก็ยอมรับตรง ๆ ว่ายังคิดไม่ออก แต่ถ้าเป็นการใช้งานแบบผู้ใช้คนเดียวเรื่องพวกนี้ก็ไม่ใช่ประเด็นสำคัญนัก)
ประการที่ห้า การทดสอบกับ ROCm เวอร์ชันใหม่กว่า 10 เพราะผลการทดสอบชุดนี้ชี้ชัดว่า kernel คือคอขวดสำคัญ หากมีเวอร์ชันที่ปรับปรุง kernel มาแล้ว ROCm อาจไล่ตามทันหรือเทียบเท่า Vulkan (RADV) ได้ในเงื่อนไขเดียวกัน (อันนี้คงต้องรออีกนานเพราะ ROCm 10 เพิ่งออกและมีเวอร์ชันย่อย ROCm 10.1.0 ซึ่งเป็นการแก้บักเล็กน้อยยังไม่ใช่การปรับใหญ่) แต่เบื้องต้นถ้าต้องการความเสถียรผมก็คิดว่า ROCm ยังเป็นตัวเลือกที่เหมาะกว่า Vulkan แล้วแอปพลิเคชันในระดับอุตสาหกรรมก็เลือกที่จะปรับปรุงร่วมกับ ROCm เป็นหลักมากกว่า
และอีกประการก็คือ…หลายคนอยากรู้ว่า Radeon AI Pro R9700 นั้นทำงานพวกเจนรูปเจนวิดีโอได้ไหม คำตอบคือทำได้ครับ และก็ไม่ได้ช้าด้วย ขึ้นอยู่กับการปรับแต่งเวิร์คโฟลว์และการเลือกโมเดลที่ใช้งานด้วยครับ ซึ่งตรงนี้ ถ้าจะเอาแบบบอกเล่าประสบการณ์ก็ทำได้ไม่ยาก แต่ถ้าจะให้เก็บคะแนนแบบเป็นมาตรฐาน ขอเวลาออกแบบชุดทดสอบให้นิ่งอีกสักนิดครับ เพราะถ้าทำผิดกลายเป็นว่าผมสร้างความเสียหายและส่งต่อความเข้าใจผิดให้กับผู้อ่านครับ ซึ่งเป็นเรื่องที่ไม่สมควร เอาเป็นว่าขอเล่าส่วนนี้ไว้นิดหน่อยก่อนก็แล้วกันครับ
ผลการทดสอบ ComfyUI เบื้องต้น
ComfyUI เป็นเครื่องมือหลักในการทดสอบการสร้างภาพและวิดีโอ ซึ่งทดสอบผ่าน PyTorch ROCm Backend บนสถาปัตยกรรม RDNA 4:
Stable Diffusion XL (SDXL 1.0)
- การตั้งค่า: ความละเอียด 1024×1024 พิกเซล, Euler a Sampler, 30 Steps, CFG 7.0
- ผลทดสอบ:
- Generation Time per Image: ประมาณ 2.8 – 3.4 วินาที (~9.5 – 11.0 it/s)
- Batch Processing (Batch Size 4): ใช้เวลาเพียง 9.8 วินาที สำหรับ 4 ภาพพร้อมกัน โดย VRAM ถูกใช้ไปราว 14.5 GB
FLUX.1 (FLUX Dev & FLUX Schnell)
- การตั้งค่า: FLUX.1 Dev (FP8 / NF4), ความละเอียด 1024×1024 พิกเซล, 25 Steps
- ผลทดสอบ:
- Generation Time: เฉลี่ย 14 – 18 วินาทีต่อภาพ
- ข้อได้เปรียบ: โมเดลตระกูล FLUX มีขนาดไฟล์ใหญ่มาก (รวม Clip/T5 encoder มักใช้ VRAM เกิน 20GB) การ์ด 32GB อย่าง R9700 จึงสามารถโหลดโมเดลทั้งหมดเข้า VRAM ได้ครบโดยไม่ต้องแบ่ง Memory Swap ไปที่ RAM ของระบบ ลด Latency ของแต่ละ Step ลงได้อย่างชัดเจน
ภาพรวมเรื่อง Local LLM
หากงานของคุณตรงกับเงื่อนไขเหล่านี้ Radeon AI Pro R9700 ก็ถือว่าทำงานได้ดีเกินคาด เช่น ผู้ใช้คนเดียวรันโมเดล MoE ระดับ 30B ถึง 35B ที่ต้องการทั้งความเร็วในการตอบและ throughput ต่อวัตต์ Qwen3.6-35B-A3B บน Vulkan ให้ความเร็ว decode 134.9 tok/s, TTFT ที่ context 4K เพียง 1.27 วินาที และพลังงานเพียง 1.7 J/token ซึ่งเป็นชุดผลลัพธ์ที่เทียบเคียงได้กับการ์ดระดับ data center ราคาสูง ด้านความร้อนก็ไม่มีปัญหา แม้ใช้งานต่อเนื่องที่ 300 W เต็มพิกัด junction อุณหภูมิสูงสุดอยู่ที่ 91 องศา (Peak ช่วงเวลาสั้น ๆ) แต่เสียงพัดลมจะดังหน่อยตามสไตล์ของการ์ดจอแนวนี้
หากงานของคุณต้องใช้โมเดล dense ขนาด 27 ถึง 31B ต้องทำใจกับข้อแลกเปลี่ยนไว้ก่อน เพราะความเร็วแบบ single-stream สูงสุดอยู่ที่เพียง 31.8 tok/s (ซึ่งจริง ๆ มันก็ไม่ได้ช้าอะไรนะ) และหากเปิดใช้ speculative decoding ก็สามารถเพิ่มไปได้ถึง 58.9 tok/s แต่ควรทดสอบด้วย draft model ของตัวเองก่อน เพราะผลลัพธ์ที่ได้อาจแตกต่างจากชุดนี้
หากงานของคุณคือบริการให้ทีมขนาดเล็กรองรับผู้ใช้หลายคน จุดที่ให้ผลลัพธ์ดีที่สุดคือระดับ C4 บน Qwen3.6-35B-A3B ด้วย ROCm ซึ่งให้ throughput รวม 138.5 tok/s และต่อผู้ใช้ประมาณ 59 tok/s ทั้ง aggregate scaling ที่ 1.9 เท่า J/token ที่ 1.7 และ TTFT p95 ที่ 3.27 วินาที ยังถือว่าตอบสนองได้ดี หากต้องการเปิดใช้ C8 ก็ทำได้ แต่ต้องยอมรับว่าความเร็วต่อผู้ใช้จะเหลือเพียง 31.5 tok/s และ p95 ขยับเป็น 6.81 วินาที พร้อมกับ tail latency ที่แย่ลงแม้ภาพรวมจะโตขึ้นก็ตาม การบริหารจัดการคิวอย่างเข้าใจจึงสำคัญกว่าแค่การเปิด slot ให้มากที่สุด แต่ก็มีเงื่อนไขอีกนั่นแหละเพราะการทดสอบนี้ใช้ llama.cpp เป็นตัว inference หากเปลี่ยนเป็น vLLM ซึ่งออกแบบมาเพื่องานที่รองรับหลายผู้ใช้โดยเฉพาะก็อาจจะให้ผลที่ต่างกันก็ได้ ซึ่งเราก็กำลังทดสอบและเก็บผลอยู่ครับ
จุดแข็งที่เห็นชัดคือการที่ compute มีมากกว่า memory อย่างมีนัยสำคัญ ทำให้มีหลายช่องทางที่จะปลดล็อกประสิทธิภาพผ่านสถาปัตยกรรม ไม่ว่าจะเป็น MoE, การใช้ draft model หรือ batching นอกจากนี้ Vulkan ยังเร็วกว่า ROCm อย่างสม่ำเสมอ และ VRAM ขนาด 32 GB ก็เหมาะพอดีกับโมเดลขนาด 30B ระดับการบีบอัด Q4 ในรูปแบบ single GPU, single node ที่ไม่ต้องยุ่งกับการเชื่อมต่อแบบ Multi-GPU
บทสรุปแรกของ Radeon AI Pro R9700
คุณค่าที่แท้จริงของการ์ดใบนี้คือ ความยืดหยุ่นและพื้นที่ VRAM ขนาด 32GB ที่ราคาเข้าถึงง่ายสุดในเวลานี้ และหากคุณต้องการความเร็ว ตัวการ์ดสามารถพาโมเดล MoE ขนาด 35B วิ่งทะลุ 90-135 tokens/s ได้อย่างง่ายดายด้วยพลังงานที่ประหยัด และในขณะเดียวกัน หากงานของคุณต้องการตรรกะระดับลึกที่ละเอียดอ่อนจากโมเดล Dense VRAM 32GB ก็พร้อมกางแขนรับโมเดลเหล่านี้โดยไม่ขัดข้อง พร้อมเครื่องมืออย่าง Speculative Decoding ที่ช่วยดันความเร็วให้ใช้งานได้จริง
ด้วยตัวเลือกซอฟต์แวร์สแต็คที่ครบครันทั้ง ROCm เพื่อความเสถียรสำหรับงานวิจัย และ Vulkan เพื่อรีดความเร็วสำหรับการใช้งานจริง ดังนั้นการลงทุนกับ AMD Radeon AI Pro R9700 ก็ถือว่าเป็นการลงทุนทางฮาร์ดแวร์ที่มีจุดสมดุลดีพอสมควรในสถานการณ์แบบนี้ ซึ่งมันสามารถใช้ได้ดีสำหรับนักพัฒนา ครีเอเตอร์ และใช้ในเวิร์กสเตชันส่วนตัวหรือในองค์กรก็ได้เช่นกัน
หลายคนก็อาจจะเคยได้ยินมาบ้างว่าใช้ GPU ของเอเอ็มดีหาซอฟต์แวร์รองรับยาก นั่นก็ต้องบอกว่าเป็นเรื่องของเมื่อก่อนครับเพราะตอนนี้เอเอ็มดีเองก็ได้ปรับปรุงเรื่องพวกนี้มาพอสมควรแล้ว ถ้าใครสนใจก็สามารถเข้าไปดูเรื่องการรองรับซอฟต์แวร์ของ GPU ในด้าน AI ได้จากหน้า AMD AI Playbooks ได้เลยครับจะทำให้เรามองเห็นภาพรวมว่าจริง ๆ เอเอ็มดีเองก็มาไกลมากแล้วทางด้านซอฟต์แวร์
อย่างที่บอกครับว่าการทดสอบของเรายังไม่อีกหลายเรื่องที่ต้องมาตอบคำถาม ก็ฝากติดตามเว็บไซต์ aipcmag.com ไว้ด้วยครับหรือจะไปพูดคุยกับผมในเพจ #ลุงจุ้ยคุยเรื่องคอม ก็ได้เช่นกันครับ