Context Window และ KV Cache: ทำไมบริบทยาวขึ้นจึงกินหน่วยความจำมากขึ้น
สองค่าที่คนรัน Local AI มักสับสนคือ Context Window กับ KV Cache ทั้งคู่เกี่ยวกับ “บริบท” แต่ทำหน้าที่ต่างกัน และส่งผลต่อหน่วยความจำกับความเร็วคนละแบบ การเข้าใจความต่างนี้ช่วยให้คุณตั้งค่าโมเดลให้พอดีกับเครื่องได้โดยไม่ต้องเดา
Context window คืออะไร
หัวข้อที่มีชื่อว่า “Context window คืออะไร”Context window คือ จำนวนโทเคนสูงสุดที่โมเดลรับและประมวลผลได้ (ในหนึ่งเซสชัน) นับรวมทั้งข้อความนำเข้า (prompt) และข้อความที่โมเดลสร้างตอบกลับ (output)
ถ้าโมเดลรองรับ context windows สูงสุด 32,000 โทเคน แต่คุณใส่เอกสาร 50,000 โทเคน ระบบจะต้องตัดข้อมูลทิ้งหรือแบ่งเป็นหลายรอบ สิ่งสำคัญคือ context ที่กว้างขึ้นไม่ได้หมายความว่าโมเดลจะใช้ข้อมูลทุกส่วนได้เท่ากัน งานวิจัยเรื่อง Lost in the Middle พบว่าโมเดลมักดึงข้อมูลที่อยู่ต้นและท้ายเอกสารได้ดีกว่าข้อมูลตรงกลาง
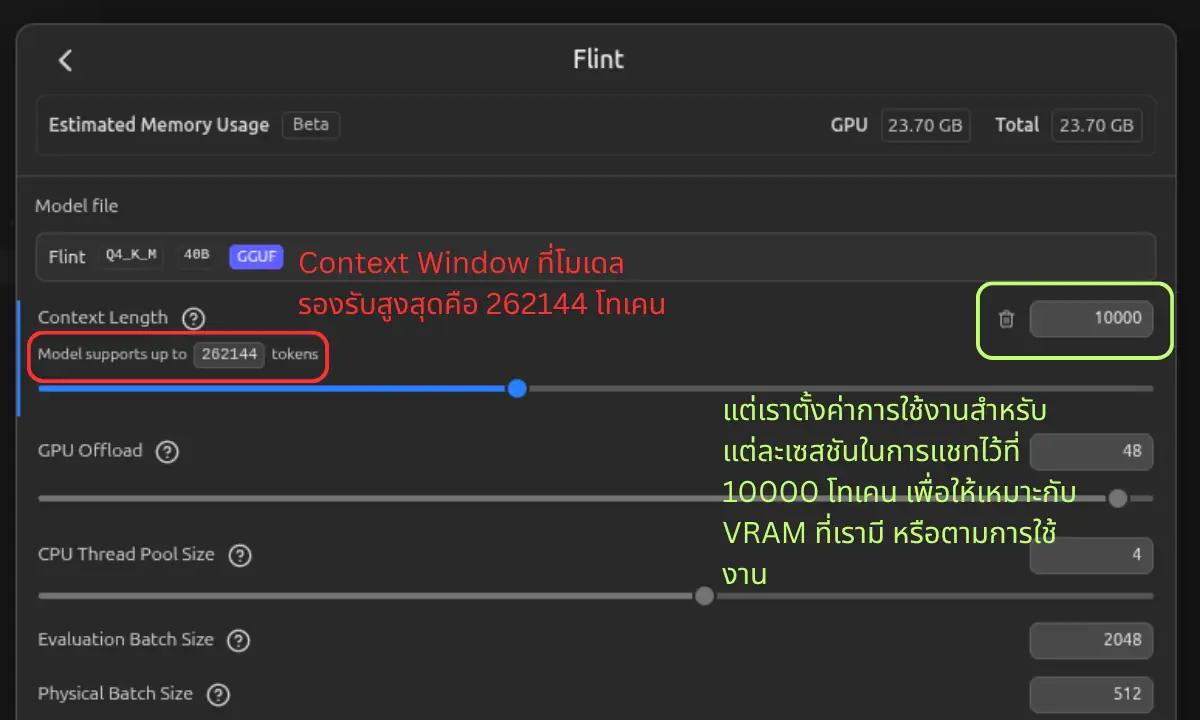
โมเดลทั่วไปที่เราดาวน์โหลดมาใช้งานมักจะมีขนาด Context Windows อยู่ราว 120,000 - 250,000 โทเคน แต่ในการใช้งานจริงบนเครื่องที่มี VRAM จำกัดเราอาจจะตั้งค่า Context ในระหว่างเซสชันไว้ที่ 20,000 โทเคนก็ได้ แต่ว่าตัวเลขพวกนี้ก็ไม่ได้มีค่าตายตัวว่าควรกำหนดเท่าไร ขึ้นอยู่กับการจัดสรรทรัพยากรของระบบเป็นหลัก
KV Cache คืออะไร
หัวข้อที่มีชื่อว่า “KV Cache คืออะไร”ตอนโมเดลสร้างข้อความ มันจะประมวลผลโทเคนที่ผ่านมาเพื่อ “จำ” บริบท การคำนวณซ้ำทุกครั้งจะช้ามาก จึงต้องเก็บผลลัพธ์ที่คำนวณแล้วไว้ในหน่วยความจำ เรียกว่า KV Cache (Key–Value Cache)
พูดง่าย ๆ KV cache ก็คือ ความจำชั่วคราวของบริบทที่โมเดลกำลังอ่านอยู่ เมื่อบริบทยาวขึ้น จำนวนโทเคนที่ต้องจำก็เพิ่มขึ้น หน่วยความจำที่ใช้จึงโตตาม (แต่ในทางปฏิบัติ ระบบมักจะจองเป็นค่าคงที่ในหน่วยความจำไว้ก่อนแม้จะยังไม่มีการใช้งานก็ตาม)
ขนาด KV Cache คิดจากอะไร
หัวข้อที่มีชื่อว่า “ขนาด KV Cache คิดจากอะไร”ขนาด KV cache ขึ้นกับหลายตัวแปร:
KV Cache (bytes) ≈ 2 × layers × kv_heads × head_dim × seq_len × batch × bytes_per_value2คือเก็บทั้ง Key และ Valuelayers,kv_heads,head_dimเป็นคุณสมบัติสถาปัตยกรรมของโมเดลseq_lenคือความยาวบริบทที่ใช้จริงbatchคือจำนวนคำขอที่ประมวลผลพร้อมกันbytes_per_valueคือความละเอียดที่เก็บ cache (เช่น 2 สำหรับ FP16)
ตัวอย่างสมมติ (ตัวเลขเพื่อสาธิตการคำนวณ): โมเดลหนึ่งมี 48 layers, 8 KV heads, head_dim 128 เปิด context 32768 โทเคน ที่ batch 1 และเก็บ KV cache แบบ FP16 จะได้
2 × 48 × 8 × 128 × 32768 × 1 × 2 ≈ 6.4 GBเพียง KV cache อย่างเดียวก็กินหลาย GB แล้ว ซึ่งเป็นเหตุผลว่าทำไม “เปิด context ยาว” ถึงไม่ใช่แค่เรื่องของขนาดไฟล์โมเดล
GQA ช่วยลด KV Cache ได้อย่างไร
หัวข้อที่มีชื่อว่า “GQA ช่วยลด KV Cache ได้อย่างไร”โมเดลรุ่นใหม่มักใช้ Grouped-Query Attention (GQA) ซึ่งลดจำนวน KV heads ลงเมื่อเทียบกับ Query heads ทำให้ KV cache เล็กลงหลายเท่าโดยเสียคุณภาพเพียงเล็กน้อย วิธีนี้เป็นสาเหตุที่โมเดลขนาดใหญ่สมัยใหม่เปิด context ยาวได้โดยไม่กินหน่วยความจำมากเกินไป
อีกแนวทางหนึ่งคือเก็บ KV cache ที่ความละเอียดต่ำลง (เช่น Q8 หรือ Q4) ซึ่งเครื่องมืออย่าง llama.cpp รองรับ และช่วยประหยัดหน่วยความจำได้อีกชั้น
การใช้งานจริง
หัวข้อที่มีชื่อว่า “การใช้งานจริง”- ตั้ง context ให้พอดีงาน อย่าเปิด 128K ถ้าจริง ๆ ใช้ไม่ถึง เพราะ KV cache จะกิน VRAM เปล่า ๆ
- คำนึงถึง batch ถ้าให้บริการหลายคำขอพร้อมกัน KV cache จะคูณตามจำนวน batch
- ลดความละเอียด KV cache เมื่อหน่วยความจำมีจำกัด เราอาจจะต้องลดความละเอียดของ KV Cache โดยยอมแลกกับความแม่นยำที่ลดลงเล็กน้อย
- ดูสถาปัตยกรรมโมเดลว่ามี GQA และจำนวน kv_heads เท่าไร ซึ่งจะบอกได้ว่าโมเดลนั้นประหยัดหน่วยความจำแค่ไหน
ระบบที่ให้บริการ LLM จำนวนมากใช้เทคนิคจัดการ KV cache แบบแบ่งหน้า (PagedAttention) เพื่อลดการสูญเสียหน่วยความจำจากช่องว่างที่จองเกินแม้คุณจะรันในเครื่องเดียว หลักคิดเรื่อง “หน่วยความจำที่จองไว้แต่ใช้ไม่เต็ม” ก็ยังใช้ได้
สรุปความต่าง
หัวข้อที่มีชื่อว่า “สรุปความต่าง”| หัวข้อ | Context Window | KV Cache |
|---|---|---|
| คืออะไร | ขอบเขตโทเคนสูงสุดที่ประมวลผลได้ | ความจำชั่วคราวของบริบทที่อ่านอยู่ |
| กำหนดโดย | การตั้งค่าและความสามารถของโมเดล | การตั้งค่า + สถาปัตยกรรม + batch |
| กินหน่วยความจำ | ทางอ้อม ผ่าน KV cache | โดยตรง และโตตามบริบท |
| ปรับได้ที่ | --ctx-size และค่าคล้ายกัน |
จำนวนบิตของ cache, batch |
เมื่อเข้าใจว่าบริบทยาวทำให้ KV cache โต ขั้นถัดไปคือดูว่าการประมวลผล prompt กับการสร้างคำตอบใช้ทรัพยากรต่างกันอย่างไร อ่านต่อได้ที่ Prefill vs Decode: TTFT และ TPS ต่างกันอย่างไร