Strata 0.2.11 รองรับ Qwen3.8-Flash-Next จาก Unsloth Dynamic v3.1 ปรับปรุง Multi-GPU, NVIDIA CUDA, AMD Radeon และการจัดการ VRAM พร้อมแก้ไขปัญหาการบันทึก Chat และความเสถียร
Tag: KV Cache
- Strata 0.2.11 อัปเดต รองรับ Qwen3.8-Flash-Next รุ่นใหม่จาก Unsloth เพิ่มประสิทธิภาพ Multi-GPU และเร่งความเร็ว Prompt Processing
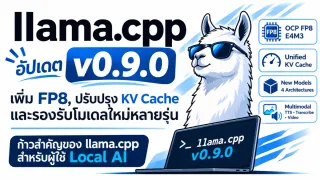
- llama.cpp v0.9.0 อัปเดต เพิ่มการรองรับ FP8, ปรับปรุง KV Cache และเร่ง Prefill ของ Gemma 4
llama.cpp v0.9.0 เพิ่มการรองรับ FP8 E4M3, ปรับปรุง Unified KV Cache, เพิ่มโมเดลใหม่ 4 สถาปัตยกรรม และขยายความสามารถด้าน Local AI และ Multimodal
- MAI-Code-1.1-Flash: โมเดล MoE 137.9B บีบเหลือ 53 GB รันบน Windows ด้วย RTX Spark
Microsoft เผยวิธีบีบโมเดลเขียนโค้ด MAI-Code-1.1-Flash จากประมาณ 276 GB เหลือ 53.0 GiB พร้อม speculative decoding และผลวัดบน RTX Spark 128GB (ผลวัดของ Microsoft ไม่ใช่ผลทดสอบของเรา)
- vLLM 0.33.0 อัปเดต เพิ่มประสิทธิภาพ รองรับ Qwen3.8-Flash-Next และปรับปรุง Multi-GPU บน CUDA และ ROCm
vLLM 0.33.0 อัปเดต PyTorch 2.14 เพิ่มการรองรับโมเดล AI รุ่นใหม่ ปรับปรุง Speculative Decoding, KV Cache และเพิ่มประสิทธิภาพ Inference บน NVIDIA และ AMD
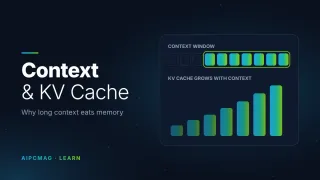
- Context Window และ KV Cache: ทำไมบริบทยาวขึ้นจึงกินหน่วยความจำมากขึ้น
อธิบาย Context Window และ KV Cache ว่าแต่ละอย่างคืออะไร ทำงานร่วมกันอย่างไร และเพราะเหตุใดการเปิดบริบทยาวจึงทำให้ VRAM เพิ่มขึ้นอย่างมีนัยสำคัญ
- รายงานผลการทดสอบ: NVIDIA GeForce RTX 5060 Ti 16GB กับการรัน Local LLM บน Windows — ประชัน CUDA vs Vulkan บน Dense 12B และ MoE 26B
ผลการทดสอบเชิงลึกการ์ดจอ NVIDIA GeForce RTX 5060 Ti 16GB (สถาปัตยกรรม Blackwell) ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ CUDA vs Vulkan บน Gemma-4 12B และทดสอบขีดจำกัดหน่วยความจำบน Gemma-4 26B-A4B MoE ในภาวะ VRAM-Tight
- รายงานผลการทดสอบ: AMD Radeon RX 9070 XT 16GB กับการรัน Local LLM บน Windows — ประชัน ROCm vs Vulkan บน 8 โมเดล LLM พร้อมทดสอบขีดจำกัด Concurrency
ผลการทดสอบเชิงลึกการ์ดจอ AMD Radeon RX 9070 XT 16GB (สถาปัตยกรรม RDNA 4) ด้วย PromptMark v0.4.0 และ Concurrent Text Benchmark เปรียบเทียบรันไทม์ ROCm vs Vulkan ทั้งโมเดล MoE, Dense และฟอร์แมตควอนไทซ์ NVFP4 พร้อมวัดประสิทธิภาพการรองรับผู้ใช้พร้อมกัน 16 ผู้ใช้
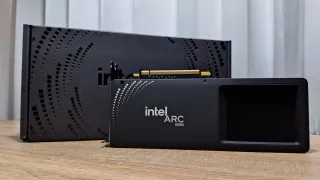
- รายงานผลการทดสอบ: Intel Arc B580 12GB กับการรัน Local LLM บน Windows (Vulkan vs SYCL)
ผลการทดสอบการ์ดจอ Intel Arc B580 12GB (สถาปัตยกรรม Xe2) ด้วย PromptMark เปรียบเทียบรันไทม์ Vulkan vs SYCL บน 5 รูปแบบโมเดล LLM พร้อมวิเคราะห์ Prefill, Decode และการสเกล Context 8K
- Context Window
จำนวน token สูงสุดที่โมเดลพิจารณาได้ในครั้งเดียว รวมทั้งสิ่งที่เราป้อนเข้าไปและคำตอบที่โมเดลสร้าง
- KV Cache
หน่วยความจำที่เก็บผลคำนวณระหว่างทางของ token ก่อนหน้า เพื่อไม่ต้องคำนวณซ้ำทุกครั้งที่สร้าง token ใหม่ และจะโตขึ้นตามความยาว context