Strata 0.2.11 รองรับ Qwen3.8-Flash-Next จาก Unsloth Dynamic v3.1 ปรับปรุง Multi-GPU, NVIDIA CUDA, AMD Radeon และการจัดการ VRAM พร้อมแก้ไขปัญหาการบันทึก Chat และความเสถียร
Tag: Multi-GPU
- Strata 0.2.11 อัปเดต รองรับ Qwen3.8-Flash-Next รุ่นใหม่จาก Unsloth เพิ่มประสิทธิภาพ Multi-GPU และเร่งความเร็ว Prompt Processing
- vLLM 0.33.0 อัปเดต เพิ่มประสิทธิภาพ รองรับ Qwen3.8-Flash-Next และปรับปรุง Multi-GPU บน CUDA และ ROCm
vLLM 0.33.0 อัปเดต PyTorch 2.14 เพิ่มการรองรับโมเดล AI รุ่นใหม่ ปรับปรุง Speculative Decoding, KV Cache และเพิ่มประสิทธิภาพ Inference บน NVIDIA และ AMD
- รันโมเดล 125B บนการ์ด Radeon AI PRO R9700 สองใบ (Qwen3.8-Flash-Next)
ทดสอบโมเดล MoE ขนาด 75.8 GB ที่การ์ดใบเดียวรับไม่ไหว บน Radeon AI PRO R9700 สองใบ ด้วย ROCm และ Vulkan ทั้งบริบทสั้นและบริบทยาวถึง 128K พร้อมผลทดลอง MTP
- llama.cpp v0.8.0 อัปเดต เพิ่มโมเดลใหม่ ปรับปรุง MoE และ GPU Backend พร้อมรองรับ Realtime API
llama.cpp v0.8.0 เพิ่มการรองรับโมเดล AI รุ่นใหม่ ปรับปรุง MoE และ Sparse Attention ขยายความสามารถ GPU Backend พร้อมเพิ่ม Realtime API, TTS และฟีเจอร์สำหรับ AI Agent
- คู่มือ VRAM 16GB: โมเดล 12B สบาย แต่ 27B ที่ Q4 ยังไม่พอดีบนการ์ดใบเดียว
คู่มือสำหรับการ์ดจอ VRAM 16GB สรุปความพอดีของโมเดลและ quantization พร้อมผลวัดจริงจากการต่อการ์ด 16GB สองใบ (RX 9060 XT คู่ และ RX 9070 XT + RX 6800 XT)
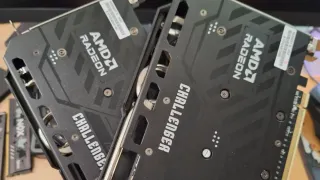
- รายงานการทดสอบเชิงลึก: ปลดล็อกพลัง Qwen3.8-27B บน Dual AMD Radeon RX 9060 XT (RDNA 4)
เปรียบเทียบ ROCm และ Vulkan บน RX 9060 XT สองใบด้วย PromptMark รวมโหมดปกติ MTP และ DFlash
- รายงานผลการทดสอบเชิงลึก: Dual GPU ข้ามสถาปัตยกรรม AMD Radeon RX 9070 XT (RDNA 4) + RX 6800 XT (RDNA 2)
เปรียบเทียบ Vulkan, ROCm 7 และ ROCm 10 บน RX 9070 XT ร่วมกับ RX 6800 XT ด้วยโมเดล Qwen สองรุ่น
- NVIDIA DGX Spark 64GB: เปิดทางเลือกใหม่ให้สาย Local AI รันโมเดลใหญ่ได้เต็มเครื่อง ไม่ต้องง้อ Cloud
NVIDIA ประกาศเปิดจำหน่าย NVIDIA DGX Spark รุ่นความจำ 64GB อย่างเป็นทางการ เริ่ม 23 ตุลาคม 2026
- รายงานผลการทดสอบ: Dual AMD Radeon RX 9060 XT 16GB (รวม 32GB VRAM) กับการก้าวกระโดดของ AMD ROCm 10 Native RDNA 4
เปรียบเทียบประสิทธิภาพ ROCm 7 กับ ROCm 10 บนการ์ดจอ Dual RX 9060 XT รวม VRAM 32GB ผ่านชุดทดสอบ PromptMark v0.4.0 บนโมเดล Qwen3.6-35B-A3B และ Qwen3.8-27B
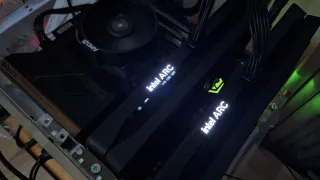
- รายงานผลการทดสอบ: Intel Arc B580 Dual GPU (2x 12GB รวม 24GB VRAM) กับการรัน Local LLM บน Windows
ผลการทดสอบเชิงลึกการ์ดจอคู่ Intel Arc B580 24GB VRAM ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ SYCL vs Vulkan และสถาปัตยกรรม MoE vs Dense บน 8 โมเดล LLM ยอดนิยม