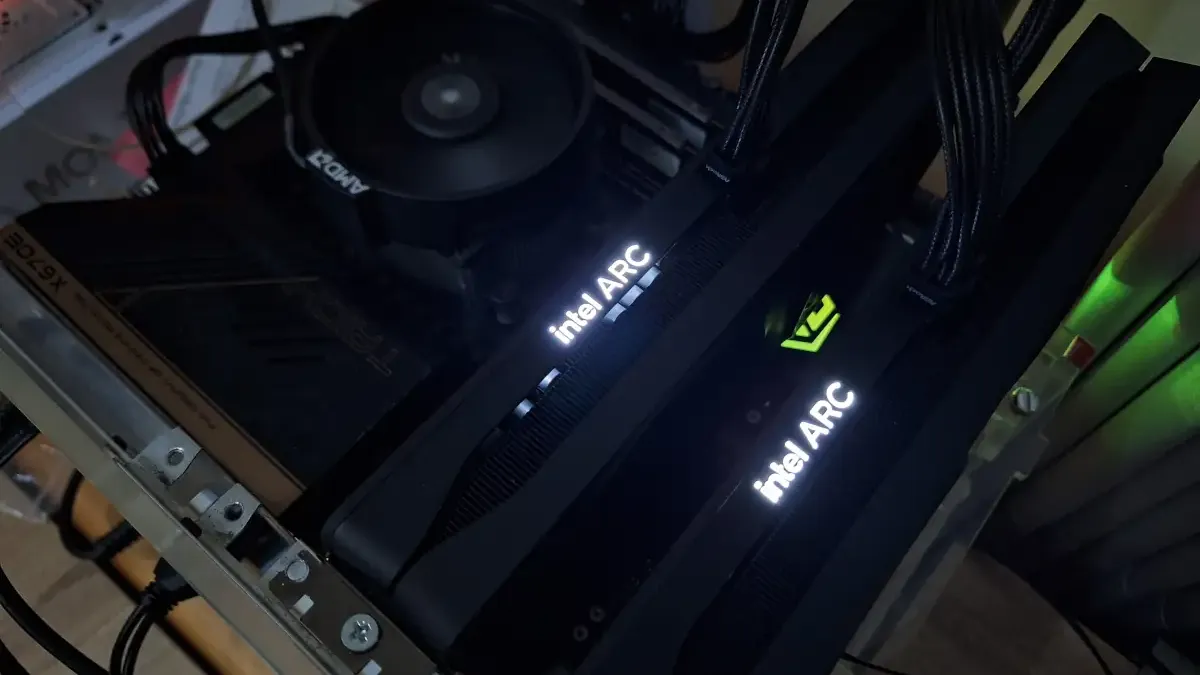
ประเภท: Benchmark · วันที่ทดสอบ: 2026-08-20 · เครื่องมือ: PromptMark v0.4.0 (llama.cpp SYCL b10451 & Vulkan b10362)
- VRAM 24GB ปลดล็อกโมเดลขนาด 26B – 35B: การเชื่อมต่อการ์ดจอ Intel Arc B580 แบบคู่ (12GB GDDR6 x 2 รวม ~24GB) สามารถออฟโหลดโมเดลระดับ 26B, 27B, 30B, 31B และ 35B ลงบนการ์ดจอได้ครบ 100% (
gpu-layers 999) พร้อมเปิด Context Window ได้กว้างถึง 12,288 tokens โดยไม่ต้องแชร์แรมเครื่อง
- MoE คือจุดสูงสุดของความเร็ว (70 – 78+ Tokens/s): โมเดลสถาปัตยกรรม Mixture of Experts ทำความเร็ว Decode สูงสุดถึง 78.39 tokens/s บน
Qwen3.6-35B-A3B และ 74.08 tokens/s บน gemma-4-26B-A4B-it ซึ่งเร็วกว่าโมเดล Dense ขนาดเดียวกันถึง 4.1 – 4.4 เท่า
- Vulkan ชนะขาดในงาน Prefill (TTFT ต่ำ ตอบสนองไว): ในการอ่านอินพุตและประมวลผลบริบทขนาดยาว (4K – 8K tokens) แบ็กเอนด์ Vulkan ทำความเร็ว Prefill สูงกว่า SYCL ถึง +60% ถึง +190% ส่งผลให้ Time-to-First-Token (TTFT) ของงานสรุปเอกสาร 8K เร็วกว่า SYCL เกือบ 3 เท่าตัว
- SYCL เหนือชั้นด้านความนิ่ง (Decode Retention 90% – 98%): เมื่อบริบทสะสมเพิ่มขึ้นจาก 512 ไปเป็น 8,192 tokens ตัวประมวลผล SYCL รักษาความเร็วในการสร้างคำได้สม่ำเสมอแทบไม่แผ่วปลาย ขณะที่ Vulkan ความเร็ว Decode ตกลง 18% – 32% จากภาระของ KV Cache
- ความเข้ากันได้ของ Quantization ยุคใหม่: SYCL สามารถรันฟอร์แมตควอนไทซ์ล้ำสมัยอย่าง NVFP4 (
NVIDIA-Nemotron-3.5-Lightning-30B-A3B) ได้อย่างสมบูรณ์แบบที่ความเร็ว Decode 44+ tokens/s ขณะที่รันไทม์ Vulkan (Build 10362) ยังหยุดทำงาน (Crash) กับฟอร์แมตนี้
| รายการ |
รายละเอียดการตั้งค่าฮาร์ดแวร์และซอฟต์แวร์ |
| GPU Setup |
2× Intel Arc B580 Graphics (หน่วยความจำ 11,875 – 12,118 MiB ต่อการ์ด รวมประมาณ 24GB GDDR6) |
| สถาปัตยกรรม GPU |
Intel Xe2-HPG (“Battlemage”), เชื่อมต่อแบบ Dual-GPU ผ่านบัส PCIe |
| ระบบปฏิบัติการ |
Windows x86_64 (คอมไพล์ด้วย Clang 20.1.8) |
| เครื่องมือทดสอบ |
PromptMark v0.4.0 (รัน 6 เวิร์กโหลดมาตรฐาน) |
| รันไทม์ SYCL |
llama-server.exe build 10451 (commit 10bf611e5, candidate package) |
| รันไทม์ Vulkan |
llama-server.exe build 10362 (commit 4801e3c56, historical package) |
| คำสั่งการกระจายงาน |
--device SYCL0,SYCL1 (หรือ Vulkan0,Vulkan1) --split-mode layer --tensor-split 1,1 |
| พารามิเตอร์รันไทม์ |
-c 12288 -ngl 999 -np 1 --no-cache-prompt --fit off --host 127.0.0.1 --port 8080 |
| นโยบายแคช |
ปิด Prompt Cache (fresh_prompt_cache_off) เพื่อวัดพลังคำนวณจริงของฮาร์ดแวร์ทุกรอบ |
| วิธีเก็บสถิติ |
1 Warm-up Run + 5 Measured Runs รวม 36 ครั้งต่อโมเดล คำนวณค่ามัธยฐาน (Median) |
- Content Generation (
content_generation_512): Context 512 tokens/Generation 256 tokens (งานเขียนทั่วไป)
- Creative Writing (
creative_writing_512): Context 512 tokens/Generation 512 tokens (งานเขียนสร้างสรรค์ขนาดยาว)
- Summarization Light (
summary_2k): Context 2,048 tokens/Generation 256 tokens (สรุปเอกสารสั้น)
- Summarization Moderate (
summary_4k): Context 4,096 tokens/Generation 256 tokens (สรุปรายงานวิชาการขนาดกลาง)
- Summarization Long (
summary_8k): Context 8,192 tokens/Generation 256 tokens (สรุปเอกสารยาวเพื่อทดสอบ Long-Context Penalty)
- Code Analysis (
code_analysis_4k): Context 4,096 tokens/Generation 256 tokens (อ่านและวิเคราะห์ซอร์สโค้ดภาษา Python)
โมเดล MoE ยอดนิยมขนาด 35B ที่เปิดใช้พารามิเตอร์เพียง 3B ต่อโทเค็น
วิธีอ่านตาราง: แต่ละช่องมีสองค่าเรียงตามคอลัมน์ Backend (SYCL / Vulkan) ตัวหนาคือค่าที่ดีกว่า
| เวิร์กโหลด (Workload) |
Context/Gen |
Backend |
Prompt Speed (t/s) |
Decode Speed (t/s) |
TTFT (ms) |
E2E Latency (ms) |
| Content Generation |
512/256 |
SYCL / Vulkan |
625.33 / 516.50 |
78.39 / 65.68 |
903.5 / 1,102.4 |
4,156.3 / 5,000.5 |
| Creative Writing |
512/512 |
SYCL / Vulkan |
620.75 / 514.84 |
78.34 / 65.34 |
895.9 / 1,090.0 |
7,416.7 / 8,926.9 |
| Summary 2K |
2048/256 |
SYCL / Vulkan |
692.41 / 747.54 |
76.95 / 62.92 |
3,014.3 / 2,810.8 |
6,331.7 / 6,871.8 |
| Summary 4K |
4096/256 |
SYCL / Vulkan |
702.05 / 829.70 |
75.96 / 59.90 |
5,858.7 / 4,963.0 |
9,216.7 / 9,236.8 |
| Summary 8K |
8192/256 |
SYCL / Vulkan |
697.58 / 825.56 |
73.66 / 53.90 |
11,776.3 / 9,953.7 |
15,242.2 / 14,698.5 |
| Code Analysis 4K |
4096/256 |
SYCL / Vulkan |
706.43 / 810.37 |
75.93 / 60.19 |
5,936.6 / 5,242.5 |
9,300.6 / 9,496.4 |
โมเดลคู่แฝดสถาปัตยกรรม MoE 35B ให้ผลลัพธ์ระดับทัดเทียมกับ Qwen3.6-35B
| เวิร์กโหลด (Workload) |
Context/Gen |
Backend |
Prompt Speed (t/s) |
Decode Speed (t/s) |
TTFT (ms) |
E2E Latency (ms) |
| Content Generation |
512/256 |
SYCL / Vulkan |
622.93 / 520.03 |
77.68 / 65.82 |
915.9 / 1,108.5 |
4,199.0 / 4,997.0 |
| Creative Writing |
512/512 |
SYCL / Vulkan |
618.83 / 521.61 |
77.60 / 65.44 |
894.6 / 1,090.8 |
7,480.0 / 8,915.3 |
| Summary 2K |
2048/256 |
SYCL / Vulkan |
691.67 / 736.20 |
76.41 / 63.03 |
3,014.6 / 2,854.8 |
6,352.0 / 6,916.6 |
| Summary 4K |
4096/256 |
SYCL / Vulkan |
701.79 / 814.18 |
75.18 / 59.97 |
5,864.2 / 5,049.0 |
9,256.5 / 9,317.5 |
| Summary 8K |
8192/256 |
SYCL / Vulkan |
697.56 / 817.10 |
72.91 / 54.01 |
11,777.2 / 10,051.3 |
15,276.0 / 14,790.2 |
| Code Analysis 4K |
4096/256 |
SYCL / Vulkan |
704.31 / 795.13 |
75.08 / 60.30 |
5,964.8 / 5,316.2 |
9,361.5 / 9,563.8 |
โมเดล Google Gemma-4 MoE 26B เปิดใช้งาน 4B ต่อโทเค็น ปลดปล่อยพลังบน Vulkan ได้โดดเด่นเป็นพิเศษ
| เวิร์กโหลด (Workload) |
Context/Gen |
Backend |
Prompt Speed (t/s) |
Decode Speed (t/s) |
TTFT (ms) |
E2E Latency (ms) |
| Content Generation |
512/256 |
SYCL / Vulkan |
652.67 / 882.13 |
51.24 / 74.08 |
930.1 / 760.8 |
5,902.7 / 4,217.7 |
| Creative Writing |
512/512 |
SYCL / Vulkan |
654.95 / 880.58 |
50.81 / 72.81 |
878.4 / 690.7 |
10,931.0 / 7,727.9 |
| Summary 2K |
2048/256 |
SYCL / Vulkan |
778.48 / 1,237.35 |
49.79 / 66.00 |
2,707.6 / 1,752.4 |
7,829.5 / 5,635.9 |
| Summary 4K |
4096/256 |
SYCL / Vulkan |
809.91 / 1,362.18 |
48.91 / 62.25 |
5,087.0 / 3,033.2 |
10,300.5 / 7,152.1 |
| Summary 8K |
8192/256 |
SYCL / Vulkan |
822.22 / 1,248.93 |
47.18 / 54.82 |
10,000.2 / 6,599.5 |
15,404.9 / 11,271.0 |
| Code Analysis 4K |
4096/256 |
SYCL / Vulkan |
821.46 / 1,363.06 |
48.87 / 62.26 |
5,183.9 / 3,083.8 |
10,401.5 / 7,196.2 |
โมเดลควอนไทซ์ชนิด NVFP4 มีเฉพาะข้อมูลจากรันไทม์ SYCL เนื่องจาก Vulkan แครชหลังรอบ Warmup
| เวิร์กโหลด (Workload) |
Context/Gen |
Backend |
Prompt Speed (t/s) |
Decode Speed (t/s) |
TTFT (ms) |
E2E Latency (ms) |
| Content Generation |
512/256 |
SYCL / Vulkan |
436.71 / ไม่ผ่าน (Crash) |
44.63 / N/A |
1,241.0 / N/A |
6,957.2 / N/A |
| Creative Writing |
512/512 |
SYCL / Vulkan |
436.21 / ไม่ผ่าน (Crash) |
44.57 / N/A |
1,231.4 / N/A |
12,694.3 / N/A |
| Summary 2K |
2048/256 |
SYCL / Vulkan |
507.82 / ไม่ผ่าน (Crash) |
44.44 / N/A |
4,073.6 / N/A |
9,815.8 / N/A |
| Summary 4K |
4096/256 |
SYCL / Vulkan |
529.67 / ไม่ผ่าน (Crash) |
44.22 / N/A |
7,758.0 / N/A |
13,522.4 / N/A |
| Summary 8K |
8192/256 |
SYCL / Vulkan |
540.27 / ไม่ผ่าน (Crash) |
43.74 / N/A |
15,175.4 / N/A |
21,006.6 / N/A |
| Code Analysis 4K |
4096/256 |
SYCL / Vulkan |
520.95 / ไม่ผ่าน (Crash) |
44.20 / N/A |
7,953.6 / N/A |
13,724.4 / N/A |
| เวิร์กโหลด (Workload) |
Context/Gen |
Backend |
Prompt Speed (t/s) |
Decode Speed (t/s) |
TTFT (ms) |
E2E Latency (ms) |
| Content Generation |
512/256 |
SYCL / Vulkan |
373.25 / 599.57 |
34.59 / 37.65 |
1,620.0 / 1,147.1 |
8,995.7 / 7,949.6 |
| Creative Writing |
512/512 |
SYCL / Vulkan |
374.23 / 603.76 |
34.40 / 36.89 |
1,513.0 / 1,009.6 |
16,359.7 / 14,888.9 |
| Summary 2K |
2048/256 |
SYCL / Vulkan |
457.30 / 825.54 |
33.97 / 33.02 |
4,581.4 / 2,606.1 |
12,090.8 / 10,359.6 |
| Summary 4K |
4096/256 |
SYCL / Vulkan |
478.72 / 886.77 |
33.01 / 30.13 |
8,587.3 / 4,650.2 |
16,317.8 / 13,151.5 |
| Summary 8K |
8192/256 |
SYCL / Vulkan |
487.13 / 801.50 |
32.26 / 25.65 |
16,852.0 / 10,253.9 |
24,756.1 / 20,242.5 |
| Code Analysis 4K |
4096/256 |
SYCL / Vulkan |
478.13 / 881.82 |
33.01 / 30.10 |
8,877.1 / 4,739.5 |
16,601.8 / 13,243.1 |
| เวิร์กโหลด (Workload) |
Context/Gen |
Backend |
Prompt Speed (t/s) |
Decode Speed (t/s) |
TTFT (ms) |
E2E Latency (ms) |
| Content Generation |
512/256 |
SYCL / Vulkan |
172.05 / 298.92 |
18.93 / 20.69 |
3,203.6 / 1,934.9 |
16,667.4 / 14,307.2 |
| Creative Writing |
512/512 |
SYCL / Vulkan |
172.35 / 299.30 |
18.94 / 20.56 |
3,111.7 / 1,857.6 |
30,095.0 / 26,766.6 |
| Summary 2K |
2048/256 |
SYCL / Vulkan |
212.54 / 506.69 |
18.61 / 19.79 |
9,734.3 / 4,164.0 |
23,436.8 / 17,098.5 |
| Summary 4K |
4096/256 |
SYCL / Vulkan |
221.14 / 601.05 |
18.15 / 18.81 |
18,546.3 / 6,840.4 |
32,595.8 / 20,441.5 |
| Summary 8K |
8192/256 |
SYCL / Vulkan |
224.53 / 610.66 |
17.15 / 17.00 |
36,517.5 / 13,447.8 |
51,384.8 / 28,509.2 |
| Code Analysis 4K |
4096/256 |
SYCL / Vulkan |
221.10 / 603.05 |
18.15 / 18.82 |
18,633.2 / 7,178.6 |
32,682.4 / 20,776.0 |
| เวิร์กโหลด (Workload) |
Context/Gen |
Backend |
Prompt Speed (t/s) |
Decode Speed (t/s) |
TTFT (ms) |
E2E Latency (ms) |
| Content Generation |
512/256 |
SYCL / Vulkan |
181.43 / 358.01 |
20.46 / 23.93 |
3,051.9 / 1,665.2 |
15,360.5 / 12,236.3 |
| Creative Writing |
512/512 |
SYCL / Vulkan |
181.44 / 357.79 |
20.38 / 23.64 |
3,015.5 / 1,607.6 |
27,943.3 / 23,138.3 |
| Summary 2K |
2048/256 |
SYCL / Vulkan |
219.98 / 541.07 |
20.08 / 21.40 |
9,502.6 / 3,984.3 |
22,052.2 / 15,795.8 |
| Summary 4K |
4096/256 |
SYCL / Vulkan |
227.49 / 630.55 |
19.97 / 20.63 |
18,182.2 / 6,669.6 |
30,795.7 / 18,939.7 |
| Summary 8K |
8192/256 |
SYCL / Vulkan |
230.92 / 671.17 |
19.77 / 19.30 |
35,666.6 / 12,401.0 |
48,412.6 / 25,517.1 |
| Code Analysis 4K |
4096/256 |
SYCL / Vulkan |
227.47 / 629.57 |
19.97 / 20.64 |
18,218.7 / 6,698.7 |
30,833.3 / 18,952.8 |
| เวิร์กโหลด (Workload) |
Context/Gen |
Backend |
Prompt Speed (t/s) |
Decode Speed (t/s) |
TTFT (ms) |
E2E Latency (ms) |
| Content Generation |
512/256 |
SYCL / Vulkan |
142.94 / 251.61 |
16.13 / 16.84 |
4,072.2 / 2,557.8 |
19,890.1 / 17,758.1 |
| Creative Writing |
512/512 |
SYCL / Vulkan |
144.77 / 255.84 |
16.11 / 16.49 |
3,753.6 / 2,257.2 |
35,475.7 / 33,296.4 |
| Summary 2K |
2048/256 |
SYCL / Vulkan |
175.84 / 339.15 |
15.54 / 15.16 |
11,946.1 / 6,381.4 |
28,352.1 / 23,266.4 |
| Summary 4K |
4096/256 |
SYCL / Vulkan |
183.47 / 361.78 |
15.36 / 14.34 |
22,354.6 / 11,347.3 |
38,959.2 / 29,207.5 |
| Summary 8K |
8192/256 |
SYCL / Vulkan |
186.67 / 323.66 |
15.00 / 12.88 |
43,924.7 / 25,347.2 |
60,922.3 / 45,231.1 |
| Code Analysis 4K |
4096/256 |
SYCL / Vulkan |
183.47 / 360.89 |
15.36 / 14.34 |
22,873.2 / 11,943.7 |
39,475.8 / 29,797.2 |
การทดสอบข้าม 8 โมเดลบนการ์ดจอ Intel Arc B580 คู่ สะท้อนให้เห็นจุดเด่นและข้อจำกัดของทั้งสองชุดเครื่องมืออย่างชัดเจน:
- Vulkan เร็วกว่าอย่างมหาศาลในบริบทขนาดยาว: โมเดลขนาด 27B – 30B (เช่น
Muse-Glimmer-30B และ Qwen3.8-27B) เมื่อต้องประมวลผลอินพุต 4,096 และ 8,192 โทเค็น แบ็กเอนด์ Vulkan ทำความเร็วได้ถึง 610 – 671 tokens/s เทียบกับ SYCL ที่ทำได้เพียง 224 – 230 tokens/s (Vulkan เร็วกว่าถึง +172% ถึง +190%)
- ลดเวลารอคอยคำแรก (Time-to-First-Token) ในงานสรุปบทความ 8K:
Muse-Glimmer-30B: Vulkan ใช้เวลาส่งโทเค็นแรกเพียง 12.4 วินาที ขณะที่ SYCL ใช้เวลาถึง 35.7 วินาที (เร็วขึ้นเกือบ 3 เท่า)Qwen3.8-27B: Vulkan ใช้เวลา 13.4 วินาที ขณะที่ SYCL ใช้เวลาถึง 36.5 วินาที
- สาเหตุทางเทคนิค: ตัวประมวลผล Compute Pipeline ของ Vulkan บนสถาปัตยกรรม Xe2-HPG มีประสิทธิภาพในการรัน Batch Matrix Multiplication สูงมากเมื่ออินพุตเป็นชุดข้อมูลขนาดใหญ่
เมื่อทดสอบการ Generate ในบริบทที่ขยายจาก 512 โทเค็นไปจนถึง 8,192 โทเค็น:
- SYCL เหนือชั้นด้วย Decode Retention ระดับ 90% – 98%:
Muse-Glimmer-30B: 20.46 t/s (512)/19.77 t/s (8K) = รักษาความเร็วได้ถึง 96.6%Qwen3.6-35B-A3B: 78.39 t/s (512)/73.66 t/s (8K) = รักษาความเร็วได้ถึง 94.0%NVIDIA-Nemotron-30B NVFP4: 44.63 t/s (512)/43.74 t/s (8K) = รักษาความเร็วได้ถึง 98.0%
- Vulkan มีอาการ Decode Drop ชัดเจนเมื่อแคชมีขนาดใหญ่ (ตกลงเหลือ 68% – 82%):
gemma-4-12B: ความเร็วตกลงจาก 37.65 t/s เหลือ 25.65 t/s (ประสิทธิภาพหายไป 31.9%)gemma-4-26B-A4B: ความเร็วตกลงจาก 74.08 t/s เหลือ 54.82 t/s (ตกลงไป 26.0%)Qwen3.6-35B-A3B: ความเร็วตกลงจาก 65.68 t/s เหลือ 53.90 t/s (ตกลงไป 17.9%)
- ข้อสรุป: หากการใช้งานเป็นการแช็ตต่อเนื่องหรือการเขียนบทความยาวใน Session เดียวกัน รันไทม์ SYCL จะรักษาความเร็วในการพิมพ์ออกได้อย่างคงเส้นคงวามากกว่า
ตารางเปรียบเทียบประสิทธิภาพระหว่างสถาปัตยกรรม MoE และ Dense ในเวิร์กโหลด Content Generation (512 Context/256 Generation):
| โมเดล (Model) |
สถาปัตยกรรม |
พารามิเตอร์รวม (Total) |
พารามิเตอร์ที่ประมวลผล (Active) |
Quantization |
SYCL Decode (tok/s) |
Vulkan Decode (tok/s) |
SYCL Prefill (tok/s) |
Vulkan Prefill (tok/s) |
ผลลัพธ์เชิงเปรียบเทียบ |
| Qwen3.6-35B-A3B |
MoE |
35B |
3B |
Q4_K_M |
78.39 |
65.68 |
625.33 |
516.50 |
Decode เร็วกว่า Dense 27B ถึง 4.14 เท่า |
| Ornith-1.0-35B |
MoE |
35B |
3B |
Q4_K_M |
77.68 |
65.82 |
622.93 |
520.03 |
ความเร็วระดับแนวหน้าเทียบเท่า Qwen3.6-35B |
| gemma-4-26B-A4B-it |
MoE |
26B |
4B |
Q4_K_M |
51.24 |
74.08 |
652.67 |
882.13 |
Vulkan เร็วจัด, เร็วกว่า Dense 31B ถึง 4.40 เท่า |
| Nemotron-3.5-30B-A3B |
MoE |
30B |
3B |
NVFP4 |
44.63 |
Crash |
436.71 |
Crash |
รันผ่านสมบูรณ์บน SYCL ด้วยความเร็ว 44.6 t/s |
| gemma-4-12B-it |
Dense |
12B |
12B |
Q4_K_M |
34.59 |
37.65 |
373.25 |
599.57 |
แม้ตัวเล็กกว่า แต่ Decode ช้ากว่า MoE 26B/35B เกือบครึ่ง |
| Muse-Glimmer-30B-UD |
Dense |
30B |
30B |
Q4_K_XL |
20.46 |
23.93 |
181.43 |
358.01 |
ติดเพดานแบนด์วิดท์คำนวณเต็มพารามิเตอร์ (~20–24 t/s) |
| Qwen3.8-27B |
Dense |
27B |
27B |
Q4_K_M |
18.93 |
20.69 |
172.05 |
298.92 |
ช้ากว่า MoE 35B อย่างชัดเจน แม้พารามิเตอร์รวมน้อยกว่า |
| gemma-4-31B-it |
Dense |
31B |
31B |
Q4_K_M |
16.13 |
16.84 |
142.94 |
251.61 |
หนักที่สุดในชุดทดสอบ Decode คงที่ ~16–17 t/s |
- MoE ให้ความเร็วเหนือกว่าหลายเท่าตัว: โมเดลอย่าง
Qwen3.6-35B-A3B มีพารามิเตอร์รวม 35B (มากกว่า Qwen3.8-27B) แต่ด้วยการประมวลผลจริงเพียง 3B ต่อโทเค็น ทำให้ทำความเร็วสร้างคำได้ถึง 78.39 tokens/s เทียบกับโมเดล 27B Dense ที่ทำได้เพียง 18.93 tokens/s (เร็วกว่า 4.14 เท่า)
- เอาชนะโมเดล Dense ขนาดเล็กกว่า:
gemma-4-26B-A4B-it (74.08 tokens/s บน Vulkan) ทำความเร็ว Decode ได้เร็วกว่า gemma-4-12B (37.65 tokens/s) ถึงเกือบ 2 เท่า ทั้งที่มีขนาดพารามิเตอร์รวมมากกว่าถึงเท่าตัว
- ความคุ้มค่าบนการ์ดจอ VRAM 24GB: หากต้องการทั้ง “ความฉลาดระดับโมเดลขนาดใหญ่ 30B+” ควบคู่กับ “ความเร็วตอบสนองระดับ Real-time 70+ tokens/s” สถาปัตยกรรม MoE บน Dual Intel Arc B580 คือตัวเลือกที่ให้ผลลัพธ์ดีที่สุด
- ความจุ VRAM รวมที่ปลดล็อกข้อจำกัด: โมเดลขนาด 26B – 35B ที่ระดับควอนไทซ์ Q4_K_M มีขนาดไฟล์ 16GB – 22GB ซึ่งการ์ดเดี่ยวขนาด 12GB ไม่สามารถโหลดได้ การจับคู่การ์ดจอสองตัวช่วยรวม VRAM เป็น 24GB ทำให้สามารถออฟโหลดโมเดลได้ 100% ครบทุกเลเยอร์ พร้อมเปิด Context ได้เต็ม 12,288 โทเค็น
- การส่งข้อมูลข้ามการ์ด (PCIe Inter-GPU Communication): การใช้โหมด
--split-mode layer --tensor-split 1,1 เป็นการส่งผ่านข้อมูลเฉพาะ Activation Vector ตรงเลเยอร์กึ่งกลางระหว่างการ์ดสองใบ ผลการทดสอบยืนยันว่าบัส PCIe ไม่ได้กลายเป็นคอขวด ระบบยังสามารถทำความเร็ว Decode ได้สูงถึง 78+ tokens/s และ Prefill ได้เกิน 1,300 tokens/s
| ลักษณะงานที่ต้องการนำไปใช้ |
Backend ที่แนะนำ |
โมเดลที่แนะนำ |
| งานสรุปเอกสารขนาดยาว, RAG, วิเคราะห์โค้ด (เน้นอ่าน Prompt ไว ตอบคำแรกเร็ว TTFT ต่ำ) |
Vulkan |
gemma-4-26B-A4B-it (Q4_K_M), Qwen3.6-35B-A3B (Q4_K_M) |
| งานเขียนนิยาย, ร่างรายงานยาว, แช็ตต่อเนื่อง (เน้นความเร็วพิมพ์สม่ำเสมอ ไม่แผ่วปลายแม้บริบท 8K) |
SYCL |
Qwen3.6-35B-A3B (Q4_K_M), Ornith-1.0-35B (Q4_K_M) |
| ต้องการใช้งานโมเดลควอนไทซ์ NVFP4 (Vulkan b10362 ยังแครชกับ NVFP4) |
SYCL |
Nemotron-3.5-30B-A3B (NVFP4) |
ระบบ Dual Intel Arc B580 (24GB VRAM) พิสูจน์ให้เห็นแล้วว่าเป็นทางเลือกที่คุ้มค่ามากสำหรับการตั้งเวิร์กสเตชัน Local AI ภายในงบประมาณที่เข้าถึงได้ง่าย การจับคู่โมเดลสถาปัตยกรรม MoE (อย่าง Qwen3.6-35B-A3B หรือ gemma-4-26B-A4B-it) ช่วยให้ผู้ใช้ได้ทั้งพลังความฉลาดของโมเดลขนาดใหญ่ 30B+ และความเร็วในการตอบสนองที่ไหลลื่นเกิน 70 – 78 tokens/s อย่างที่ไม่เคยมีมาก่อนในฮาร์ดแวร์ระดับราคานี้