ถอดรหัสโมเดล Q4_K_M, Q3_K_XL หมายถึงอะไร
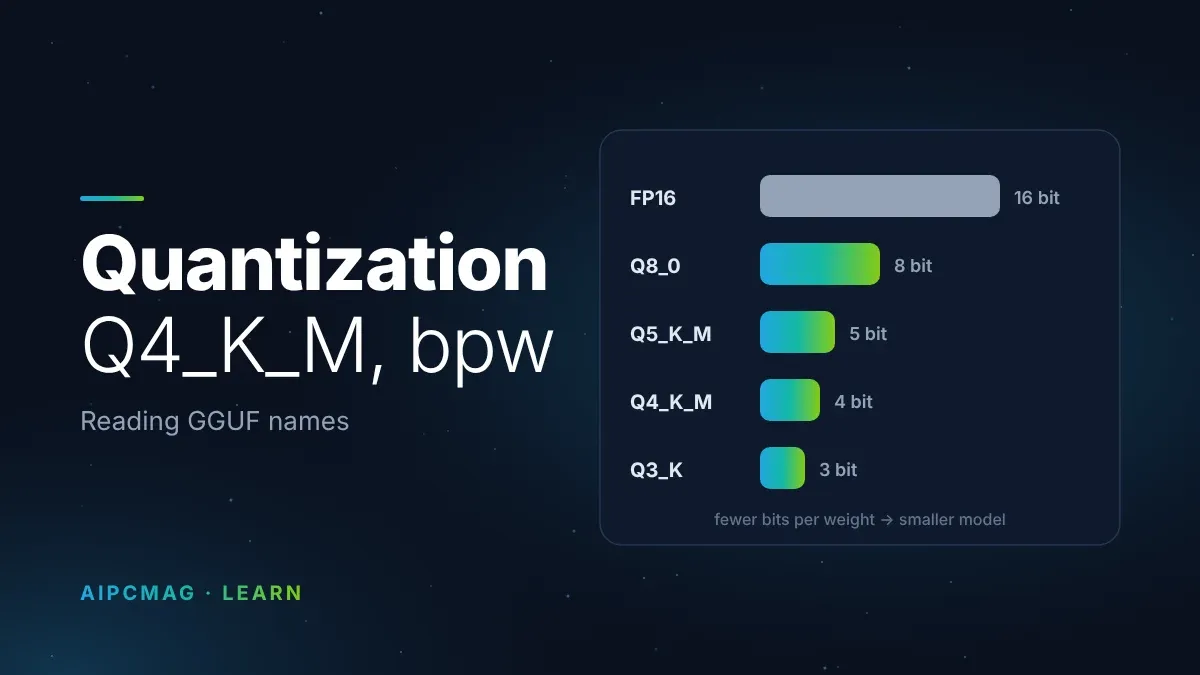
เมื่อดาวน์โหลดโมเดลสำหรับ Local AI คุณมักเจอชื่อไฟล์อย่าง Qwen3.8-27B-Q4_K_M.gguf หรือ gemma-4-26B-A4B-it-Q4_K_M ตัวอักษร Q4_K_M ต่อท้ายคือข้อมูลการทำ Quantization ซึ่งบอกทั้งขนาดไฟล์ ความเร็ว และคุณภาพที่คุณต้องแลกมา การอ่านมันออกจึงเป็นทักษะพื้นฐานก่อนเลือกโมเดลลงเครื่อง
Quantization คืออะไร
หัวข้อที่มีชื่อว่า “Quantization คืออะไร”Quantization คือการ ลดจำนวนบิตต่อน้ำหนัก ให้เหลือ 8, 6, 5, 4 หรือต่ำกว่า เพื่อให้ไฟล์เล็กลงและโหลดเข้า GPU หรือ RAM ได้สะดวกขึ้น
เนื่องจากโมเดลต้นฉบับดั้งเดิมที่ถูกฝึกมามักเก็บน้ำหนัก (weight) ด้วยเลขทศนิยม 16 บิต (FP16 หรือ BF16) ซึ่งทำให้ไฟล์ของโมเดลมีขนาดใหญ่มาก ๆ จนไม่สามารถนำมาใช้งานร่วมกับเครื่องคอมพิวเตอร์ทั่วไปได้ ดังนั้นจึงมาการพัฒนาเทคนิค Quantization หรือการลดขนาดโมเดลขึ้นมา ซี่งผลที่ได้ก็คือ:
- ขนาดเล็กลง ทำให้โมเดล LLM สามารถนำมาใช้ในเครื่องที่มีหน่วยความจำจำกัดได้
- เร็วขึ้นในทางปฏิบัติ เพราะการสร้างข้อความถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำเป็นหลัก ข้อมูลที่ต้องอ่านต่อโทเคนจากไฟล์ที่ลดขนาดก็มีน้อยลง
- แลกกับความแม่นยำ น้ำหนักที่หยาบลงอาจทำให้คุณภาพคำตอบลดลง โดยเฉพาะการคำนวณและงานที่ต้องแม่นยำสูง
อ่านชื่อ GGUF ทีละส่วน
หัวข้อที่มีชื่อว่า “อ่านชื่อ GGUF ทีละส่วน”รูปแบบที่ llama.cpp, Ollama, LM Studio และเครื่องมือส่วนใหญ่ใช้คือ GGUF ซึ่งเข้ารหัสวิธี Quantization ไว้ในชื่อไฟล์ ตัวอย่าง Q4_K_M แยกได้ดังนี้
| ส่วน | ความหมาย |
|---|---|
| Q | Quantized ผ่านการลดบิตแล้ว |
| 4 | จำนวนบิตต่อน้ำหนักโดยประมาณ |
| K | อยู่ในตระกูล k-quant ซึ่งจัดกลุ่มน้ำหนักและเก็บค่า scale อย่างมีโครงสร้าง |
| M | ขนาดกลาง (medium) ภายในตระกูลเดียวกัน ยังมี S (small) และ L (large) |
ตัวเลขบิตเป็นเพียงค่าประมาณ ค่า bpw (bit per weight) จริงสูงกว่านั้นเสมอ เพราะยังมีค่า scale และ metadata ที่ต้องเก็บเพิ่ม
bpw คืออะไร และสำคัญอย่างไร
หัวข้อที่มีชื่อว่า “bpw คืออะไร และสำคัญอย่างไร”bpw (bits per weight) คือจำนวนบิตเฉลี่ยต่อพารามิเตอร์หนึ่งตัว เมื่อรวมทุกอย่างที่ต้องเก็บจริง มันจึงเป็นตัวเลขที่ใช้คำนวณขนาดหน่วยความจำได้แม่นกว่าตัวเลขหน้า Q
| รูปแบบ | bpw โดยประมาณ | หมายเหตุ |
|---|---|---|
| Q8_0 | 8 | ใกล้เคียงต้นฉบับ แลกกับขนาด |
| Q6_K | ~6.6 | สมดุลระหว่างคุณภาพและขนาด |
| Q5_K_M | ~5.5 | คุณภาพดีกว่า Q4 อย่างชัดเจน |
| Q4_K_M | ~4.5 | ค่าตั้งต้นที่นิยมใช้ที่สุด |
| Q3_K_M | ~3.9 | ประหยัด แต่เริ่มเห็นผลต่อคุณภาพ |
| Q2_K | ~2.6 | เล็กมาก แต่คุณภาพเสี่ยงตกชัดเจน |
ค่า bpw ข้างต้นเป็นค่าประมาณจากพฤติกรรมทั่วไปของตระกูล k-quant แต่ละเวอร์ชันของเครื่องมือ Quantization อาจให้ค่าไม่เท่ากัน โปรดตรวจขนาดไฟล์จริงของแต่ละโมเดล
คำนวณขนาดโมเดลคร่าว ๆ
หัวข้อที่มีชื่อว่า “คำนวณขนาดโมเดลคร่าว ๆ”สูตรพื้นฐานที่ใช้ได้บ่อยคือ
ขนาด (GB) ≈ (จำนวนพารามิเตอร์ × bpw) ÷ 8ตัวอย่าง 27B (สมมติ ไม่ใช่ผลทดสอบ):
- Q4_K_M (bpw ~4.5): 27 × 4.5 ÷ 8 ≈ 15.2 GB
- Q8_0 (bpw 8): 27 × 8 ÷ 8 ≈ 27 GB
จะเห็นว่าความต่างระหว่าง Q4 กับ Q8 เกือบสองเท่า ซึ่งมีผลโดยตรงต่อว่าโมเดลจะพอดีกับ VRAM ของการ์ดคุณหรือไม่ ดูวิธีคำนวณรวม KV cache และ overhead ได้ที่บทความ “พื้นที่ VRAM ของการ์ดจอถูกใช้ไปกับอะไรบ้าง และจัดการได้อย่างไรถ้ามีไม่พอ”
เลือกระดับ Quantization อย่างไร
หัวข้อที่มีชื่อว่า “เลือกระดับ Quantization อย่างไร”- เริ่มที่ Q4_K_M เป็นค่าตั้งต้นที่ให้คุณภาพคุ้มกับขนาด และรองรับงานหลากหลาย
- ถ้า VRAM ยังเหลือ และงานต้องการความแม่นยำขึ้น ให้ขยับเป็น Q5_K_M หรือ Q6_K
- Q8_0 เหมาะกับงานที่ต้องการความแม่นยำสูงสุด โดยยอมแลกกับหน่วยความจำเกือบเท่าต้นฉบับ
- หลีกเลี่ยง Q2_K/Q3_K_S ในงานที่ต้องการความน่าเชื่อถือ เว้นแต่หน่วยความจำจำกัดจริง ๆ (แต่ทั้งนี้ก็ขึ้นอยู่กับพารามิเตอร์โดยรวมของโมเดลด้วย เพราะโมเดลที่มีขนาดพารามิเตอร์เป็นจำนวนมาก แม้จะมีการลดจำนวนบิตแล้วก็ยังมีความแม่นยำในการทำงาน)
ข้อควรระวัง
หัวข้อที่มีชื่อว่า “ข้อควรระวัง”- Quantization ไม่เท่ากันทุกกรณี โมเดลบางตัวทนต่อการลดบิตได้ดีกว่าตัวอื่น
- อย่าตัดสินจาก bpw อย่างเดียว ควรดูผลการใช้งานจริงกับงานของคุณเอง
- ชื่อไฟล์ต่างผู้ผลิตอาจไม่ตรงกัน โมเดลเดียวกันอาจมีไฟล์ Quantization หลายสำนัก ควรเลือกจากแหล่งที่เชื่อถือได้
Quantization เป็นเพียงตัวแปรหนึ่งในสมการหน่วยความจำ ตัวแปรที่สำคัญไม่แพ้กันคือ KV cache และ Context Window ซึ่งอธิบายต่อในบทความถัดไป