พื้นที่ VRAM ของการ์ดจอถูกใช้ไปกับอะไรบ้าง และจัดการได้อย่างไรถ้ามีไม่พอ
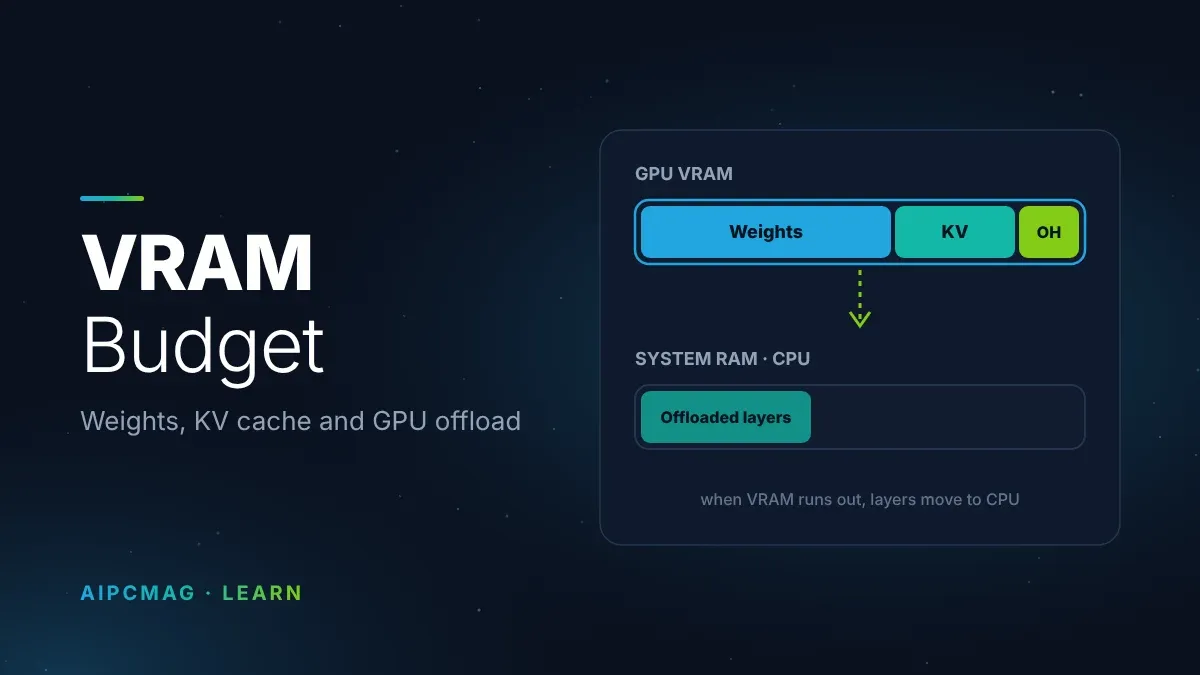
คำถามที่พบบ่อยที่สุดของคนเริ่มรัน Local AI คือ “เครื่องฉันรันโมเดลนี้ได้ไหม” คำตอบไม่ได้ขึ้นกับขนาดไฟล์โมเดลเพียงอย่างเดียว แต่ต้องรวมหน่วยความจำที่ใช้ระหว่างทำงานจริงด้วย บทความนี้พาไล่ทีละส่วนว่าพื้นที่ของหน่วยความจำบนการ์ดจอ (VRAM) ที่ใช้รันโมเดลประกอบด้วยอะไรบ้าง ทำไมไฟล์โมเดลขนาด 7GB ถึงรันบนการ์ดจอ VRAM 8GB ถึงไม่พอ
พื้นที่ VRAM สามส่วนที่ต้องใช้รันโมเดล
หัวข้อที่มีชื่อว่า “พื้นที่ VRAM สามส่วนที่ต้องใช้รันโมเดล”ในการรันโมเดลเวลาเราเห็นไฟล์โมเดลมีขนาด 7GB ไม่ได้แปลว่ามี VRAM 8GB ก็ใช้งานโมเดลนี้ได้ใช้ เพราะการทำให้โมเดลรันได้นั้นจะมีการใช้พื้นที่ของ VRAM สามส่วนด้วยกัน ดังนี้ครับ
พื้นที่ VRAM ที่ใช้รันโมเดล = Weights + KV Cache + Overhead
1. Weights - ค่าน้ำหนักโมเดล (คงที่)
หัวข้อที่มีชื่อว่า “1. Weights - ค่าน้ำหนักโมเดล (คงที่)”คือตัวโมเดลเอง ขนาดเท่ากับไฟล์ที่เห็นบน SSD คิดคร่าว ๆ จาก (จำนวนพารามิเตอร์ทั้งหมด × bpw) / 8 MoE ให้นับพารามิเตอร์ทั้งหมด ไม่ใช่นับแค่ตัวที่ active ก้อนนี้โหลดครั้งเดียว ไม่โตตามแชท ดูเพิ่มเติมใน Quantization และ bpw
2. KV Cache - พื้นที่ VRAM สำหรับเก็บ Context (จองตามที่เราตั้งไว้)
หัวข้อที่มีชื่อว่า “2. KV Cache - พื้นที่ VRAM สำหรับเก็บ Context (จองตามที่เราตั้งไว้)”Context ในที่นี้ไม่ได้หมายถึง Context Window ที่เป็นคุณสมบัติของตัวโมเดลนะครับ แต่เป็น Context ที่เรากำหนดขึ้นเพื่อใช้เก็บ token ต่าง ๆ ที่เราพูดคุยกับโมเดลในแชทนั้น ๆ ขนาดของมันถูกกำหนดโดย ขนาด Context ที่เราตั้งตอนรัน
KV Cache คือพื้นที่ที่ใช้เก็บ Context และขนาดของมันถูกกำหนดโดยขนาด Context ที่เราตั้งไว้
ตัวอย่าง gemma-4-12B-it-QAT-Q4_0.gguf 7.0GB: Weights 7.0GB + KV Cache (ตาม ctx ที่ตั้ง) + Overhead 1GB = VRAM ที่ต้องใช้จริง
ตั้ง ctx 4k = ~9.5GB / ตั้ง ctx 32k = ~20GB ทั้งที่เป็นโมเดลไฟล์เดียวกัน แต่ขนาดการใช้ VRAM ทั้งหมดจะเปลี่ยนไปตาม Context ที่เราตั้ง (ctx เป็นคำย่อของ Context ที่เรามักจะได้เห็นในบทความที่เกี่ยวกับ LLM)
(ดูรายละเอียดที่ Context Window และ KV Cache)
3. Overhead - ค่าการใช้ทรัพยากรของระบบ
หัวข้อที่มีชื่อว่า “3. Overhead - ค่าการใช้ทรัพยากรของระบบ”เช่นไดรเวอร์การ์ดจอ ส่วนของระบบปฏิบัติการ และอื่น ๆ โดยปกติจะอยู่ราว 0.5 - 1.5GB แล้วแต่ backend แล้วแต่ระบบปฏิบัติการที่ใช้ พื้นที่เหล่านี้บางส่วนถูกใช้ทันทีตั้งแต่เปิดเครื่องคอมพิวเตอร์แล้ว พอเริ่มโหลดโปรแกรมสำหรับรันโมเดลก็จะใช้เพิ่มอีกนิด
GPU offload คืออะไร
หัวข้อที่มีชื่อว่า “GPU offload คืออะไร”GPU offload คือการกำหนดว่าโมเดลส่วนใดจะโหลดเข้า GPU และส่วนใดจะรันบน CPU โดยทั่วไปจะนับเป็น “จำนวนชั้น” หรือ layers โดยโมเดลแต่ละตัวจำมีจำนวนชั้นไม่เท่ากัน บางรุ่นอาจจะมี 40, บางรุ่นมี 60 ยิ่งจำนวนชั้นมากโมเดลก็จะมีความแม่นย้ำมากขึ้น แต่ก็จะทำให้ความเร็วในการสร้างโทเคนลดลงด้วยเพราะมีขั้นตอนที่มากขึ้นนั่นเอง
- ใน llama.cpp ใช้พารามิเตอร์ -ngl หรือ –n-gpu-layers เพื่อระบุจำนวนชั้นที่ยกไป GPU
- ใน Ollama และ GUI บางตัวมีตัวเลือก “GPU layers” หรือตั้งค่าอัตโนมัติ
- ใน LM Studio จะมีเมนูให้ผู้ใช้เลือกได้เลยว่าต้องการให้โมเดลอยู่ใน VRAM ทั้งหมด (ถ้าพอ) และถ้าไม่พอจะใช้บน GPU กี่เลเยอร์ และย้ายไปให้ CPU ช่วยทำงานกี่เลเยอร์
ถ้าโหลดได้ทั้งโมเดล ก็ตั้งให้ offload ทุกชั้น แต่ถ้า VRAM ไม่พอ จะเลือกยกไปเฉพาะบางชั้น ส่วนที่เหลือรันบน CPU โดยใช้ RAM ของระบบ
| สถานการณ์ | ผลที่ได้ |
|---|---|
| VRAM พอทั้งหมด | เร็วที่สุด เพราะทุกชั้นอยู่บน GPU |
| VRAM ไม่พอ ยกไปบางส่วน | ช้ากว่า เพราะบางชั้นต้องรอข้อมูลจาก CPU/RAM |
| VRAM น้อยมาก ทำงานได้ไม่กี่ชั้น | ช้ามาก แต่ยังรันได้ |
หน่วยความจำระบบ (RAM) ก็สำคัญ
หัวข้อที่มีชื่อว่า “หน่วยความจำระบบ (RAM) ก็สำคัญ”เมื่อมีเลเยอร์ของโมเดลที่รันบน CPU น้ำหนักส่วนนั้นต้องอยู่ใน RAM ของระบบ การมี VRAM มาก ๆ ไว้แม้จะเป็นเรื่องดี แต่ในทางปฏิบัติบางครั้งเราก็ไม่สามารถจัดหา GPU ที่มี VRAM มาก ๆ มาใช้งานได้ ดังนั้นการมี RAM เข้ามาเสริมในส่วนนี้ก็จะทำให้การรัน Local AI เป็นไปได้ง่ายขึ้น
ตัวอย่างการใช้ GPU Offload รัน Gemma 4 31B บน GPU 16GB + RAM 32GB: ควรแบ่งเลเยอร์อย่างไร
หัวข้อที่มีชื่อว่า “ตัวอย่างการใช้ GPU Offload รัน Gemma 4 31B บน GPU 16GB + RAM 32GB: ควรแบ่งเลเยอร์อย่างไร”ไม่ควรพยายามใส่ทั้งโมเดลลง GPU 16GB เพราะไฟล์ของโมเดล Gemma 3 31B รุ่น Q4 ขนาดราว 17–17.5GB ใหญ่กว่า VRAM อยู่แล้ว และยังต้องเผื่อพื้นที่ให้ KV Cache, compute buffer และระบบ ทางที่สมเหตุสมผลคือนำบางส่วนของโมเดลราว 40–44 เลเยอร์ขึ้น GPU และให้ 16–20 เลเยอร์ที่เหลือทำงานบน CPU โดยควรจำกัด context ที่ประมาณ 8K tokens ดังนี้
Gemma 4 31B รุ่น Q4/Q4_0 มีน้ำหนักโมเดลราว 17.5GB ตามตารางอ้างอิงของ Google และมีโครงสร้างแบบ dense จำนวน 60 layers
KV Cache ของ Gemma 4 31B มีขนาดราว 80KiB ต่อโทเค็น เมื่อเก็บเป็น BF16 ดังนั้น context ยิ่งยาว พื้นที่ VRAM ที่เหลือยิ่งถูกกินเร็ว
ลองคำนวณการใช้ VRAM
หัวข้อที่มีชื่อว่า “ลองคำนวณการใช้ VRAM”สมมติว่าเป็น GPU 16GB ที่ใช้เป็นการ์ดจอหลักด้วย ควรเผื่อ VRAM ให้ Windows/display driver และ runtime ประมาณ 1–1.5GB
| รายการ | พื้นที่โดยประมาณ |
|---|---|
| VRAM รวม | 16GB |
| หัก OS/display/CUDA, ROCm, Vulkan | -1.5GB |
| VRAM ใช้งานได้จริง | 14.5GB |
| Compute buffers / activation | -1.0GB |
| KV Cache สำหรับ context 8K | -0.65GB |
| เหลือสำหรับน้ำหนักโมเดล | 12.85GB |
จากน้ำหนักโมเดลรวม 17.5GB จะได้สัดส่วนที่ใส่ GPU ได้ประมาณ:
- 12.85÷17.5≈0.73
เมื่อโมเดลมี 60 layers จึงประมาณได้ว่า:
- 60×0.73≈44 layers
ดังนั้นค่าที่แนะนำเป็นจุดเริ่มต้นคือ -ngl 44 หรือประมาณ 44 เลเยอร์บน GPU และ 16 เลเยอร์บน CPU
ตัวอย่างการแบ่งเลเยอร์
หัวข้อที่มีชื่อว่า “ตัวอย่างการแบ่งเลเยอร์”| Context window | KV Cache โดยประมาณ | เลเยอร์บน GPU | เลเยอร์บน CPU | ความเหมาะสม |
|---|---|---|---|---|
| 4K tokens | ~0.33GB | 46–48 | 12–14 | เร็วขึ้นเล็กน้อย แต่ context สั้น |
| 8K tokens | ~0.65GB | 44 | 16 | สมดุลที่สุดสำหรับเครื่องนี้ |
| 16K tokens | ~1.3GB | 40–42 | 18–20 | ใช้ได้ แต่ช้าลงชัดเจน |
| 32K tokens | ~2.6GB | 36–38 | 22–24 | เริ่มไม่คุ้ม ควรลดขนาดโมเดล |
| 128K–256K | หลาย GB ถึง ~22GB | ไม่เหมาะ | ไม่เหมาะ | ไม่แนะนำบน VRAM 16GB |
ตัวเลข KV Cache ที่ 256K สามารถโตถึงราว 22GB ใน BF16 ซึ่งมากกว่า VRAM 16GB ทั้งการ์ด จึงไม่ควรตั้ง context ยาวแบบนี้กับโมเดล 31B บนเครื่องนี้[issoh.co]
ตัวอย่างคำสั่ง llama.cpp / Ollama-style
หัวข้อที่มีชื่อว่า “ตัวอย่างคำสั่ง llama.cpp / Ollama-style”สำหรับ llama.cpp อาจรันประมาณนี้:
llama-server \ -m gemma-4-31b-it-Q4_K_M.gguf \ -ngl 44 \ -c 8192 \ --flash-attn \ --host 0.0.0.0 \ --port 8080ความหมายสำคัญ:
- -ngl 44: ให้ GPU รับ 44 transformer layers
- -c 8192: จำกัด context window ที่ 8,192 tokens
- ที่เหลือคือ 16 layers จะถูกประมวลผลบน CPU/RAM
- RAM 32GB น่าจะพอสำหรับส่วน CPU layers, OS และ runtime แต่ไม่ควรเปิดโปรแกรมหนัก ๆ ควบคู่ไปด้วย
ข้อควรระวังด้านความเร็ว
หัวข้อที่มีชื่อว่า “ข้อควรระวังด้านความเร็ว”การ offload แบบนี้ทำให้โมเดลรันได้ แต่ความเร็วจะถูกจำกัดด้วย CPU และแบนด์วิดท์ RAM เพราะทุกครั้งที่สร้าง token ต้องสลับการคำนวณระหว่าง GPU และ CPU
ถ้าเป้าหมายคือใช้งานแบบ interactive เช่น chat หรือเขียนโค้ด ควรพิจารณา:
- ใช้ Gemma 4 12B Q4 แทน จะใส่ลง GPU 16GB ได้สบายกว่าและเหลือพื้นที่สำหรับ context ยาวขึ้น
- ใช้ Gemma 4 26B-A4B ซึ่งเป็น MoE น้ำหนัก Q4 ราว 14.4GB แต่ active parameters น้อยกว่า ทำให้เหมาะกับ GPU 16GB มากกว่า 31B
- ถ้าต้องใช้ 31B จริง ๆ ควรมี GPU 24GB ขึ้นไป และยังต้องจำกัด context ไม่ให้ยาวเกินไป
ทางเลือกเมื่อหน่วยความจำไม่พอ
หัวข้อที่มีชื่อว่า “ทางเลือกเมื่อหน่วยความจำไม่พอ”- ลด Quantization จาก Q5 เป็น Q4 หรือ Q3 เพื่อลดขนาดน้ำหนัก
- ลด context เพื่อลด KV cache ให้พอดีงานจริง
- ลด batch ถ้าไม่ได้ให้บริการหลายผู้ใช้พร้อมกัน
- ทำ GPU offload แบบบางส่วน ยอมรับความเร็วที่ช้าลงเพื่อให้รันได้
- ใช้หลาย GPU กระจายชั้นข้ามการ์ด โดยต้องดูว่า backend รองรับหรือไม่
เช็กลิสต์ก่อนรันโมเดล
หัวข้อที่มีชื่อว่า “เช็กลิสต์ก่อนรันโมเดล”- เปิดสเปกหน่วยความจำของการ์ดคุณ
- คำนวณขนาดน้ำหนักจาก params × bpw ÷ 8
- ประเมิน KV cache จากความยาว context ที่จะใช้
- เผื่อ overhead อีกหนึ่งถึงสอง GB
- ถ้าไม่พอ ลด Quantization หรือ context ก่อน แล้วค่อยใช้ GPU offload
- วัด TTFT และ TPS จริงเพื่อยืนยันว่าค่าที่ตั้งได้ผลตามต้องการ