รีวิว Intel Arc Pro B70 32 GB กับการทำงานด้าน Local LLM
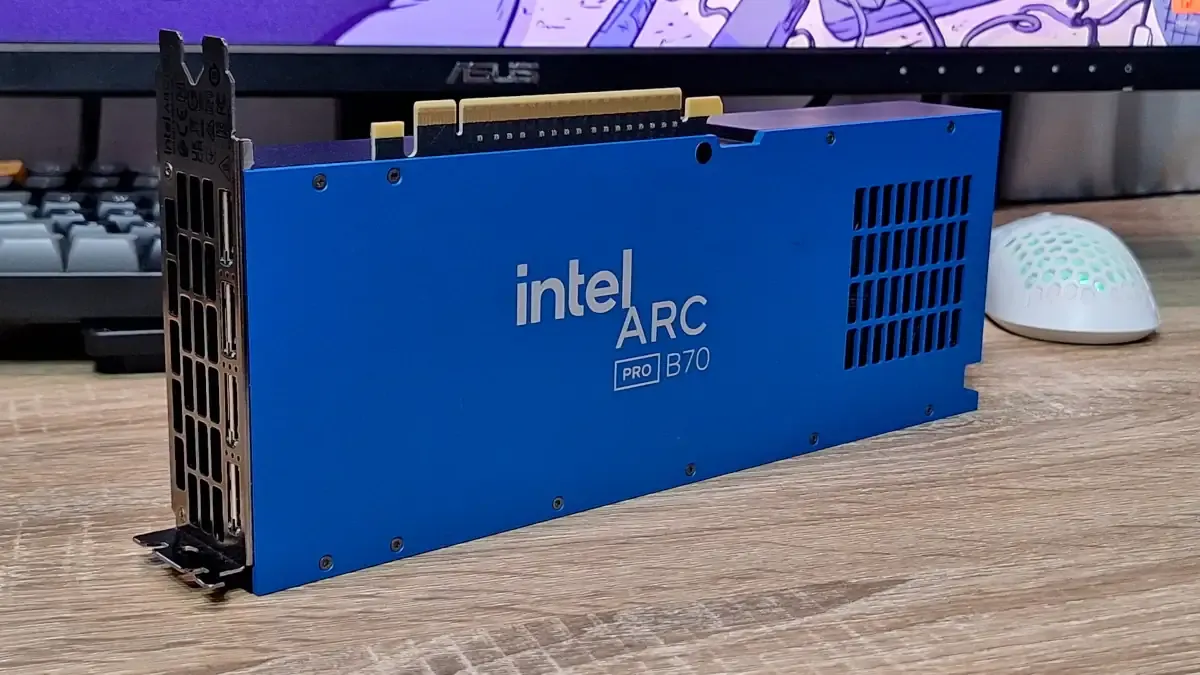
ถ้าพูดถึงการ์ดจอที่มี VRAM 32 GB ในราคาที่ยังพอเอื้อมถึง Intel Arc Pro B70 น่าจะเป็นชื่อที่หลายคนที่สนใจ Local AI เริ่มหยิบมาดูกันแล้วครับ เพราะทุกวันนี้โมเดลที่คนอยากรันเองขยับจากระดับ 7B–14B ขึ้นมาอยู่ที่ 27B–35B และสถาปัตยกรรม MoE ก็กลายเป็นเรื่องปกติ ปัญหาแรกที่ทุกคนเจอตอนนี้ไม่ใช่เรื่องความแรงของตัว GPU โดยตรง แต่เป็น VRAM ว่าจะพอใส่ทั้งโมเดลและ context ยาว ๆ หรือเปล่า การ์ดสำหรับผู้ใช้ทั่วไปส่วนใหญ่จะมี VRAM ที่ 16 GB หรือ 24 GB ส่วนทางออกเดิมคือการ์ดเวิร์กสเตชันหรือ Data Center ที่ราคาสูงกว่ามาก
Intel Arc Pro B70 เข้ามาเติมช่องว่างนี้ ตัวการ์ดใช้ชิป BMG-G31 ของสถาปัตยกรรม Xe2-HPG (Battlemage) เต็มตัว มาพร้อม GDDR6 ขนาด 32 GB แบบรองรับ ECC โดยใช้พลังงานราว 230 วัตต์ สำหรับการ์ดจอรุ่นนี้ทางอินเทล ประเทศไทยได้ส่งให้ผมมาทดสอบโดยไม่มีข้อผู้มัดใด ๆ
ก่อนไปดูรายละเอียดอื่น ๆ เรามาดูคุณสมบัติทั่วไปของการ์ดรุ่นนี้กันก่อนครับ
Intel Arc Pro B70 มีอะไรให้ใช้งานด้าน AI บ้าง
หัวข้อที่มีชื่อว่า “Intel Arc Pro B70 มีอะไรให้ใช้งานด้าน AI บ้าง”| คุณสมบัติ (Specifications) | รายละเอียดทางเทคนิค |
|---|---|
| GPU Architecture | Xe2-HPG (Battlemage), ชิป BMG-G31 (ฟูลดาย) |
| กระบวนการผลิต | TSMC N5 (ระดับ 5nm) |
| Xe2 Cores | 32 คอร์ (8 Render Slices) |
| Vector Engines | 256 ชุด (256-bit) |
| XMX Engines | 256 ชุด (systolic array 512-bit) |
| พลังประมวลผล | FP32 22.94 TFLOPS · FP16/BF16 (Matrix) ~183 TFLOPS · INT8 (Dense) 367 TOPS |
| ความจุ VRAM | 32 GB GDDR6 รองรับ ECC |
| Memory Bus / Bandwidth | 256-bit / 19 Gbps / 608 GB/s |
| Interface | PCIe 5.0 x16 |
| พลังงาน (TBP) | 230 W (ปรับได้ 160–290 W) |
| ไฟเลี้ยง | 1× 8-pin PCIe |
| ราคาอ้างอิง | ~990 - 1,110 USD (ราคาช่วงเปิดตัว) |
แบนด์วิดท์ 608 GB/s มาจากบัส 256-bit คูณกับความเร็ว 19 Gbps ซึ่งในทางทฤษฎีพอจะดัน decode ของโมเดล dense ขนาด 27B–31B ได้ราว 34–36 tok/s ถ้าไม่มีอะไรมาขวาง ส่วน XMX เอนจินรองรับข้อมูลตั้งแต่ FP64 ลงไปถึง INT8 และ INT4 พลังคำนวณด้านเมทริกซ์ถือว่าเหลือเฟือสำหรับงาน GEMM ของ LLM ซึ่งเดียวเราจะได้เห็นว่าช่วง prefill ที่ทำงานจริง กับสเปคที่อินเทลบอกมานั้นเป็นอย่างไร
ก็ย้ำเหมือนเดิม VRAM 32 GB ไม่ได้มีไว้เก็บน้ำหนักโมเดลอย่างเดียว ยังต้องเผื่อ KV Cache ที่โตตาม context และบัฟเฟอร์ของรันไทม์ด้วย ซึ่งเราจะได้เห็นตัวเลขจริงตอนทดสอบด้วย prompt ขนาด 128K ครับ
อย่าลืมเปิด Resizable BAR
หัวข้อที่มีชื่อว่า “อย่าลืมเปิด Resizable BAR”ตรงนี้ต้องเน้นไว้ก่อนครับ สถาปัตยกรรม Xe ของอินเทลนั้นเข้าถึง VRAM จากฝั่ง CPU ผ่าน ReBAR ได้โดยตรง ถ้าเอาการ์ดไปลงเมนบอร์ดรุ่นเก่าที่ไม่รองรับ หรือปิด ReBAR ไว้ใน BIOS หน้าต่างที่ทำให้ CPU มองเห็นข้อมูลจาก VRAM จาก 16GB จะหดเหลือ 256 MB ประสิทธิภาพและการโหลดโมเดลจะตกลงมากจนใช้งานลำบาก ReBAR จึงไม่ใช่ตัวเลือกเสริมความเร็ว แต่เป็นข้อกำหนดพื้นฐานของการ์ดใบนี้ครับ การ์ดจอเล่นเกมของอินเทลเองก็เช่นกันครับต้องเปิดค่านี้ไว้เพื่อประสิทธิภาพการสื่อสารข้อมูลสูงสุด
การออกแบบและโครงสร้างของตัวการ์ดจอ
หัวข้อที่มีชื่อว่า “การออกแบบและโครงสร้างของตัวการ์ดจอ”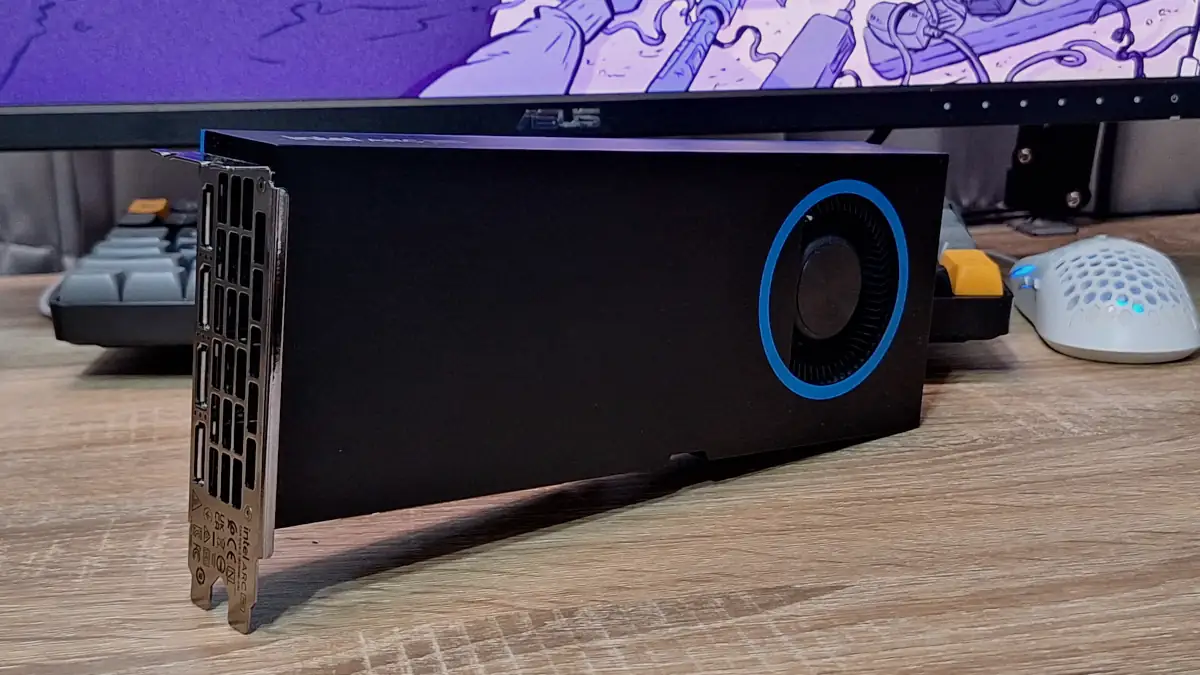
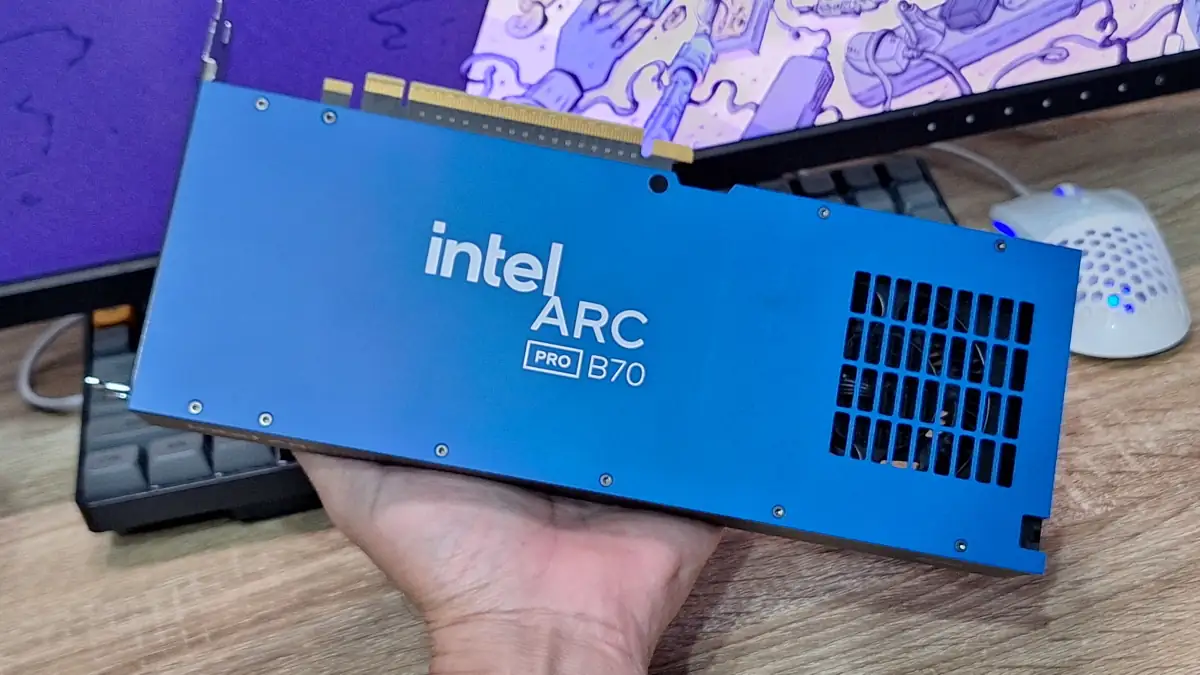
Intel Arc Pro B70 เป็นการ์ดที่ถูกออกแบบมาสำหรับใช้งานในเครื่องระดับเวิร์คสเตชันอย่างแท้จริงด้วยดีไซน์แนวอุตสาหกรรม การ์ดทรงเหลี่ยม ๆ สองสล๊อตพร้อมพัดลมระบายวามร้อนแบบโบลเวอร์ ที่ดูมีสีสันหน่อยก็คือ backplate ด้านหลังทำออกมาเป็นโทนสีน้ำเงิน สกรีนข้อความ Intel ARC PRO B70
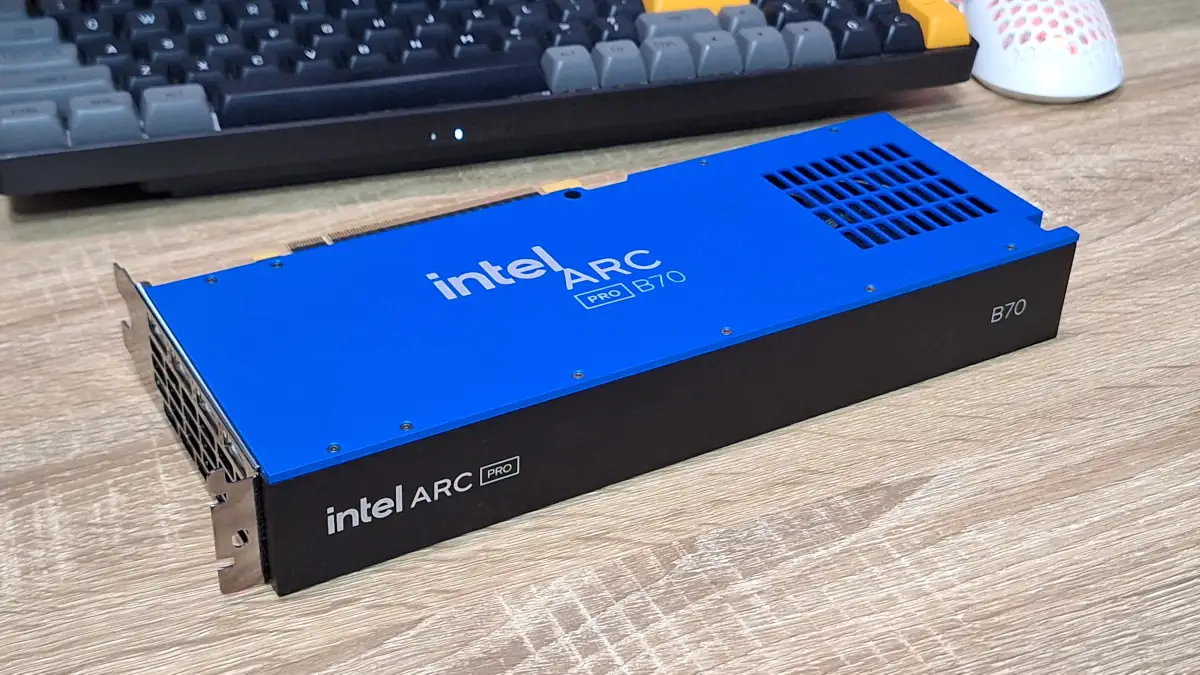
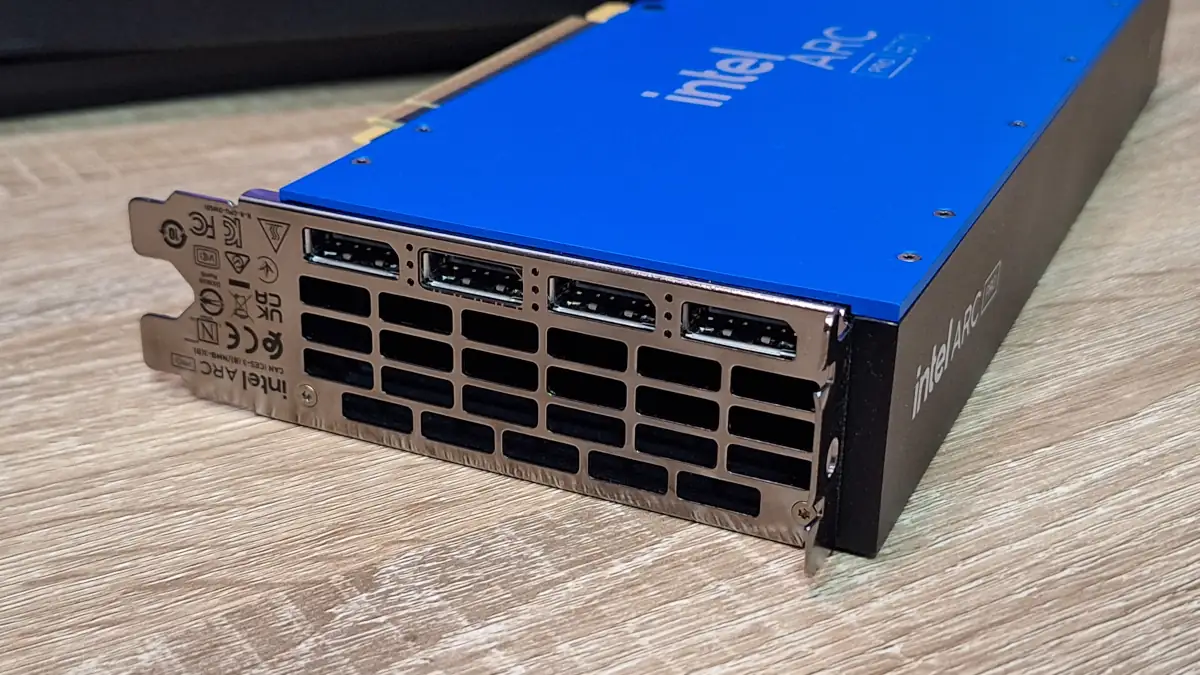
การ์ดรุ่นนี้ไม่ได้ตอบโจทย์คนใช้งานด้าน Local AI เท่านั้น แต่อินเทลยังคงรักษาการ์ดรุ่นนี้ไว้ให้กับผู้งานงานในกลุ่มกราฟิกระดับมืออาชีพและงานวิดีโอระดับมืออาชีพด้วยเช่นกัน โดยยังคงมี DisplayPort มาให้ถึง 4 ช่อง ตามสไตล์ของการ์ดจอระดับมืออาชีพ
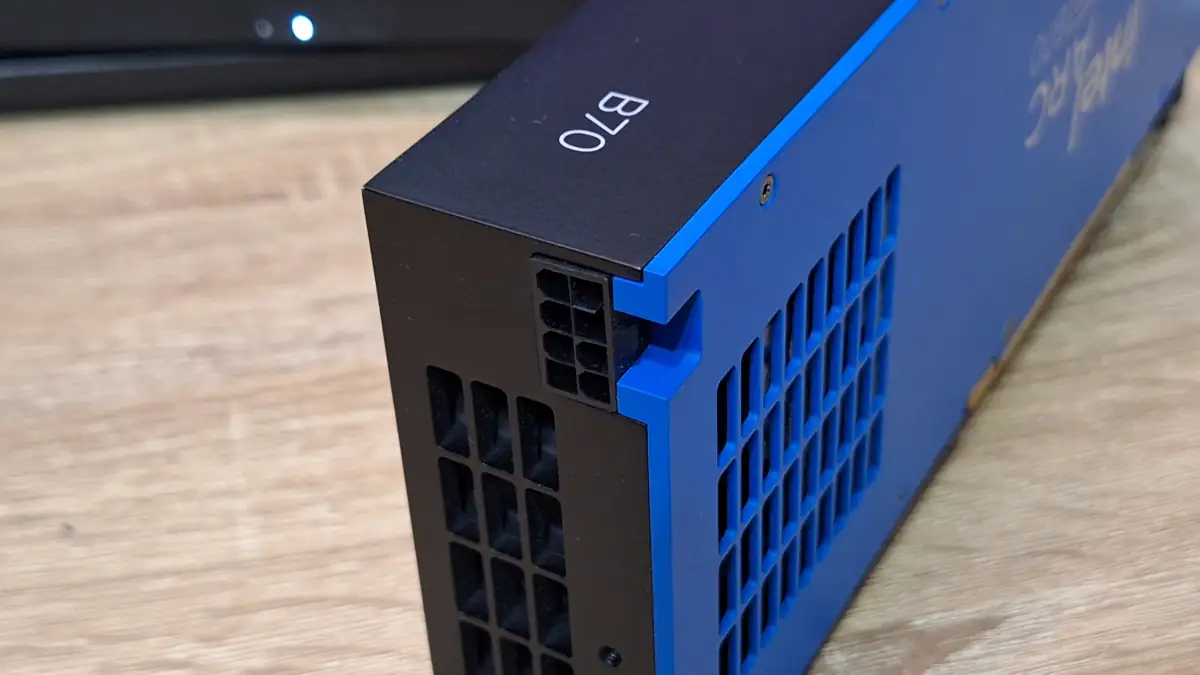
ที่น่าสนใจและหลายคนน่าจะชอบก็คือด้วยตัวการ์ดเองใช้พลังงานอยู่ราว ๆ 230W ดังนั้นช่องต่อไฟเพิ่มจึงเป็นเพียงคอนเน็คเตอร์แบบ 8 Pin เพียงหนึ่งตัวเท่านั้น ใครที่มีพาวเวอร์ซัพพลายรุ่นเก่าก็สามารถใช้งานได้โดยไม่ต้องอัปเกรด ขอให้จ่ายไฟได้เต็มประสิทธิภาพก็พอ
โมเดลและวิธีทดสอบ
หัวข้อที่มีชื่อว่า “โมเดลและวิธีทดสอบ”| โมเดลทดสอบ | สถาปัตยกรรม / Quant | ขนาดไฟล์ (GB) | จุดประสงค์ในการทดสอบ |
|---|---|---|---|
| Gemma-4-31B-it-QAT | Dense / Q4_0 | 17.65 | Compute Performance & VRAM Stress |
| Gemma-4-26B-A4B-it-QAT | MoE (active ~4B) / Q4_0 | 14.44 | Throughput, Memory Bandwidth |
| Gemma-4-12B-it-QAT | Dense / Q4_0 | 6.98 | การใช้งานทั่วไปการ์ดจอระดับแมส (VRAM 8-12GB) |
| Qwen3.6-35B-A3B | MoE (active ~3B) / Q4_K_M | 21.17 | Throughput, Memory Bandwidth |
| Qwen3.8-27B-Q4_K_M | Dense / Q4_K_M | 16.81 | Compute Performance & VRAM Stress |
ทุกโมเดลเป็น Quantized ระดับ 4-bit (Gemma ใช้ Q4_0 จากเวอร์ชัน QAT ส่วน Qwen ใช้ Q4_K_M) ซึ่งจะมีผลกับเรื่อง Vulkan ที่เราจะเล่าในหัวข้อถัดไปครับ
การทดสอบแบ่งเป็นสี่ชุด รวม 25 รัน
- Single-user Small-context (12 รัน): 5 โมเดล × 2 backend รวม 10 รัน บวกรันตรวจสอบซ้ำของ Qwen3.8-27B อีก 2 รัน (ใช้เป็นเบสไลน์ของชุด speculative และได้ตัวเลขตรงกับรันเดี่ยวอย่างแม่นยำ) ตั้ง context 12,288
- Speculative Decoding (6 รัน): Qwen3.8-27B กับ MTP, DFlash และ DFlash2 บนทั้งสอง backend
- Long-Context (3 รัน, 90 การวัดผล): 4K ถึง 128K บน SYCL
- Multi-user Concurrency (4 รัน): C1 ถึง C8 กับ Qwen3.6-35B-A3B และ Qwen3.8-27B บนทั้งสอง backend
ตัวเลขหลักที่ใช้ในบทความนี้ วัด decode จากงาน creative_writing (input 512, output 256), วัด prefill จากงาน summary_8k (input 8,192, output 256) และวัด TTFT จากงาน summary_4k (input 4,096)
เวิร์คโหลดที่ใช้ในการทดสอบ
หัวข้อที่มีชื่อว่า “เวิร์คโหลดที่ใช้ในการทดสอบ”เนื่องจากผลการทดสอบจะมีตารางและตัวเลขจำนวนมาก รวมถึงงานที่เราใช้ทดสอบโมเดลร่วมกับการ์ดจอมีมากถึง 7 รูปแบบ ดังนั้นเราจึงใช้รหัสย่อขึ้นมาเพื่อใช้แทนการเรียกชื่อการทดสอบแบบยาว ๆ และจะทำให้บทความกระชับมากขึ้น
| รหัส | งาน/เวิร์คโหลด | prompt เป้าหมาย (token) | เอาต์พุตสูงสุด (token) |
|---|---|---|---|
| CG-512 | Content Generation | 512 | 256 |
| CW-512 | Creative Writing | 512 | 512 |
| Sum-2K | Summarization | 2,048 | 256 |
| Sum-4K | Summarization | 4,096 | 256 |
| Sum-8K | Summarization | 8,192 | 256 |
| Code-4K | Code Analysis | 4,096 | 256 |
| Thai | Thai Summary | ~1,078–1,391 | 256 |
ที่สำคัญเวิร์คโหลดหรืองานของเราจะทำหน้าที่เป็นตัวควบคุมการทดลองไปด้วยในตัวครับ เช่น CG-512 กับ CW-512 ใช้ prompt ยาวเท่ากัน (512 token) ต่างกันแค่ความยาวเอาต์พุต ส่วน Sum-4K กับ Code-4K ใช้ทั้ง prompt และเอาต์พุตเท่ากัน ต่างกันแค่ชนิดงาน เมื่อเอามาเทียบกันจะทำให้เรามองเห็นเรื่องของความยาว prompt และชนิดของงานด้วยว่าจะส่งผลต่อการทดสอบอย่างไร โจทย์ภาษาไทยเราไม่สามารถระบุตัวเลขแบบตรงตัวได้เนื้องจากแต่ละโมเดลจะมีการตัดคำภาษาไทยไม่เหมือนกันทำให้จำนวนโทเคนที่ใช้ไม่เท่ากันด้วยครับ แต่เราสามารถกำหนดตัดจบคำตอบได้ด้วยจำนวนโทเคนตามปกติเหมือนการทดสอบอื่น ๆ
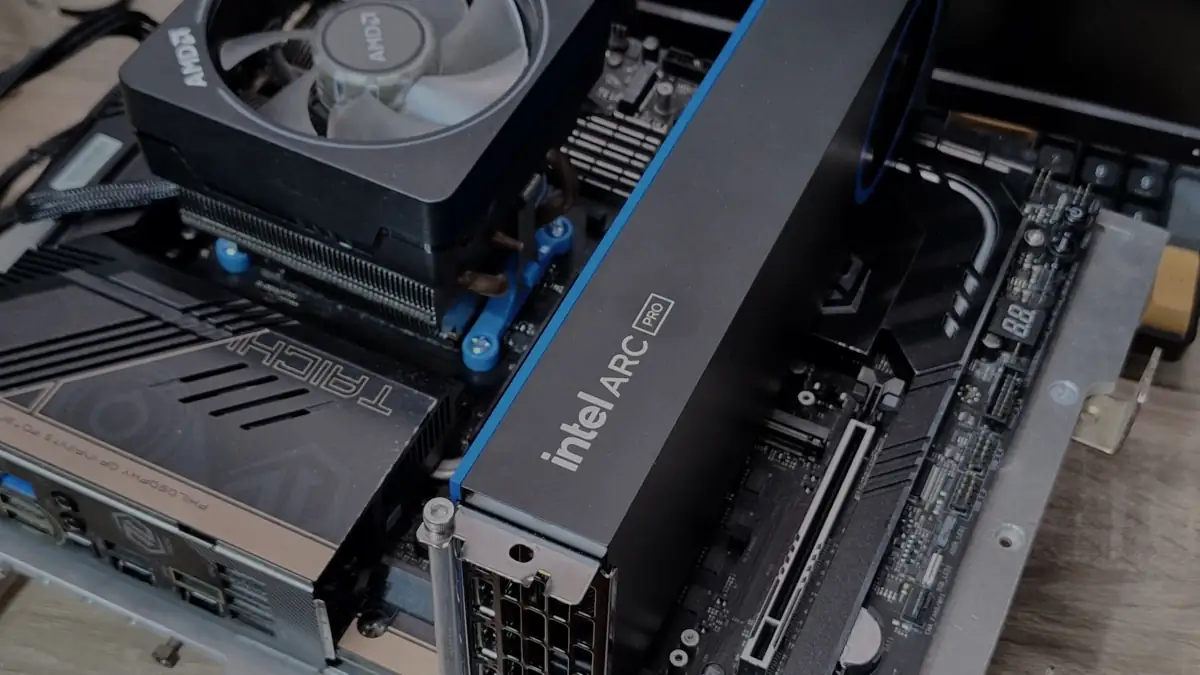
อุปกรณ์ที่ใช้ในการทดสอบ
หัวข้อที่มีชื่อว่า “อุปกรณ์ที่ใช้ในการทดสอบ”- CPU: AMD Ryzen 7 7700 (8C/16T, Zen 4)
- RAM: DDR5-5200 Dual Channel (16GB x 4) รวม 64 GB
- Mainboard: ASRock X670E Taichi (BIOS 3.40, AGESA 1.2.0.2)
- GPU: Intel Arc Pro B70 32 GB
ซอฟต์แวร์
หัวข้อที่มีชื่อว่า “ซอฟต์แวร์”- OS: Ubuntu 26.04.1 LTS (Linux Kernel 7.0.0-38-generic)
- llama.cpp v0.6.0-dev build 11429 (commit d81235049)
- PromptMark 0.5.0
- ตั้ง
ngl 999(ส่งทุกเลเยอร์ลง VRAM), ปิด prompt cache และ context shift, decode แบบ greedy (T=0, seed 1234, ignore_eos) - warm-up 1 รอบ แล้ววัดจริง 5 รอบ เว้น 15 วินาทีต่อคำขอ รายงานเป็นค่ามัธยฐาน (median)
- CV% ค่าความผันผวนระหว่างการทดสอบ ไม่ควรเกิน 3% ถ้าเกินถือว่าไม่เสถียรแต่ไม่ได้มีผลต่อคุณภาพคำตอบของโมเดล และไม่มีผลในการใช้งานถ้าเป็นระบบเล็ก ๆ ใช้คนเดียว หรือใช้พร้อมกันสองสามคน เรากำหนดไว้เป็นข้อสังเกตุ
- ตั้ง
ภาพรวม: 5 โมเดล กับ 2 backend
หัวข้อที่มีชื่อว่า “ภาพรวม: 5 โมเดล กับ 2 backend”ก่อนเข้าไปดูทีละประเด็น นี่คือผลหลักของทุกโมเดลในแบบ single-user ครับ
| โมเดล | Quant | Backend | Decode (tok/s) | Prefill 8K (tok/s) | TTFT 4K (วินาที) | VRAM peak (GiB) | ไฟเฉลี่ย (W) | tok/s ต่อวัตต์ |
|---|---|---|---|---|---|---|---|---|
| Gemma 4 12B | Q4_0 | SYCL | 48.42 | 702.5 | 6.64 | 7.78 | 179.0 | 0.243 |
| Gemma 4 12B | Q4_0 | Vulkan | 30.98 | 125.0 | 19.03 | 8.17 | 204.7 | 0.143 |
| Gemma 4 26B-A4B | Q4_0 | SYCL | 58.83 | 1,297.5 | 3.67 | 14.54 | 167.1 | 0.339 |
| Gemma 4 26B-A4B | Q4_0 | Vulkan | 53.85 | 197.6 | 12.14 | 14.73 | 193.3 | 0.287 |
| Qwen3.8-27B | Q4_K_M | SYCL | 26.88 | 796.6 | 5.76 | 16.47 | 218.0 | 0.120 |
| Qwen3.8-27B | Q4_K_M | Vulkan | 11.97 | 436.2 | 8.82 | 15.91 | 221.5 | 0.053 |
| Gemma 4 31B | Q4_0 | SYCL | 22.87 | 268.1 | 17.22 | 19.42 | 189.5 | 0.106 |
| Gemma 4 31B | Q4_0 | Vulkan | 16.99 | 50.1 | 46.50 | 19.35 | 212.0 | 0.077 |
| Qwen3.6-35B-A3B | Q4_K_M | SYCL | 100.08 | 1,041.4 | 4.13 | 20.22 | 150.6 | 0.618 |
| Qwen3.6-35B-A3B | Q4_K_M | Vulkan | 42.52 | 1,101.2 | 3.40 | 19.97 | 178.6 | 0.244 |
(เรียงตามขนาดไฟล์โมเดล · Decode = CW-512, Prefill = Sum-8K, TTFT = Sum-4K · ทุกค่าเป็น median ของ 5 รอบ · ตัวหนา = ค่าที่ดีที่สุดระหว่าง 2 backend ของโมเดลเดียวกัน)
ภาพรวมที่เห็นได้ทันทีคือการใช้ SYCL เป็น backend ชนะเกือบทุกช่อง และ Qwen3.6-35B-A3B บน SYCL ทำได้ 100.08 tok/s ด้วยไฟเฉลี่ยเพียง 150.6 W ส่วนจุดที่ B70 ติดอย่างจัง ๆ คือ prefill ซึ่งจะเล่าในหัวข้อถัดไป
Decode: ความเร็วในการสร้างคำตอบ
หัวข้อที่มีชื่อว่า “Decode: ความเร็วในการสร้างคำตอบ”การ Decode (tg: token generation) ของโมเดลแบบ dense จะไม่สูงเมื่อเทียบกับโมเดลแบบ MoE เพราะต้องอ่านน้ำหนักทั้งโมเดลจาก VRAM หนึ่งรอบต่อหนึ่งโทเค็น ทางทฤษฎีจึงเท่ากับแบนด์วิดท์หารด้วยขนาดไฟล์ ลองคำนวณจากผลบน SYCL ดูครับ
| โมเดล Dense | ขนาดไฟล์ (GB) | แบนด์วิดสูงสุดที่ 608 GB/s (tok/s) | ทำได้จริง (tok/s) | Effective Bandwidth (GB/s) | % ของแบนด์วิดที่ใช้ |
|---|---|---|---|---|---|
| Qwen3.8-27B Q4_K_M | 16.81 | 36.17 | 26.88 | 452.6 | 74.4% |
| Gemma-4-31B Q4_0 | 17.65 | 34.45 | 22.87 | 403.7 | 66.4% |
| Gemma-4-12B Q4_0 | 6.98 | 87.11 | 48.42 | 338.0 | 55.6% |
(สูตร: ขนาดไฟล์ × tok/s = effective bandwidth)
74.4% ของ Qwen3.8-27B ถือว่าน่าพอใจสำหรับฮาร์ดแวร์รุ่นใหม่ แต่ที่ชวนสงสัยคือทำไมโมเดลเล็กอย่าง Gemma-4-12B ถึงดึงแบนด์วิดท์ได้แค่ 55.6% (338 GB/s) ทั้งที่น่าจะอ่านได้ง่ายกว่า คำตอบอยู่ที่เวลาต่อโทเค็นครับ ถ้านำเวลาต่อหนึ่งโทเค็นของสามโมเดลมาเทียบกับขนาดไฟล์
| โมเดล | ขนาดไฟล์ (GB) | เวลาต่อโทเค็น (1000 ÷ tok/s) |
|---|---|---|
| Gemma-4-12B | 6.98 | 20.65 ms |
| Qwen3.8-27B | 16.81 | 37.20 ms |
| Gemma-4-31B | 17.65 | 43.73 ms |
ข้อมูลสามจุดนี้ลากเป็นเส้นตรงได้ผลประมาณว่า
เวลาต่อโทเค็น ≈ 6.84 ms + (1.96 ms/GB × ขนาดโมเดลเป็น GB)
ตัวเลขสองตัวในสมการนี้บอกเรื่องที่ต่างกันมาก ความชัน 1.96 ms/GB แปลงกลับเป็นความเร็วอ่านข้อมูลได้ราว 510 GB/s หรือประมาณ 83.9% ของสเปก 608 GB/s แปลว่าเวลาที่หน่วยความจำกำลังสตรีมน้ำหนัก ตัวควบคุม GDDR6 และแคช L2 ทำงานได้ดีมาก แต่จุดตัดแกนที่ 6.84 ms คือค่าคงที่ที่ทุกโทเค็นต้องจ่าย (เป็นระยะรอของระบบ) ไม่ว่าโมเดลจะเล็กแค่ไหน เวลาส่วนนี้เป็นผลของการสลับคิวคำสั่ง การซิงก์ข้ามเอนจินของไดรเวอร์ xe และ kernel launch latency ตามที่ชุดข้อมูลชี้ (ตัวเลขนี้ได้จากการลากเส้นผ่านสามโมเดล จึงเป็นการประมาณ ไม่ได้วัดตรงจากไดรเวอร์)
ผลที่ตามมาคือ Gemma-4-12B เสียเวลา 6.84 ms จากทั้งหมด 20.65 ms หรือราว 33% หมดไปกับค่านี้ ทั้งที่แบนด์วิดท์น่าจะดันได้ถึง 87 tok/s ถ้าไม่มีภาระส่วนนี้ ยิ่งโมเดลเล็ก B70 ยิ่งใช้แบนด์วิดท์ไม่คุ้มครับ
MoE: โมเดลที่ใช้งานได้ลงตัว
หัวข้อที่มีชื่อว่า “MoE: โมเดลที่ใช้งานได้ลงตัว”โมเดล MoE อ่านเฉพาะ expert ที่ router เลือกต่อโทเค็น ไม่ใช่ทั้งโมเดล ดังนั้นผลที่ Arc Pro B70 ทำได้จึงต่างจากโมเดลแบบ dense ชัดเจน Qwen3.6-35B-A3B บน SYCL ทำ decode ได้ 100.08 tok/s ใช้ไฟเฉลี่ย 150.6 W ได้ประสิทธิภาพ 0.618 tok/s ต่อวัตต์ (คิดเป็น 1.84 จูลต่อโทเค็น) สูงสุดในชุดทดสอบ เทียบกับ Qwen3.8-27B ที่เป็น dense แล้วเร็วกว่า 3.72 เท่า และประหยัดพลังงานต่อโทเค็นดีกว่าเกือบ 5 เท่า ทั้งที่เป็นโมเดลที่ใหญ่กว่าด้วยซ้ำ (เทียบจากจำนวนพารามิเตอร์ทั้งหมด)
| โมเดล MoE | ขนาดไฟล์ (GB) | Active | น้ำหนักที่อ่านต่อโทเค็น (GB) | Decode (tok/s) | Bandwidth ที่ใช้จริง (GB/s) | % ของ 608 GB/s |
|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B | 21.17 | ~3B | ~1.82 | 100.08 | 182.1 | 29.9% |
| Gemma-4-26B-A4B | 14.44 | ~4B | ~2.23 | 58.83 | 131.2 | 21.6% |
สิ่งที่ตารางนี้บอกคือ MoE บน B70 ไม่ได้ติดที่บัสหน่วยความจำเลย ใช้แบนด์วิดท์เพียง 21.6–29.9% ของสเปก ที่ 100 tok/s เวลาต่อโทเค็นคือ 10.0 ms ถ้าหักค่าคงที่ 6.84 ms จากหัวข้อที่แล้ว เวลาสตรีมน้ำหนัก 1.82 GB จริง ๆ เหลือเพียงราว 3.16 ms ซึ่งเทียบเท่าการอ่านที่ประมาณ 575 GB/s เลยทีเดียว นั่นเป็นเหตุผลที่ชุดข้อมูลประเมินว่า ถ้า Intel ลด kernel overhead ของ Level Zero ลงได้ครึ่งหนึ่ง decode ของ MoE บนการ์ดใบนี้อาจขึ้นไป 150–180 tok/s ได้ (นี่เป็นการประมาณจากสมการข้างบน ไม่ใช่ผลวัดจริงนะครับ)
SYCL กับ Vulkan: ช่องว่างที่กว้างกว่าที่คิด
หัวข้อที่มีชื่อว่า “SYCL กับ Vulkan: ช่องว่างที่กว้างกว่าที่คิด”ฝั่ง Linux มีสองทางให้เลือกรัน ทางแรกคือ SYCL ซึ่งเป็น backend ทางการของ Intel (oneAPI + Level Zero) อีกทางคือ Vulkan ผ่านไดรเวอร์โอเพนซอร์ส Mesa ANV ผลทดสอบของเราคือ
| โมเดล | Quant | Decode SYCL | Decode Vulkan | ต่างกัน | Prefill 8K SYCL | Prefill 8K Vulkan | ต่างกัน |
|---|---|---|---|---|---|---|---|
| Gemma 4 31B | Q4_0 | 22.87 | 16.99 | SYCL เร็วกว่า 1.35× | 268.1 | 50.1 | SYCL เร็วกว่า 5.35× |
| Gemma 4 26B-A4B | Q4_0 | 58.83 | 53.85 | SYCL เร็วกว่า 1.09× | 1,297.5 | 197.6 | SYCL เร็วกว่า 6.56× |
| Gemma 4 12B | Q4_0 | 48.42 | 30.98 | SYCL เร็วกว่า 1.56× | 702.5 | 125.0 | SYCL เร็วกว่า 5.62× |
| Qwen3.6-35B-A3B | Q4_K_M | 100.08 | 42.52 | SYCL เร็วกว่า 2.35× | 1,041.4 | 1,101.2 | Vulkan เร็วกว่า 1.05× |
| Qwen3.8-27B | Q4_K_M | 26.88 | 11.97 | SYCL เร็วกว่า 2.25× | 796.6 | 436.2 | SYCL เร็วกว่า 1.83× |
(หน่วยเป็น tok/s · ตัวหนา = ค่าที่ดีกว่า)
รูปแบบในตารางชัดมากครับ บนโมเดล Qwen ที่ใช้ Q4_K_M, Vulkan ทำ prefill ได้ใกล้เคียง SYCL (บน Qwen3.6 ชนะเล็กน้อยด้วยซ้ำ) แต่บนโมเดล Gemma ที่เป็น Q4_0, prefill ของ Vulkan ต่ำกว่า SYCL ถึง 5–6 เท่า จุดที่หนักที่สุดคือ Gemma 31B ที่ prefill เหลือ 50.1 tok/s ทำให้ TTFT ที่ 4K ไปถึง 46.50 วินาที ขณะที่ SYCL ใช้ 17.22 วินาที
สาเหตุที่ชุดข้อมูลสันนิษฐานคือเรื่องเคอร์เนล GEMM ของ Mesa ANV 26.0.8 ครับ รูปแบบ k-quant (Q4_K_M) ใช้โครงสร้าง super-block ซึ่งคอมไพล์ผ่าน SPIR-V ได้ดีกว่า ส่วน Q4_0 แบบดั้งเดิมพึ่งเคอร์เนลแบบ dequantize-and-multiply ตรง ๆ ซึ่งเป็นไปได้ว่าคอมไพเลอร์ของไดรเวอร์ยังจัดคำสั่งเข้าเอนจิน XMX ไม่ได้ การคำนวณจึงตกกลับไปวิ่งบน Vector Engine ธรรมดา (นี่คือข้อสันนิษฐานจากรูปแบบของผลทดสอบ ไม่ได้ตรวจในระดับ shader) สรุปสั้น ๆ คือ ตอนนี้ Vulkan บน B70 ใช้งานจริงกับ Q4_0 ไม่ไหว ส่วนโมเดล Q4_K_M ก็ยังเป็นรองในด้าน decode อยู่ดี
แต่ SYCL มีจุดอ่อนเรื่องเวลาโหลดโมเดล
หัวข้อที่มีชื่อว่า “แต่ SYCL มีจุดอ่อนเรื่องเวลาโหลดโมเดล”ข้อเสียที่น่ารำคาญที่สุดของ SYCL อยู่นอกตารางความเร็วครับ คือเวลาโหลดโมเดลเข้า VRAM
| โมเดล | ขนาดไฟล์ (GB) | โหลดด้วย SYCL (s) | โหลดด้วย Vulkan (s) | อัตราถ่ายโอน SYCL (MB/s) | อัตราถ่ายโอน Vulkan (MB/s) |
|---|---|---|---|---|---|
| Gemma 4 12B | 6.98 | 11.52 | 3.14 | 606 | 2,223 |
| Gemma 4 26B-A4B | 14.44 | 24.54 | 4.73 | 588 | 3,053 |
| Qwen3.8-27B | 16.81 | 27.05 | 5.19 | 621 | 3,239 |
| Gemma 4 31B | 17.65 | 28.04 | 5.47 | 629 | 3,227 |
| Qwen3.6-35B-A3B | 21.17 | 34.56 | 6.14 | 613 | 3,448 |
Vulkan ส่งข้อมูลผ่าน PCIe 5.0 x16 ได้ราว 3.2–3.4 GB/s (โหลดโมเดล 21 GB ใน 6 วินาทีเศษ) แต่ SYCL ค้างอยู่ที่ราว 613 MB/s คงที่ทุกโมเดล โมเดลใหญ่จึงต้องรอเกือบ 35 วินาทีทุกครั้งที่สลับโมเดล ถ้าคุณเป็นคนที่เปลี่ยนโมเดลบ่อย ๆ ตรงนี้จะรู้สึกชัดครับ แต่คิดว่าการใช้งานจริงคนทั่วไปคงไม่ได้มานั่งเปลี่ยนโมเดลบ่อย ๆ เหมือนการทดสอบอยู่แล้วครับ
Prefill และ TTFT: จุดที่การ์ดยังไปไม่ถึง
หัวข้อที่มีชื่อว่า “Prefill และ TTFT: จุดที่การ์ดยังไปไม่ถึง”ถ้าต้องชี้ว่าอะไรทำให้ B70 ยังขึ้นไปสู้การ์ดเวิร์กสเตชันระดับบนไม่ได้เต็มที่ คำตอบคือ prefill ครับ งานนี้คือการคูณเมทริกซ์ขนาดใหญ่ระหว่าง prompt กับน้ำหนักโมเดล ซึ่งเป็นงานแบบ compute-bound เต็มตัว เราประมาณปริมาณการคำนวณจริงได้จาก
FLOPs ≈ 2 × active parameters × prefill tok/s
แล้วเทียบกับ FP16 matrix peak ของการ์ดที่ประมาณ 183 TFLOPS (ใช้ผลบน SYCL)
| โมเดล | ชนิด | Prefill (tok/s) | พลังคำนวณที่ใช้จริง (TFLOPS) | % ของ peak |
|---|---|---|---|---|
| Qwen3.8-27B | Dense (27B) | 796.6 | ~43.0 | 23.5% |
| Gemma 4 12B | Dense (12B) | 702.5 | ~16.9 | 9.2% |
| Gemma 4 31B | Dense (31B) | 268.1 | ~16.6 | 9.1% |
| Qwen3.6-35B-A3B | MoE (~3B active) | 1,041.4 | ~6.2 | 3.4% |
ใน prefill ซิลิคอน XMX ถูกใช้ไปเพียง 3%–23% ของที่มีอยู่เท่านั้นครับ ที่เหลือหายไปกับการจัดตารางงาน การจัดการแคช L2 และการแปลงความกว้างเวกเตอร์ในรันไทม์ ตามที่ชุดข้อมูลวิเคราะห์ (ค่านี้เป็นการประมาณจากสูตรข้างบน ไม่ได้วัดจาก hardware counter) นั่นคือเหตุผลที่ฮาร์ดแวร์ที่มีพลังคำนวณสูงขนาดนี้กลับได้ prefill เพียง 268–1,297 tok/s
ผลต่อผู้ใช้คือ TTFT ที่ยาวกว่าที่ควร ตารางนี้สรุปบน SYCL ตามขนาด prompt
| งาน | ความยาว prompt | TTFT บน B70 (SYCL) | ความรู้สึกในการใช้งาน |
|---|---|---|---|
| แชททั่วไป | 512 โทเค็น | 0.74 – 1.39 วินาที (MoE / 27B) | ตอบสนองเป็นธรรมชาติ |
| ป้อนบริบทภาษาไทย | ~1,000 ตัวอักษร | 1.30 – 2.47 วินาที | ลื่นไหล |
| ถาม-ตอบเอกสาร (RAG) | 4,096 โทเค็น | 3.67 – 17.22 วินาที | เริ่มรู้สึกว่าต้องรอ |
| สรุปรายงานยาว / วิเคราะห์โค้ด | 8,192 โทเค็น | 6.72 – 31.81 วินาที | ช้าชัดเจน โดยเฉพาะ Gemma 31B ที่รอครึ่งนาที |
| อ่านเอกสารทั้งเล่ม | 128,000 โทเค็น | 212.9 – 230.2 วินาที | เหมาะกับงาน batch เท่านั้น |
ถ้างานของคุณคือแชทหรือถามสั้น ๆ B70 ไม่มีปัญหาเลย แต่ถ้าต้องป้อนเอกสารยาว ๆ วนเป็นรอบ ๆ (เช่น RAG แบบ agent) เวลารอโทเค็นแรกคือสิ่งที่จะกลายเป็นคอขวด
ลองดัน context ไปถึง 128K
หัวข้อที่มีชื่อว่า “ลองดัน context ไปถึง 128K”เหตุผลหลักที่หลายคนยอมจ่ายเพื่อ VRAM 32 GB คือ context ยาว เราจึงรันชุด Long-Context บน SYCL สามรัน (90 การวัดผล) ตั้งแต่ 4K ถึง 131,840 โทเค็น (128K) โดยใช้ KV cache แบบ FP16 เต็ม ทดสอบ Gemma 4 12B, Qwen3.8-27B ปกติ และ Qwen3.8-27B ที่เปิด DFlash2
Prefill (tok/s)
| โมเดล | Quant | Backend | โหมด | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|---|---|---|
| Gemma 4 12B | Q4_0 | SYCL | Normal | 670.7 | 702.5 | 712.1 | 706.0 | 667.6 | 605.2 |
| Qwen3.8-27B | Q4_K_M | SYCL | Normal | 761.1 | 792.1 | 792.8 | 775.1 | 716.0 | 622.0 |
| Qwen3.8-27B | Q4_K_M | SYCL | DFlash2 | 668.3 | 705.1 | 709.6 | 697.4 | 652.1 | 574.8 |
(หน่วยเป็น tok/s · ตัวหนา = ค่าที่ 128K · median ของ 5 รอบ · context 131,840)
Decode (tok/s)
| โมเดล | Quant | Backend | โหมด | 4K | 8K | 16K | 32K | 64K | 128K | ลดลง (4K → 128K) |
|---|---|---|---|---|---|---|---|---|---|---|
| Gemma 4 12B | Q4_0 | SYCL | Normal | 44.15 | 43.13 | 40.98 | 37.57 | 32.23 | 25.07 | -43.2% |
| Qwen3.8-27B | Q4_K_M | SYCL | Normal | 25.80 | 24.60 | 22.43 | 19.16 | 14.93 | 10.40 | -59.7% |
| Qwen3.8-27B | Q4_K_M | SYCL | DFlash2 | 36.24 | 36.98 | 32.83 | 33.32 | 28.43 | 24.09 | -33.5% |
(หน่วยเป็น tok/s · ลดลง = เทียบ 4K กับ 128K)
TTFT (วินาที)
| โมเดล | Quant | Backend | โหมด | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|---|---|---|
| Gemma 4 12B | Q4_0 | SYCL | Normal | 7.5 | 12.2 | 23.6 | 47.1 | 98.9 | 217.8 (3.6 นาที) |
| Qwen3.8-27B | Q4_K_M | SYCL | Normal | 5.4 | 10.9 | 21.2 | 43.3 | 92.7 | 212.9 (3.5 นาที) |
| Qwen3.8-27B | Q4_K_M | SYCL | DFlash2 | 6.1 | 12.2 | 23.6 | 48.0 | 101.7 | 230.2 (3.8 นาที) |
(หน่วยเป็นวินาที · ความละเอียดตามข้อมูลต้นทางของรีวิวนี้ 1 ตำแหน่ง)
VRAM และพลังงาน
| โมเดล | Quant | Backend | โหมด | VRAM peak (GiB) | VRAM คงเหลือ (GiB) | ไฟเฉลี่ย (W) | Draft acceptance |
|---|---|---|---|---|---|---|---|
| Gemma 4 12B | Q4_0 | SYCL | Normal | 9.72 | 22.17 | 183.3 | – |
| Qwen3.8-27B | Q4_K_M | SYCL | Normal | 23.73 | 8.16 | 223.5 | – |
| Qwen3.8-27B | Q4_K_M | SYCL | DFlash2 | 26.07 | 5.82 | 211.4 | 55.2% |
(ค่าที่ 128K · ตัวหนา = VRAM peak สูงสุด)
มีสามเรื่องที่ควรสรุปจากตารางพวกนี้ครับ เรื่องแรก B70 รับ 128K ได้จริง โมเดล 27B ใช้ VRAM 23.73 GiB ที่ 128K (และ 26.07 GiB เมื่อพ่วง DFlash2) ทุกรอบผ่านหมดโดยไม่มี out-of-memory เรื่องที่สอง prefill ค่อนข้างแบนราบ คือ 775–793 tok/s ตั้งแต่ 8K ถึง 32K แล้วค่อย ๆ ลดเหลือ 622 tok/s ที่ 128K (ลดลงเพียง 21%) แต่เนื่องจาก prefill ช้าอยู่แล้ว TTFT จึงโตเกือบเป็นเส้นตรงจนไปถึงราว 3.5 นาทีที่ 128K ซึ่งจริง ๆ ก็คือการอ่านเอกสารทั้งเล่มแบบ batch เท่านั้นครับ
เรื่องที่สามคือพระเอกของงานนี้ speculative decoding ที่ 128K โมเดลปกติถูก KV cache ลากให้ decode เหลือ 10.40 tok/s แต่เมื่อเปิด DFlash2 ขึ้นเป็น 24.09 tok/s หรือเร็วกว่าเดิม 2.32 เท่า ใกล้เคียงกับความเร็วของ Qwen 27B ตอน context สั้นที่ 512 โทเค็น (26.9 tok/s) ถ้าคุณตั้งใจใช้ B70 อ่านเอกสารยาว ๆ ผมแนะนำให้เปิดเทคนิคนี้ไว้เลยครับ
ผู้ใช้หลายคนพร้อมกัน
หัวข้อที่มีชื่อว่า “ผู้ใช้หลายคนพร้อมกัน”การทดสอบนี้จำลองให้มีผู้ใช้ส่งคำขอพร้อมกันตั้งแต่ C1 (1 คน) ถึง C8 (8 คน) ใช้งานสรุปเอกสาร (summary_2k: prompt 2,048 โทเค็น ตอบ 256 โทเค็น) ตั้ง 8 slots บน context รวม 32,768
Qwen3.6-35B-A3B (MoE)
| Backend | C | Aggregate (tok/s) | ต่อผู้ใช้ (tok/s) | TTFT p50 (s) | TTFT p95 (s) | ไฟ (W) | เทียบ C1 |
|---|---|---|---|---|---|---|---|
| SYCL | C1 | 55.29 | 99.79 | 2.08 | 2.08 | 154.1 | 100.0% |
| SYCL | C2 | 51.91 | 45.65 | 4.28 | 4.32 | 143.3 | 46.9% |
| SYCL | C4 | 58.18 | 29.07 | 8.85 | 9.22 | 153.2 | 26.3% |
| SYCL | C8 | 62.35 | 15.05 | 15.65 | 19.19 | 163.8 | 14.1% |
| Vulkan | C1 | 39.97 | 53.12 | 1.60 | 1.62 | 191.9 | 100.0% |
| Vulkan | C2 | 55.51 | 43.00 | 3.25 | 3.34 | 197.4 | 69.4% |
| Vulkan | C4 | 65.20 | 29.21 | 6.75 | 7.30 | 200.6 | 40.8% |
| Vulkan | C8 | 71.41 | 15.80 | 12.03 | 15.29 | 205.1 | 22.3% |
Qwen3.8-27B (Dense)
| Backend | C | Aggregate (tok/s) | ต่อผู้ใช้ (tok/s) | TTFT p50 (s) | TTFT p95 (s) | ไฟ (W) | เทียบ C1 |
|---|---|---|---|---|---|---|---|
| SYCL | C1 | 20.41 | 26.49 | 2.92 | 2.94 | 224.7 | 100.0% |
| SYCL | C2 | 26.44 | 19.81 | 6.49 | 6.59 | 216.9 | 64.8% |
| SYCL | C4 | 31.05 | 13.51 | 13.78 | 14.77 | 215.3 | 38.0% |
| SYCL | C8 | 32.31 | 6.77 | 24.83 | 30.88 | 217.0 | 19.8% |
| Vulkan | C1 | 9.98 | 11.94 | 4.30 | 4.31 | 222.6 | 100.0% |
| Vulkan | C2 | 15.85 | 10.96 | 8.99 | 9.13 | 219.4 | 79.4% |
| Vulkan | C4 | 20.88 | 8.49 | 18.62 | 19.93 | 213.8 | 52.3% |
| Vulkan | C8 | 22.87 | 4.59 | 32.65 | 41.52 | 204.9 | 28.7% |
(คอลัมน์ “เทียบ C1” คือสัดส่วนของ efficiency เทียบกับตอนใช้คนเดียว ตามที่ชุดทดสอบรายงาน)
ผลตรงนี้ไม่สวยเท่าไรครับ บน SYCL กับ Qwen3.6 เมื่อเพิ่มผู้ใช้จาก 1 เป็น 8 คน throughput รวมขยับจาก 55.29 เป็น 62.35 tok/s เท่านั้น (โต 1.13 เท่า) ขณะที่ความเร็วต่อคนตกจาก 99.79 เหลือ 15.05 tok/s และ TTFT p95 พุ่งไป 19.19 วินาที ชุดข้อมูลตีความว่าคิวคำสั่งของ Level Zero สลับงานแบบ interleaved batching ได้ไม่ดี การทำงานจึงกลายเป็นต่อคิวกึ่งอนุกรม
ที่น่าสนใจกว่าคือ Vulkan ที่ C1 ช้ากว่า SYCL (39.97 กับ 55.29 tok/s) แต่ตอนผู้ใช้เพิ่มเป็น 8 คนกลับแซงขึ้นไปที่ 71.41 tok/s พร้อม TTFT p95 ที่สั้นกว่า (15.29 วินาที เทียบ 19.19 วินาที) เกิดจุดตัดที่ Vulkan กระจายงานแบบขนานได้ดีกว่า แต่ก็ยังไม่ใช่ว่าดี เพราะ Vulkan ยังเป็นรองบน Q4_0 ตามที่เห็นในหัวข้อก่อนหน้า
สรุปสำหรับคนคิดจะใช้เป็นเซิร์ฟเวอร์ คือ B70 ใบเดียวไม่เหมาะกับการรองรับผู้ใช้พร้อมกันเกิน 2–4 คน เพราะ throughput รวมได้เพิ่มเพียงเศษเสี้ยว แต่ทุกคนต้องทนรอโทเค็นแรกนานเกือบครึ่งนาทีที่ C8 (นี่เป็นผลจาก llama.cpp เท่านั้น runtime ที่ออกแบบมาสำหรับงานหลายผู้ใช้อาจให้ผลต่างออกไป ซึ่งยังไม่ได้ทดสอบในรีวิวนี้)
เร่ง Qwen3.8-27B ด้วย speculative decoding
หัวข้อที่มีชื่อว่า “เร่ง Qwen3.8-27B ด้วย speculative decoding”เนื่องจาก decode ของโมเดล dense ถูกจำกัดด้วยแบนด์วิดท์ เทคนิค speculative decoding จึงเข้ามาช่วยได้ โดยใช้โมเดลเล็กหรือหัวทำนายพิเศษคาดเดาโทเคนล่วงหน้าหลายตัว แล้วให้โมเดลหลักตรวจพร้อมกันในรอบเดียว การทดสอบนี้ใช้ Qwen3.8-27B Q4_K_M (context 12,288) เทียบสามวิธี คือ MTP (หัวทำนายของตัวโมเดลเอง), DFlash (draft แบบเดิม ไฟล์ Bootstrap Q8_0) และ DFlash2 (draft รุ่นปรับปรุง ไฟล์ Q4_K_M)
| Backend และโหมด | Decode (tok/s) | Speedup | Prefill 8K (tok/s) | TTFT 4K (s) | Draft Acceptance | VRAM Peak (GiB) | ไฟเฉลี่ย (W) | tok/s ต่อวัตต์ |
|---|---|---|---|---|---|---|---|---|
| SYCL Normal | 26.92 | 1.00× | 796.7 | 5.77 | – | 16.47 | 217.2 | 0.122 |
| SYCL MTP | 36.01 | 1.34× | 750.9 | 6.12 | 66.8% | 18.62 | 209.7 | 0.164 |
| SYCL DFlash | 28.11 | 1.04× | 704.3 | 6.55 | 35.9% | 19.85 | 210.5 | 0.127 |
| SYCL DFlash2 | 37.30 | 1.39× | 705.8 | 6.54 | 53.1% | 18.68 | 207.2 | 0.171 |
| Vulkan Normal | 12.00 | 1.00× | 437.3 | 8.80 | – | 15.91 | 221.3 | 0.053 |
| Vulkan MTP | 16.92 | 1.41× | 418.2 | 9.19 | 65.7% | 17.89 | 217.2 | 0.076 |
| Vulkan DFlash | 14.38 | 1.20× | 372.6 | 10.55 | 35.1% | 19.18 | 212.8 | 0.065 |
| Vulkan DFlash2 | 19.30 | 1.61× | 373.0 | 10.60 | 52.4% | 18.09 | 206.3 | 0.091 |
DFlash2 คือผู้ชนะด้านความเร็ว บน SYCL ดัน decode จาก 26.92 เป็น 37.30 tok/s (เร็วขึ้น 39%) และยังใช้ไฟเฉลี่ยลดลงเหลือ 207.2 W ทำให้ tok/s ต่อวัตต์ดีขึ้นราว 40% ส่วน MTP แม้ความเร็วตามหลังเล็กน้อยที่ 36.01 tok/s แต่ทายถูกมากที่สุดที่ 66.8% ขณะที่ DFlash รุ่นแรกให้ผลแทบไม่ต่างจากปกติ (1.04 เท่า) เพราะอัตราทายถูกเพียง 35.9% เวลาส่วนใหญ่จึงหมดไปกับการ rollback และตรวจสอบ
เช่นเดียวกับทุกที่ ไม่มีอะไรฟรีครับ การเปิด speculative decoding ต้องแลกด้วย VRAM ที่เพิ่มราว 2.21 GiB, prefill ที่ลดลงราว 11.4% (796.7 เหลือ 705.8 tok/s บน SYCL) และ TTFT ที่นานขึ้นราว 13.3% งานที่ prompt ยาวมากแต่ตอบสั้นอาจไม่คุ้ม แต่งานที่ต้อง decode ยาวหรือต้องใช้ context ยาว (อย่างที่เห็นที่ 128K) คุ้มชัดเจน
ความเร็วกับภาษาไทย
หัวข้อที่มีชื่อว่า “ความเร็วกับภาษาไทย”เวิร์คโหลด thai_summary ป้อนข้อความภาษาไทยชุดเดียวกันให้ทุกโมเดล ประเด็นที่น่าสนใจกว่าตัวเลข tok/s คือ tokenizer ของแต่ละตระกูลโมเดลแตกภาษาไทยได้ไม่เท่ากัน จึงควรดูเป็นตัวอักษรต่อวินาทีเพื่อเปรียบเทียบให้ยุติธรรม
| โมเดล | Tokenizer | Token ต่อตัวอักษร | Decode (อักษร/วินาที) | Prefill (อักษร/วินาที) | TTFT ภาษาไทย (s) | เทียบหน้า A4 (~1,500 ตัวอักษร) |
|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B | Qwen BPE | 0.2917 | 305.08 | 3,051.2 | 1.298 | ~4.9 วินาทีต่อหน้า |
| Gemma 4 26B-A4B | SentencePiece | 0.3767 | 147.32 | 2,526.5 | 1.701 | ~10.2 วินาทีต่อหน้า |
| Gemma 4 12B | SentencePiece | 0.3767 | 96.64 | 1,302.2 | 3.139 | ~15.5 วินาทีต่อหน้า |
| Qwen3.8-27B | Qwen BPE | 0.2917 | 68.23 | 1,682.4 | 2.469 | ~22.0 วินาทีต่อหน้า |
| Gemma 4 31B | SentencePiece | 0.3767 | 45.34 | 495.3 | 8.119 | ~33.1 วินาทีต่อหน้า |
Qwen ใช้เพียง 0.2917 โทเค็นต่อหนึ่งตัวอักษรไทย (หนึ่งโทเค็นแทนได้ราว 3.43 ตัวอักษร) ขณะที่ Gemma ใช้ 0.3767 (หนึ่งโทเค็นแทนได้ราว 2.65 ตัวอักษร) ความต่างนี้เกิดขึ้นก่อนที่การ์ดจะเริ่มทำงานด้วยซ้ำ และมันบวกทบกับความเร็วของโมเดล เมื่อ Qwen3.6-35B-A3B ที่เป็น MoE มาเจอ tokenizer ที่คุ้มกว่า B70 จึงพ่นภาษาไทยได้ถึง 305 ตัวอักษรต่อวินาที พอเขียนรายงานหนึ่งหน้า A4 เสร็จใน 5 วินาที (ประมาณการจากตัวอักษรต่อหน้า) เร็วกว่าความเร็วในการอ่านของคนไปไกลครับ ส่วนเรื่องคุณภาพของภาษาไทยที่โมเดลเขียนออกมา ผลทดสอบชุดนี้ไม่ได้วัดไว้นะครับ ตรงนี้เป็นเรื่องของโมเดลและซอฟต์แวร์ ไม่เกี่ยวกับการ์ดจอ
พลังงาน ความร้อน และเสียงพัดลม
หัวข้อที่มีชื่อว่า “พลังงาน ความร้อน และเสียงพัดลม”ข้อมูลต่อไปนี้มาจากการบันทึกระหว่างการทำงานในทุก 1 วินาที ตลอดการทดสอบ
| สภาวะการทดสอบ | ไฟเฉลี่ย (W) | ไฟพีค (W) | ชิปเฉลี่ย (°C) | ชิปพีค (°C) | VRAM พีค (°C) | คล็อกเฉลี่ย (MHz) | พัดลมสูงสุด (RPM) |
|---|---|---|---|---|---|---|---|
| Qwen3.6 MoE (SYCL) | 150.6 | 199.3 | 57.2 | 60.0 | 60.0 | 2,518 | 1,133 |
| Gemma 26B MoE (SYCL) | 167.1 | 218.4 | 61.4 | 65.0 | 66.0 | 2,604 | 1,334 |
| Gemma 12B (SYCL) | 179.0 | 215.9 | 63.8 | 68.0 | 70.0 | 2,553 | 2,069 |
| Qwen 27B (SYCL) | 218.0 | 238.6 | 68.5 | 72.0 | 75.0 | 2,377 | 1,757 |
| Gemma 31B (SYCL) | 189.5 | 231.0 | 69.1 | 73.0 | 76.0 | 2,507 | 2,400 |
| Qwen 27B 128K (SYCL) | 223.5 | 238.0 | 74.6 | 78.0 | 86.0 | 2,260 | 3,334 |
เรื่องที่น่าสังเกตมีสามข้อครับ ข้อแรก เพาเวอร์แคป 230 W ควบคุมได้เรียบร้อย ค่าสูงสุดที่วัดได้ 238.6 W (เกินราว 3.7%) ไม่มีสัญญาณ power throttling ข้อที่สอง งานประจำวันอย่างแชทหรือ MoE พัดลมอยู่ราว 1,100–1,800 RPM ซึ่งถือว่าเงียบพอสมควร สุดท้ายในการทดสอบ 128K ต่อเนื่อง อุณหภูมิ VRAM junction ขึ้นไป 86 °C และพัดลมเร่งถึง 3,334 RPM ได้ยินเสียงชัด ชุดข้อมูลระบุว่า 86 °C ยังปลอดภัยสำหรับชิป GDDR6 (ขีดจำกัดวิกฤตอยู่ที่ราว 95–105 °C)
บทสรุปของ Intel Arc Pro B70
หัวข้อที่มีชื่อว่า “บทสรุปของ Intel Arc Pro B70”ถ้าจะสรุปการ์ดใบนี้ในประโยคเดียว ฮาร์ดแวร์ของ B70 วิ่งนำหน้าซอฟต์แวร์สแตกอยู่พอสมควรครับ ฝั่งฮาร์ดแวร์ให้สิ่งที่คนทำ AI ต้องการครบ ทั้ง VRAM 32 GB ECC ในราคาเอื้อมถึง แบนด์วิดท์ที่ใช้ได้จริงราว 453 GB/s การกินไฟ 150–220 W และความเงียบ ส่วนฝั่งซอฟต์แวร์ยังมีสี่เรื่องที่ฉุดไว้ คือ prefill ที่ใช้ XMX ได้แค่ 3%–23% ค่าความหน่วงคงที่ราว 6.8 ms ต่อโทเค็นของ Level Zero และการทำ batching สำหรับผู้ใช้หลายคน เราก็ไม่กล้าบอกว่ายังไม่ดี เพราะนี่เป็นเพียงการจำลองด้วยการยิงพร้อมไปในเวลาเดียวกัน แต่ถ้าไปรันบน vLLM หรือระบบที่ติดตั้งมาเพื่อรองรับหลายผู้ใช้ระบบก็น่าจะตอบสนองได้ดีกว่านี้ และการทดสอบนี้เราก็ใช้เพียงแค่ llama.cpp เพียงโปรแกรมเดียว ซึ่งอาจจะไม่สามารถสะท้อนประสิทธิภาพโดยรวมของ Intel Arc Pro B70 ได้อย่างรอบด้าน การทดสอบชุดนี้ก็ยังเป็นเพียงมุมมองของการใช้ Local LLM เท่านั้นครับ
Intel Arc Pro B70 เหมาะกับใคร
หัวข้อที่มีชื่อว่า “Intel Arc Pro B70 เหมาะกับใคร”เหมาะกับคุณถ้าเป็นนักพัฒนาหรือนักวิจัยที่ใช้คนเดียว อยากได้เครื่องเงียบ ๆ ข้างโต๊ะที่รันโมเดล 27B–35B (โดยเฉพาะ MoE อย่าง Qwen3.6-35B-A3B) เป็นงานประจำวัน และอยากได้ VRAM 32 GB สำหรับเปิดเอกสารยาว ๆ งานแบบ batch offline ก็เข้ากับการ์ดใบนี้ได้ดี
ข้อสุดท้ายที่อยากย้ำคือตัวเลขทั้งหมดในรีวิวนี้ผูกกับ llama.cpp build 11429 ไดรเวอร์ Level Zero 26.05 และ Mesa 26.0.8 ตามที่ระบุไว้ข้างบน ซอฟต์แวร์ฝั่งอินเทลเป็นส่วนที่น่าจะขยับได้มากที่สุด จึงควรมองผลชุดนี้เป็นภาพ ณ เวลาที่ทดสอบ ไม่ใช่ข้อสรุปตายตัวของการ์ดครับ