Microsoft เผยวิธีบีบโมเดลเขียนโค้ด MAI-Code-1.1-Flash จากประมาณ 276 GB เหลือ 53.0 GiB พร้อม speculative decoding และผลวัดบน RTX Spark 128GB (ผลวัดของ Microsoft ไม่ใช่ผลทดสอบของเรา)
Tag: MoE (Mixture of Experts)
- MAI-Code-1.1-Flash: โมเดล MoE 137.9B บีบเหลือ 53 GB รันบน Windows ด้วย RTX Spark
- Qwen3.8-Flash-Next GGUF จาก Unsloth ใช้ Dynamic V3.1 ลดขนาดโมเดล 125B ให้รันบนเครื่องที่มีแรมจำกัดได้ง่ายขึ้น
Unsloth ปล่อย GGUF ของ Qwen3.8-Flash-Next ด้วยอัลกอริทึม Dynamic V3.1 (preview) พร้อมตัวเลือก MTP และ engram แบบเลือกความละเอียดได้ บทความนี้สรุปว่าใครควรสนใจ และตัวเลขไหนเป็นคำอ้างของผู้ผลิต
- รันโมเดล 125B บนการ์ด Radeon AI PRO R9700 สองใบ (Qwen3.8-Flash-Next)
ทดสอบโมเดล MoE ขนาด 75.8 GB ที่การ์ดใบเดียวรับไม่ไหว บน Radeon AI PRO R9700 สองใบ ด้วย ROCm และ Vulkan ทั้งบริบทสั้นและบริบทยาวถึง 128K พร้อมผลทดลอง MTP
- llama.cpp v0.8.0 อัปเดต เพิ่มโมเดลใหม่ ปรับปรุง MoE และ GPU Backend พร้อมรองรับ Realtime API
llama.cpp v0.8.0 เพิ่มการรองรับโมเดล AI รุ่นใหม่ ปรับปรุง MoE และ Sparse Attention ขยายความสามารถ GPU Backend พร้อมเพิ่ม Realtime API, TTS และฟีเจอร์สำหรับ AI Agent
- รีวิว Intel Arc Pro B70 32 GB กับการทำงานด้าน Local LLM
ทดสอบ Intel Arc Pro B70 32 GB กับงาน Local LLM ผ่าน SYCL และ Vulkan ตั้งแต่ decode, prefill, บริบทยาว 128K, ผู้ใช้หลายคนพร้อมกัน, speculative decoding ไปจนถึงภาษาไทยและการใช้พลังงาน
- รีวิว AMD Radeon AI PRO R9700 กับประสิทธิภาพการทำงาน Local LLM
ทดสอบ Radeon AI PRO R9700 กับงาน Local LLM ผ่าน ROCm 10 และ Vulkan ตั้งแต่ decode, prefill, บริบทยาวถึง 128K ไปจนถึง speculative decoding การใช้พลังงาน และการรองรับผู้ใช้หลายคน
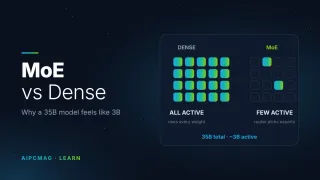
- MoE vs Dense: ทำไมโมเดล 35B ถึงตอบเร็วเหมือนโมเดล 3B
อธิบายความต่างระหว่างโมเดลแบบ Dense และ Mixture-of-Experts (MoE) ว่าทำไมจำนวนพารามิเตอร์รวมกับพารามิเตอร์ที่ทำงานจริงจึงไม่เท่ากัน และมีผลต่อความเร็วและหน่วยความจำอย่างไร
- รายงานผลการทดสอบ: NVIDIA GeForce RTX 5060 Ti 16GB กับการรัน Local LLM บน Windows — ประชัน CUDA vs Vulkan บน Dense 12B และ MoE 26B
ผลการทดสอบเชิงลึกการ์ดจอ NVIDIA GeForce RTX 5060 Ti 16GB (สถาปัตยกรรม Blackwell) ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ CUDA vs Vulkan บน Gemma-4 12B และทดสอบขีดจำกัดหน่วยความจำบน Gemma-4 26B-A4B MoE ในภาวะ VRAM-Tight
- รายงานผลการทดสอบ: AMD Radeon RX 9070 XT 16GB กับการรัน Local LLM บน Windows — ประชัน ROCm vs Vulkan บน 8 โมเดล LLM พร้อมทดสอบขีดจำกัด Concurrency
ผลการทดสอบเชิงลึกการ์ดจอ AMD Radeon RX 9070 XT 16GB (สถาปัตยกรรม RDNA 4) ด้วย PromptMark v0.4.0 และ Concurrent Text Benchmark เปรียบเทียบรันไทม์ ROCm vs Vulkan ทั้งโมเดล MoE, Dense และฟอร์แมตควอนไทซ์ NVFP4 พร้อมวัดประสิทธิภาพการรองรับผู้ใช้พร้อมกัน 16 ผู้ใช้
- รายงานผลการทดสอบ: Intel Arc B580 Dual GPU (2x 12GB รวม 24GB VRAM) กับการรัน Local LLM บน Windows
ผลการทดสอบเชิงลึกการ์ดจอคู่ Intel Arc B580 24GB VRAM ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ SYCL vs Vulkan และสถาปัตยกรรม MoE vs Dense บน 8 โมเดล LLM ยอดนิยม
- Active Parameters
จำนวน parameters ที่ถูกใช้คำนวณจริงต่อ token ในโมเดลแบบ MoE ซึ่งน้อยกว่าขนาดรวมของโมเดล
- MoE (Mixture of Experts)
สถาปัตยกรรมที่แบ่งโมเดลเป็น "experts" หลายชุด แล้วเลือกใช้เฉพาะบางส่วนต่อ token ทำให้ parameters ที่คำนวณจริงน้อยกว่าขนาดรวมของโมเดล