Strata 0.2.11 รองรับ Qwen3.8-Flash-Next จาก Unsloth Dynamic v3.1 ปรับปรุง Multi-GPU, NVIDIA CUDA, AMD Radeon และการจัดการ VRAM พร้อมแก้ไขปัญหาการบันทึก Chat และความเสถียร
Tag: Speculative Decoding
- Strata 0.2.11 อัปเดต รองรับ Qwen3.8-Flash-Next รุ่นใหม่จาก Unsloth เพิ่มประสิทธิภาพ Multi-GPU และเร่งความเร็ว Prompt Processing
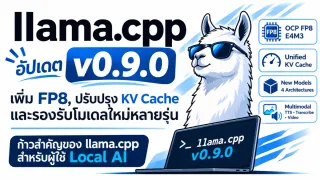
- llama.cpp v0.9.0 อัปเดต เพิ่มการรองรับ FP8, ปรับปรุง KV Cache และเร่ง Prefill ของ Gemma 4
llama.cpp v0.9.0 เพิ่มการรองรับ FP8 E4M3, ปรับปรุง Unified KV Cache, เพิ่มโมเดลใหม่ 4 สถาปัตยกรรม และขยายความสามารถด้าน Local AI และ Multimodal
- MAI-Code-1.1-Flash: โมเดล MoE 137.9B บีบเหลือ 53 GB รันบน Windows ด้วย RTX Spark
Microsoft เผยวิธีบีบโมเดลเขียนโค้ด MAI-Code-1.1-Flash จากประมาณ 276 GB เหลือ 53.0 GiB พร้อม speculative decoding และผลวัดบน RTX Spark 128GB (ผลวัดของ Microsoft ไม่ใช่ผลทดสอบของเรา)
- Qwen3.8-Flash-Next GGUF จาก Unsloth ใช้ Dynamic V3.1 ลดขนาดโมเดล 125B ให้รันบนเครื่องที่มีแรมจำกัดได้ง่ายขึ้น
Unsloth ปล่อย GGUF ของ Qwen3.8-Flash-Next ด้วยอัลกอริทึม Dynamic V3.1 (preview) พร้อมตัวเลือก MTP และ engram แบบเลือกความละเอียดได้ บทความนี้สรุปว่าใครควรสนใจ และตัวเลขไหนเป็นคำอ้างของผู้ผลิต
- vLLM 0.33.0 อัปเดต เพิ่มประสิทธิภาพ รองรับ Qwen3.8-Flash-Next และปรับปรุง Multi-GPU บน CUDA และ ROCm
vLLM 0.33.0 อัปเดต PyTorch 2.14 เพิ่มการรองรับโมเดล AI รุ่นใหม่ ปรับปรุง Speculative Decoding, KV Cache และเพิ่มประสิทธิภาพ Inference บน NVIDIA และ AMD
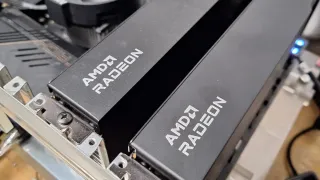
- รันโมเดล 125B บนการ์ด Radeon AI PRO R9700 สองใบ (Qwen3.8-Flash-Next)
ทดสอบโมเดล MoE ขนาด 75.8 GB ที่การ์ดใบเดียวรับไม่ไหว บน Radeon AI PRO R9700 สองใบ ด้วย ROCm และ Vulkan ทั้งบริบทสั้นและบริบทยาวถึง 128K พร้อมผลทดลอง MTP
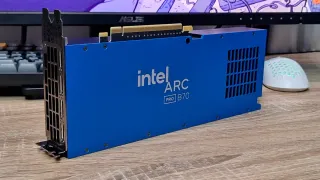
- รีวิว Intel Arc Pro B70 32 GB กับการทำงานด้าน Local LLM
ทดสอบ Intel Arc Pro B70 32 GB กับงาน Local LLM ผ่าน SYCL และ Vulkan ตั้งแต่ decode, prefill, บริบทยาว 128K, ผู้ใช้หลายคนพร้อมกัน, speculative decoding ไปจนถึงภาษาไทยและการใช้พลังงาน
- รีวิว AMD Radeon AI PRO R9700 กับประสิทธิภาพการทำงาน Local LLM
ทดสอบ Radeon AI PRO R9700 กับงาน Local LLM ผ่าน ROCm 10 และ Vulkan ตั้งแต่ decode, prefill, บริบทยาวถึง 128K ไปจนถึง speculative decoding การใช้พลังงาน และการรองรับผู้ใช้หลายคน
- รายงานการทดสอบเชิงลึก: ปลดล็อกพลัง Qwen3.8-27B บน Dual AMD Radeon RX 9060 XT (RDNA 4)
เปรียบเทียบ ROCm และ Vulkan บน RX 9060 XT สองใบด้วย PromptMark รวมโหมดปกติ MTP และ DFlash
- Speculative Decoding
เทคนิคที่ใช้โมเดลเล็ก (draft) เดา token ถัดไปหลายตัวล่วงหน้า แล้วให้โมเดลใหญ่ตรวจทีเดียว เพื่อให้สร้างคำตอบได้เร็วขึ้น