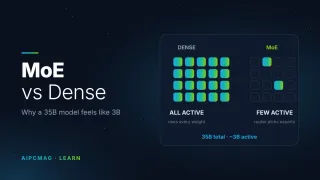
อธิบายความต่างระหว่างโมเดลแบบ Dense และ Mixture-of-Experts (MoE) ว่าทำไมจำนวนพารามิเตอร์รวมกับพารามิเตอร์ที่ทำงานจริงจึงไม่เท่ากัน และมีผลต่อความเร็วและหน่วยความจำอย่างไร
Tag: Dense Model
- MoE vs Dense: ทำไมโมเดล 35B ถึงตอบเร็วเหมือนโมเดล 3B
- รายงานผลการทดสอบ: NVIDIA GeForce RTX 5060 Ti 16GB กับการรัน Local LLM บน Windows — ประชัน CUDA vs Vulkan บน Dense 12B และ MoE 26B
ผลการทดสอบเชิงลึกการ์ดจอ NVIDIA GeForce RTX 5060 Ti 16GB (สถาปัตยกรรม Blackwell) ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ CUDA vs Vulkan บน Gemma-4 12B และทดสอบขีดจำกัดหน่วยความจำบน Gemma-4 26B-A4B MoE ในภาวะ VRAM-Tight
- รายงานผลการทดสอบ: AMD Radeon RX 9070 XT 16GB กับการรัน Local LLM บน Windows — ประชัน ROCm vs Vulkan บน 8 โมเดล LLM พร้อมทดสอบขีดจำกัด Concurrency
ผลการทดสอบเชิงลึกการ์ดจอ AMD Radeon RX 9070 XT 16GB (สถาปัตยกรรม RDNA 4) ด้วย PromptMark v0.4.0 และ Concurrent Text Benchmark เปรียบเทียบรันไทม์ ROCm vs Vulkan ทั้งโมเดล MoE, Dense และฟอร์แมตควอนไทซ์ NVFP4 พร้อมวัดประสิทธิภาพการรองรับผู้ใช้พร้อมกัน 16 ผู้ใช้
- รายงานผลการทดสอบ: Intel Arc B580 Dual GPU (2x 12GB รวม 24GB VRAM) กับการรัน Local LLM บน Windows
ผลการทดสอบเชิงลึกการ์ดจอคู่ Intel Arc B580 24GB VRAM ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ SYCL vs Vulkan และสถาปัตยกรรม MoE vs Dense บน 8 โมเดล LLM ยอดนิยม
- รายงานผลการทดสอบ: Intel Arc B580 12GB กับการรัน Local LLM บน Windows (Vulkan vs SYCL)
ผลการทดสอบการ์ดจอ Intel Arc B580 12GB (สถาปัตยกรรม Xe2) ด้วย PromptMark เปรียบเทียบรันไทม์ Vulkan vs SYCL บน 5 รูปแบบโมเดล LLM พร้อมวิเคราะห์ Prefill, Decode และการสเกล Context 8K