รายงานผลการทดสอบ: Intel Arc B580 12GB กับการรัน Local LLM บน Windows (Vulkan vs SYCL)
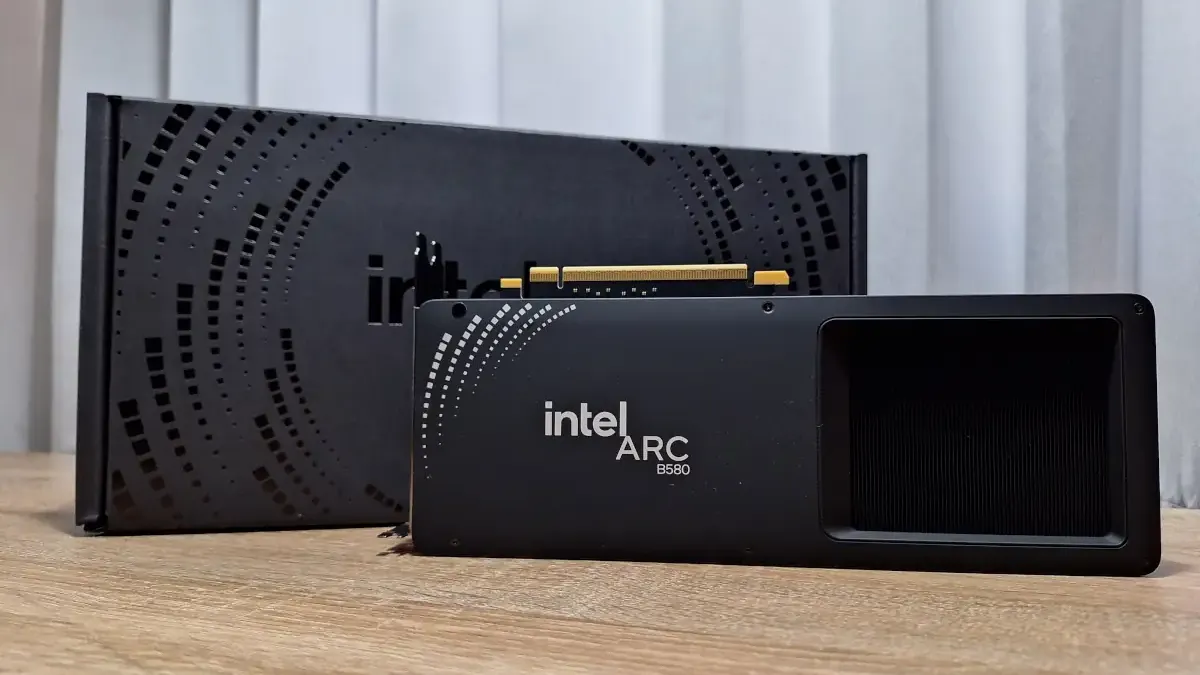
ประเภท: Benchmark · วันที่ทดสอบ: 2026-08-07 ถึง 2026-08-09 · เครื่องมือ: PromptMark v0.2.0 (llama.cpp Build b10182, Clang 20.1.8 Windows x86_64)
Intel Arc B580 (VRAM 12GB GDDR6) เป็นการ์ดจอสถาปัตยกรรม Xe2-HPG (“Battlemage”) ที่ได้รับความสนใจอย่างมากในกลุ่มผู้ใช้งาน Local AI ระดับเริ่มต้นถึงระดับกลาง เนื่องจากให้ขนาด VRAM สูงถึง 12GB บนบัส 192-bit แบนด์วิดท์ 456 GB/s ในระดับราคาเปิดตัวเพียง 249 ดอลลาร์สหรัฐ
ในการทดสอบชุดนี้ ทางห้องปฏิบัติการได้นำการ์ดจอ Intel Arc B580 มาทดสอบวัดผลประสิทธิภาพอย่างรอบด้านด้วยเครื่องมือ PromptMark v0.2.0 ผ่านเอนจิน llama-server (build 10182) โดยเปรียบเทียบแบบจับคู่ตรง (Head-to-Head) ระหว่าง 2 แบ็กเอนด์หลักบนระบบปฏิบัติการ Windows ได้แก่ Vulkan (Cross-platform Graphics & Compute API) และ SYCL (Intel oneAPI) บนโมเดลภาษา 5 รูปแบบ ตั้งแต่ขนาด 8B, 9B, 12B จนถึง 14B พร้อมการขยายบริบท (Context Scaling) จาก 512 โทเค็นไปจนถึง 8,192 โทเค็น
ประเด็นค้นพบสำคัญจากการทดสอบ:
หัวข้อที่มีชื่อว่า “ประเด็นค้นพบสำคัญจากการทดสอบ:”- Vulkan ชนะขาดด้าน Prefill และ TTFT: ในทุกโมเดลและทุกความยาวบริบท แบ็กเอนด์ Vulkan ทำความเร็วในการประมวลผลคำสั่งนำเข้า (Prefill) สูงกว่า SYCL ถึง +40% ถึง +122% ส่งผลให้ค่า Time to First Token (TTFT) ตอบสนองได้รวดเร็วกว่าเกือบเท่าตัว เช่น บนโมเดล
DeepSeek-R1-Distill-Llama-8Bที่บริบท 512 โทเค็น Vulkan ใช้เวลาเพียง 453 ms เทียบกับ SYCL ที่ต้องรอถึง 774 ms - จุดตัดสำคัญ (Crossover Point) ของความเร็ว Decode ที่บริบทยาว:
- ที่บริบทสั้น (512 tokens): Vulkan สร้างคำตอบ (Decode) ได้เร็วกว่าหรือใกล้เคียงกับ SYCL เล็กน้อย (57 – 62 tokens/s บนโมเดล 8B–9B)
- ที่บริบทยาว (4K – 8K tokens): ประสิทธิภาพ Decode ของ Vulkan ตกลงอย่างรวดเร็ว (ลดลง 32% – 55%) ในขณะที่ SYCL นิ่งและทนทานต่อภาระของ KV Cache ได้ดีกว่ามาก (ลดลงเพียง 6% – 13%)
- ส่งผลให้ที่บริบท 8,192 โทเค็น SYCL แซงกลับมาทำความเร็ว Decode สูงกว่า Vulkan ถึง +44% ถึง +75% (เช่น DeepSeek-8B ที่ 8K: SYCL ทำได้ 48.8 tokens/s ขณะที่ Vulkan หล่นลงเหลือ 27.9 tokens/s)
- เวลารวมสุทธิ (End-to-End Latency) Vulkan ยังคงเป็นผู้ชนะส่วนใหญ่: แม้ SYCL จะสร้างข้อความที่บริบทยาวได้เร็วกว่า แต่เนื่องจากระยะการ Prefill ของ Vulkan ทำได้ไวกว่าอย่างมหาศาล ทำให้ในงานสร้างข้อความทั่วไป (256 – 512 โทเค็น) Vulkan ใช้เวลารวมตั้งแต่เริ่มส่งคำถามจนได้คำตอบครบถ้วน (E2E) สั้นกว่า SYCL ในแทบทุกเวิร์กโหลด
- ความลับของ Quantization:
QAT-Q4_0ปลดล็อกพลัง Decode บน SYCL เพิ่มขึ้น +25%: จากการทดสอบเปรียบเทียบรูปแบบควอนไทซ์ของGemma-4-12B-itพบว่าการใช้ไฟล์ควอนไทซ์พื้นฐานแบบQAT-Q4_0บน SYCL สามารถทำความเร็ว Decode ได้สูงถึง 37.5 – 40.7 tokens/s ซึ่งเร็วกว่าแบบQ4_K_Mที่ทำได้ 30.5 – 32.4 tokens/s ถึง +23% ถึง +25.6% ตลอดทุกเวิร์กโหลด - VRAM 12GB รันโมเดล 14B ได้เต็ม 100% พร้อมบริบท 12K: Intel Arc B580 สามารถโหลดโมเดลระดับ 14B อย่าง
Ministral-3-14B-Reasoning-2512พร้อมจอง Context Window กว้างถึง 12,288 โทเค็นลงในหน่วยความจำการ์ดจอได้ครบทั้งหมด 100% (Full GPU Offload) โดยไม่ต้องพึ่งพาแรมของระบบ (System RAM)
สภาพแวดล้อมและวิธีทดสอบ
หัวข้อที่มีชื่อว่า “สภาพแวดล้อมและวิธีทดสอบ”การทดสอบดำเนินการบนระบบปฏิบัติการ Windows x86_64 โดยล็อกตัวแปรการทดสอบให้เหมือนกันทุกประการ:
| รายการ | รายละเอียดการตั้งค่าฮาร์ดแวร์และซอฟต์แวร์ |
|---|---|
| การ์ดจอที่ใช้ทดสอบ (dGPU) | 1× Intel Arc B580 Graphics (หน่วยความจำ 12,118 MiB บน Vulkan / 11,875 MiB บน SYCL) |
| สถาปัตยกรรมชิป | Intel Xe2-HPG (“Battlemage”), บัส 192-bit แบนด์วิดท์ 456 GB/s, 20 Xe-cores, 160 XMX Engines |
| ระบบปฏิบัติการ | Windows x86_64 |
| เครื่องมือทดสอบ | PromptMark v0.2.0 |
| เอนจินประมวลผล | llama-server.exe build 10182 (commit afeebe103, Clang 20.1.8) |
| รันไทม์ที่เปรียบเทียบ | Vulkan (vulkan/llama-server.exe) vs SYCL (sycl/llama-server.exe) |
| การกระจายเลเยอร์ | -ngl 999 (ออฟโหลดทุกเลเยอร์ลง GPU 100%) |
| ขนาดบริบทที่กำหนด | -c 12288 (จอง Context Window 12,288 โทเค็น) |
| นโยบายการทดสอบ | ปิดแคชคำสั่ง --no-cache-prompt, ปิดการสุ่ม --fit off, พอร์ต 8080 |
| การเก็บข้อมูล | 1 Warm-up Run + 3 Measured Runs แล้วนำมาหาค่ามัธยฐาน (Median) |
รายละเอียด 6 เวิร์กโหลดในชุดทดสอบ
หัวข้อที่มีชื่อว่า “รายละเอียด 6 เวิร์กโหลดในชุดทดสอบ”- Content Generation (
content_generation_512): Context 512 โทเค็น / สร้างเอาต์พุต 256 โทเค็น (วัดความเร็วงานเขียนเนื้อหาทั่วไป) - Creative Writing (
creative_writing_512): Context 512 โทเค็น / สร้างเอาต์พุต 512 โทเค็น (วัดความเร็วการสร้างข้อความต่อเนื่องยาวปานกลาง) - Summarization Light (
summary_2k): Context 2,048 โทเค็น / สร้างเอาต์พุต 256 โทเค็น (วัดสมรรถนะการอ่านและสรุปเอกสารสั้น) - Summarization Moderate (
summary_4k): Context 4,096 โทเค็น / สร้างเอาต์พุต 256 โทเค็น (วัดจุดกึ่งกลางของการสเกลบริบท) - Summarization Long (
summary_8k): Context 8,192 โทเค็น / สร้างเอาต์พุต 256 โทเค็น (ทดสอบภาระความหน่วงและต้นทุน KV Cache ในบริบทยาว) - Code Analysis (
code_analysis_4k): Context 4,096 โทเค็น / สร้างเอาต์พุต 256 โทเค็น (วัดการอ่านโค้ดเชิงเทคนิค)
ตารางผลการทดสอบ
หัวข้อที่มีชื่อว่า “ตารางผลการทดสอบ”หมายเหตุการอ่านตาราง: ในแต่ละเวิร์กโหลดจะแสดงค่าของทั้งสองแบ็กเอนด์ในรูปแบบ Vulkan / SYCL ตัวเลขที่ไฮไลต์ตัวหนาคือค่าที่ดีกว่า
1. DeepSeek-R1-Distill-Llama-8B (Q4_K_M)
หัวข้อที่มีชื่อว่า “1. DeepSeek-R1-Distill-Llama-8B (Q4_K_M)”โมเดลสาย Reasoning ขนาด 8B ยอดนิยม
| เวิร์กโหลด (Workload) | Context / Gen | Prompt Speed (t/s) | Decode Speed (t/s) | TTFT (ms) | E2E Latency (ms) |
|---|---|---|---|---|---|
| Content Generation | 512 / 256 | 1,890.5 / 850.2 | 62.0 / 56.2 | 453 / 774 | 4,551 / 5,289 |
| Creative Writing | 512 / 512 | 1,882.3 / 850.2 | 60.3 / 55.9 | 371 / 706 | 8,826 / 9,824 |
| Summary 2K | 2,048 / 256 | 1,494.7 / 730.0 | 49.3 / 54.6 | 1,463 / 2,886 | 6,613 / 7,533 |
| Summary 4K | 4,096 / 256 | 1,137.2 / 653.1 | 38.9 / 52.4 | 3,681 / 6,328 | 10,217 / 11,179 |
| Summary 8K | 8,192 / 256 | 768.7 / 538.2 | 27.9 / 48.8 | 10,749 / 15,283 | 19,864 / 20,490 |
| Code Analysis 4K | 4,096 / 256 | 1,135.1 / 653.3 | 38.9 / 52.4 | 3,748 / 6,403 | 10,284 / 11,247 |
2. Qwen3.5-9B (Q4_K_M)
หัวข้อที่มีชื่อว่า “2. Qwen3.5-9B (Q4_K_M)”โมเดล Dense ยอดนิยมขนาด 9B จากซีรีส์ Qwen
| เวิร์กโหลด (Workload) | Context / Gen | Prompt Speed (t/s) | Decode Speed (t/s) | TTFT (ms) | E2E Latency (ms) |
|---|---|---|---|---|---|
| Content Generation | 512 / 256 | 940.7 / 567.5 | 57.3 / 48.9 | 663 / 986 | 5,133 / 6,225 |
| Creative Writing | 512 / 512 | 933.1 / 567.1 | 56.9 / 48.6 | 621 / 971 | 9,621 / 11,508 |
| Summary 2K | 2,048 / 256 | 1,296.5 / 679.4 | 54.3 / 48.1 | 1,654 / 3,065 | 6,363 / 8,387 |
| Summary 4K | 4,096 / 256 | 1,291.3 / 694.3 | 51.2 / 47.4 | 3,211 / 5,922 | 8,213 / 11,318 |
| Summary 8K | 8,192 / 256 | 1,148.8 / 688.4 | 45.5 / 46.1 | 7,172 / 11,936 | 12,803 / 17,485 |
| Code Analysis 4K | 4,096 / 256 | 1,291.5 / 694.2 | 51.2 / 47.4 | 3,358 / 6,039 | 8,359 / 11,438 |
3. Gemma-4-12B-it (Q4_K_M)
หัวข้อที่มีชื่อว่า “3. Gemma-4-12B-it (Q4_K_M)”โมเดล Dense ขนาด 12B ควอนไทซ์ระดับมาตรฐาน k-quants
| เวิร์กโหลด (Workload) | Context / Gen | Prompt Speed (t/s) | Decode Speed (t/s) | TTFT (ms) | E2E Latency (ms) |
|---|---|---|---|---|---|
| Content Generation | 512 / 256 | 586.0 / 363.3 | 36.9 / 32.4 | 1,090 / 1,598 | 8,034 / 9,494 |
| Creative Writing | 512 / 512 | 588.5 / 363.8 | 36.1 / 32.2 | 1,014 / 1,555 | 15,189 / 17,426 |
| Summary 2K | 2,048 / 256 | 668.7 / 398.7 | 32.4 / 31.9 | 3,187 / 5,246 | 11,097 / 13,274 |
| Summary 4K | 4,096 / 256 | 605.1 / 405.0 | 29.5 / 31.2 | 6,804 / 10,127 | 15,471 / 18,336 |
| Summary 8K | 8,192 / 256 | 481.5 / 406.0 | 25.1 / 30.5 | 17,046 / 20,218 | 27,232 / 28,612 |
| Code Analysis 4K | 4,096 / 256 | 603.8 / 405.0 | 29.5 / 31.2 | 6,870 / 10,366 | 15,553 / 18,573 |
4. Gemma-4-12B-it (QAT-Q4_0)
หัวข้อที่มีชื่อว่า “4. Gemma-4-12B-it (QAT-Q4_0)”โมเดล Dense ขนาด 12B ในรูปแบบ Quantization-Aware Training (QAT) บล็อก 4-bit ดั้งเดิม
| เวิร์กโหลด (Workload) | Context / Gen | Prompt Speed (t/s) | Decode Speed (t/s) | TTFT (ms) | E2E Latency (ms) |
|---|---|---|---|---|---|
| Content Generation | 512 / 256 | 676.0 / 316.7 | 39.0 / 40.7 | 971 / 1,828 | 7,533 / 8,114 |
| Creative Writing | 512 / 512 | 681.0 / 316.9 | 38.2 / 40.4 | 891 / 1,747 | 14,299 / 14,432 |
| Summary 2K | 2,048 / 256 | 716.9 / 358.9 | 34.0 / 39.6 | 2,976 / 5,801 | 10,501 / 12,259 |
| Summary 4K | 4,096 / 256 | 635.2 / 366.6 | 30.9 / 38.5 | 6,478 / 11,197 | 14,761 / 17,839 |
| Summary 8K | 8,192 / 256 | 499.1 / 368.8 | 26.1 / 37.5 | 16,449 / 22,254 | 26,254 / 29,084 |
| Code Analysis 4K | 4,096 / 256 | 633.7 / 366.6 | 30.9 / 38.5 | 6,559 / 11,488 | 14,849 / 18,135 |
5. Ministral-3-14B-Reasoning-2512 (Q4_K_M)
หัวข้อที่มีชื่อว่า “5. Ministral-3-14B-Reasoning-2512 (Q4_K_M)”โมเดลสาย Reasoning ขนาดใหญ่ 14B ทดสอบขีดจำกัดสูงสุดของความจุ VRAM 12GB
| เวิร์กโหลด (Workload) | Context / Gen | Prompt Speed (t/s) | Decode Speed (t/s) | TTFT (ms) | E2E Latency (ms) |
|---|---|---|---|---|---|
| Content Generation | 512 / 256 | 1,112.2 / 491.7 | 38.5 / 35.8 | 656 / 1,186 | 7,305 / 8,348 |
| Creative Writing | 512 / 512 | 1,112.2 / 491.7 | 37.6 / 35.5 | 537 / 1,112 | 14,167 / 15,528 |
| Summary 2K | 2,048 / 256 | 930.2 / 438.5 | 32.1 / 34.9 | 2,268 / 4,720 | 10,239 / 12,059 |
| Summary 4K | 4,096 / 256 | 747.6 / 402.8 | 26.3 / 33.7 | 5,485 / 10,192 | 15,233 / 17,779 |
| Summary 8K | 8,192 / 256 | 535.9 / 345.6 | 19.7 / 31.8 | 15,312 / 23,711 | 28,315 / 31,756 |
| Code Analysis 4K | 4,096 / 256 | 747.7 / 403.0 | 26.3 / 33.8 | 5,592 / 10,277 | 15,309 / 17,860 |
การวิเคราะห์ผลการทดสอบ
หัวข้อที่มีชื่อว่า “การวิเคราะห์ผลการทดสอบ”1. ปรากฏการณ์สองขั้ว: Vulkan ชนะ Prefill ขาดลอย แต่ SYCL ครองความนิ่งใน Long Context
หัวข้อที่มีชื่อว่า “1. ปรากฏการณ์สองขั้ว: Vulkan ชนะ Prefill ขาดลอย แต่ SYCL ครองความนิ่งใน Long Context”ผลการทดสอบชี้ให้เห็นความแตกต่างอย่างชัดเจนระหว่างระดับการพัฒนาของไดรเวอร์และเคอร์เนลคำนวณ:
- ทำไม Vulkan ถึงทำ Prefill ได้เร็วกว่า 1.5x – 2.2x เท่า?
ในขั้นตอนการประมวลผลคำสั่งนำเข้า (Prefill Phase) คอมพิวต์เคอร์เนลของ Vulkan ใน
llama.cppถูกออกแบบให้กระจายงานเมทริกซ์หลายมิติ (GEMM) ผ่าน Shader Cores ของชิป Xe2 ได้อย่างเต็มประสิทธิภาพโดยมี Overhead ในระดับรันไทม์ต่ำมาก ส่งผลให้อัตราการอ่านคำสั่งพุ่งสูงถึง 1,890 tokens/s บนโมเดล 8B ขณะที่ SYCL ยังมีค่าหน่วงการเตรียมงาน (Dispatch/Kernel Launch Overhead) บน Windows ทำให้ความเร็วเริ่มต้นตกลงมาอยู่ที่ระดับ 500 – 850 tokens/s - ทำไมความเร็ว Decode ของ Vulkan ถึงร่วงลงเมื่อ Context ยาวขึ้น?
เมื่อบริบทขยายจาก 512 ไปเป็น 8,192 โทเค็น ภาระการเข้าถึงหน่วยความจำเพื่อค้นหา Key-Value Cache (KV Cache Access) จะเพิ่มขึ้นเป็นทวีคูณ
- เคอร์เนล Vulkan ขาดการจัดการหน่วยความจำที่ปรับแต่งเฉพาะกับแคช L3/XMX ของ Intel Xe2 ทำให้เกิดปัญหาคอขวดแบนด์วิดท์ ส่งผลให้ความเร็วสร้างคำของโมเดล 8B ร่วงจาก 62.0 tok/s เหลือ 27.9 tok/s (-55%) และโมเดล 14B ร่วงจาก 38.5 tok/s เหลือ 19.7 tok/s (-49%)
- ในทางกลับกัน เคอร์เนลของ SYCL ถูกพัฒนาบน Intel oneAPI โดยตรง ซึ่งมีเคอร์เนล FlashAttention และการจัดการหน่วยความจำสำหรับสถาปัตยกรรม Xe2 อย่างประณีต ทำให้ความเร็ว Decode ลดลงเพียงเล็กน้อย (โมเดล 8B ลดลงเพียง 13% และโมเดล 14B ลดลงเพียง 11%)
- จุดตัด (Crossover Point): จะเกิดขึ้นที่ขนาดบริบทประมาณ 2,000 – 3,000 tokens หากบริบทสั้นกว่านี้ Vulkan จะเร็วกว่า แต่หากบริบทเกิน 3,000 tokens ขึ้นไป SYCL จะสร้างคำตอบได้เร็วกว่าอย่างเห็นได้ชัด
2. กรณีศึกษา Quantization: QAT-Q4_0 vs Q4_K_M บน Intel Arc B580
หัวข้อที่มีชื่อว่า “2. กรณีศึกษา Quantization: QAT-Q4_0 vs Q4_K_M บน Intel Arc B580”ผลการทดสอบบนโมเดล Gemma-4-12B-it ให้ข้อสังเกตสำคัญด้านวิศวกรรมการควอนไทซ์:
| เวิร์กโหลด (Workload) | เมตริก (Metric) | QAT-Q4_0 (SYCL) | Q4_K_M (SYCL) | ผลต่างบน SYCL | ผลต่างบน Vulkan |
|---|---|---|---|---|---|
| Content Gen (512) | Decode Speed | 40.73 tok/s | 32.43 tok/s | +25.6% | +5.8% |
| Summary 2K | Decode Speed | 39.64 tok/s | 31.89 tok/s | +24.3% | +5.1% |
| Summary 4K | Decode Speed | 38.55 tok/s | 31.20 tok/s | +23.6% | +4.6% |
| Summary 8K | Decode Speed | 37.48 tok/s | 30.50 tok/s | +22.9% | +3.9% |
วิเคราะห์สาเหตุ: ฟอร์แมต Q4_0 มีโครงสร้างการจัดเก็บบล็อกข้อมูลน้ำหนักแบบเรียบง่ายและคงที่ (Uniform Block Scaling) เคอร์เนล Dequantization จึงสามารถแปลงบิตกลับเป็นทศนิยมได้โดยไม่ต้องแตกตาราง Lookup หรือคำนวณสเกลย่อยหลายชั้นเหมือน K-quants (Q4_K_M) ส่งผลให้ตัวคำนวณเวกเตอร์ของ Intel Xe2 สามารถประมวลผลได้เต็มรอบสัญญาณนาฬิกา ปลดล็อกความเร็ว Decode พุ่งขึ้นถึง 1.25 เท่า บนแบ็กเอนด์ SYCL
3. ขีดความสามารถของ Intel Arc B580 12GB ตามขนาดโมเดล
หัวข้อที่มีชื่อว่า “3. ขีดความสามารถของ Intel Arc B580 12GB ตามขนาดโมเดล”[ระดับ 8B - 9B] : 50 - 62 Tokens/s (ระดับ Real-time Interactive ตอบสนองทันที)[ระดับ 12B] : 30 - 41 Tokens/s (ความเร็วเทียบเท่ามนุษย์อ่าน 3-4 คนพร้อมกัน)[ระดับ 14B] : 20 - 38 Tokens/s (รันโมเดล Reasoning ขนาดใหญ่ได้แบบ 100% Full GPU Offload)- ระดับ 8B – 9B (DeepSeek-8B, Qwen-9B):
- กินพื้นที่ VRAM ประมาณ 6 – 8 GB เหลือพื้นที่กว้างขวางสำหรับ Context 12K
- ความเร็ว Decode อยู่ที่ 48 – 62 tokens/s และ Prefill ทะลุ 1,800 tokens/s เหมาะอย่างยิ่งสำหรับการทำแชตบอทโต้ตอบเร็ว งานเขียน หรือผู้ช่วยเขียนโค้ด (Coding Copilot)
- ระดับ 12B – 14B (Gemma-12B, Ministral-14B):
- กินพื้นที่ VRAM ประมาณ 9.5 – 11.2 GB
- สามารถออฟโหลดลง VRAM 12GB ของ Arc B580 ได้เต็ม 100% โดยความเร็ว Decode ยังคงอยู่ในเกณฑ์ใช้งานจริงได้อย่างน่าประทับใจที่ 25 – 40 tokens/s สามารถนำไปใช้วิเคราะห์ตรรกะเชิงลึก (Chain-of-Thought Reasoning) ได้อย่างมีประสิทธิภาพ
ข้อเสนอแนะการตั้งค่าและการเลือกใช้งานจริง
หัวข้อที่มีชื่อว่า “ข้อเสนอแนะการตั้งค่าและการเลือกใช้งานจริง”| รูปแบบงาน (Use Case) | แบ็กเอนด์ที่แนะนำ | เหตุผลทางเทคนิค |
|---|---|---|
| สนทนาทั่วไป / แชตบอทโต้ตอบเร็ว | Vulkan | ต้องการค่า TTFT ต่ำที่สุด เพื่อให้ AI เริ่มพิมพ์คำแรกในเสี้ยววินาที (< 500 ms) |
| RAG ขนาดสั้น หรือสรุปบทความ (< 3K tokens) | Vulkan | ความเร็ว Prefill ที่สูงกว่ามหาศาลช่วยลดเวลารวมสุทธิ (E2E) ได้ดีที่สุด |
| วิเคราะห์เอกสารขนาดยาว (4K – 8K+ tokens) | SYCL | รักษาความเร็ว Decode ไม่ให้แผ่วปลาย ช่วยให้การสร้างคำตอบยาวไม่ช้าลง |
| งานเขียนโค้ดไฟล์ใหญ่ / วิเคราะห์โปรเจกต์ | SYCL | เสถียรภาพของหน่วยความจำและ FlashAttention ช่วยให้การคำนวณบริบทโค้ดมีความต่อเนื่อง |
| การเลือกไฟล์โมเดล Quantization | Q4_0 / QAT-Q4_0 | หากรันบน SYCL จะได้ความเร็ว Decode สูงกว่าไฟล์แบบ Q4_K_M ถึงประมาณ 25% |
บทสรุปผลการทดสอบ
หัวข้อที่มีชื่อว่า “บทสรุปผลการทดสอบ”การ์ดจอ Intel Arc B580 12GB GDDR6 พิสูจน์ให้เห็นว่าเป็นหนึ่งในการ์ดจอระดับความคุ้มค่าสูงสุดสำหรับงาน Local AI:
- จุดเด่นด้านขนาดหน่วยความจำ: VRAM ขนาด 12GB บนบัส 192-bit แบนด์วิดท์ 456 GB/s คือจุดแข็งที่ทำให้การ์ดรุ่นนี้เหนือกว่าคู่แข่งในระดับราคาเดียวกัน โดยสามารถรันโมเดลขนาดใหญ่ถึง 14B ได้เต็มความจุ 100% พร้อมบริบท 12,288 โทเค็น โดยไม่ต้องเผชิญปัญหาคอขวดจากการสลับข้อมูลไปที่ RAM เครื่อง
- ความยืดหยุ่นของซอฟต์แวร์: ผู้ใช้สามารถเลือกปรับแบ็กเอนด์ตามลักษณะงานได้อย่างยืดหยุ่น โดยใช้ Vulkan เพื่อเน้นการตอบสนองเริ่มต้นที่เร็วสะใจในงานบริบทสั้น-ปานกลาง และสลับไปใช้ SYCL เมื่อต้องการประสิทธิภาพความเร็ว Decode ที่เสถียรในงานบริบทยาวระดับ 8K Tokens
- ความคุ้มค่าต่อราคา: ด้วยความสามารถในการขับเคลื่อนโมเดล 8B–9B ที่ความเร็วเฉลี่ยกว่า 55 tokens/s และโมเดล 14B ที่ 30+ tokens/s ทำให้ Intel Arc B580 เป็นตัวเลือกอันดับต้น ๆ สำหรับผู้เริ่มต้นศึกษาและสร้างระบบ Local AI บนเครื่องพีซีของตนเอง
ข้อมูลอ้างอิงและบันทึกทางเทคนิค
หัวข้อที่มีชื่อว่า “ข้อมูลอ้างอิงและบันทึกทางเทคนิค”- ชุดข้อมูลทดสอบ: บันทึกผลการรันจากชุดทดสอบ PromptMark v0.2.0 ในระบบของ AIPCMag
- สเปกฮาร์ดแวร์ทางการ: Intel Arc B580 Graphics Specifications
- หน้าศูนย์รวมข้อมูลที่เกี่ยวข้อง: