MAI-Code-1.1-Flash: โมเดล MoE 137.9B บีบเหลือ 53 GB รันบน Windows ด้วย RTX Spark
Microsoft เผยแพร่บล็อกวิศวกรรมเรื่องการทำให้โมเดลเขียนโค้ดขนาดใหญ่รันบนพีซี Windows ได้จริง โดยใช้ MAI-Code-1.1-Flash เป็นตัวอย่าง โมเดลนี้เป็น MoE ขนาด 137.9 พันล้านพารามิเตอร์ ที่ถูกทำ quantization ลงเหลือ 53.0 GiB และรันบนเครื่อง NVIDIA RTX Spark ที่มี unified memory 128 GB
หมายเหตุ: ตัวเลขทุกตัวในบทความนี้เป็นผลวัดและข้อมูลจากบล็อกของ Microsoft ในค่ายเฉพาะ (RTX Spark 128 GB, GPU allocation 64 GB) และ Microsoft ระบุเองว่าไม่ควรนำไปสรุปรวมกับสภาพการให้บริการแบบอื่น
ประเด็นสำคัญ
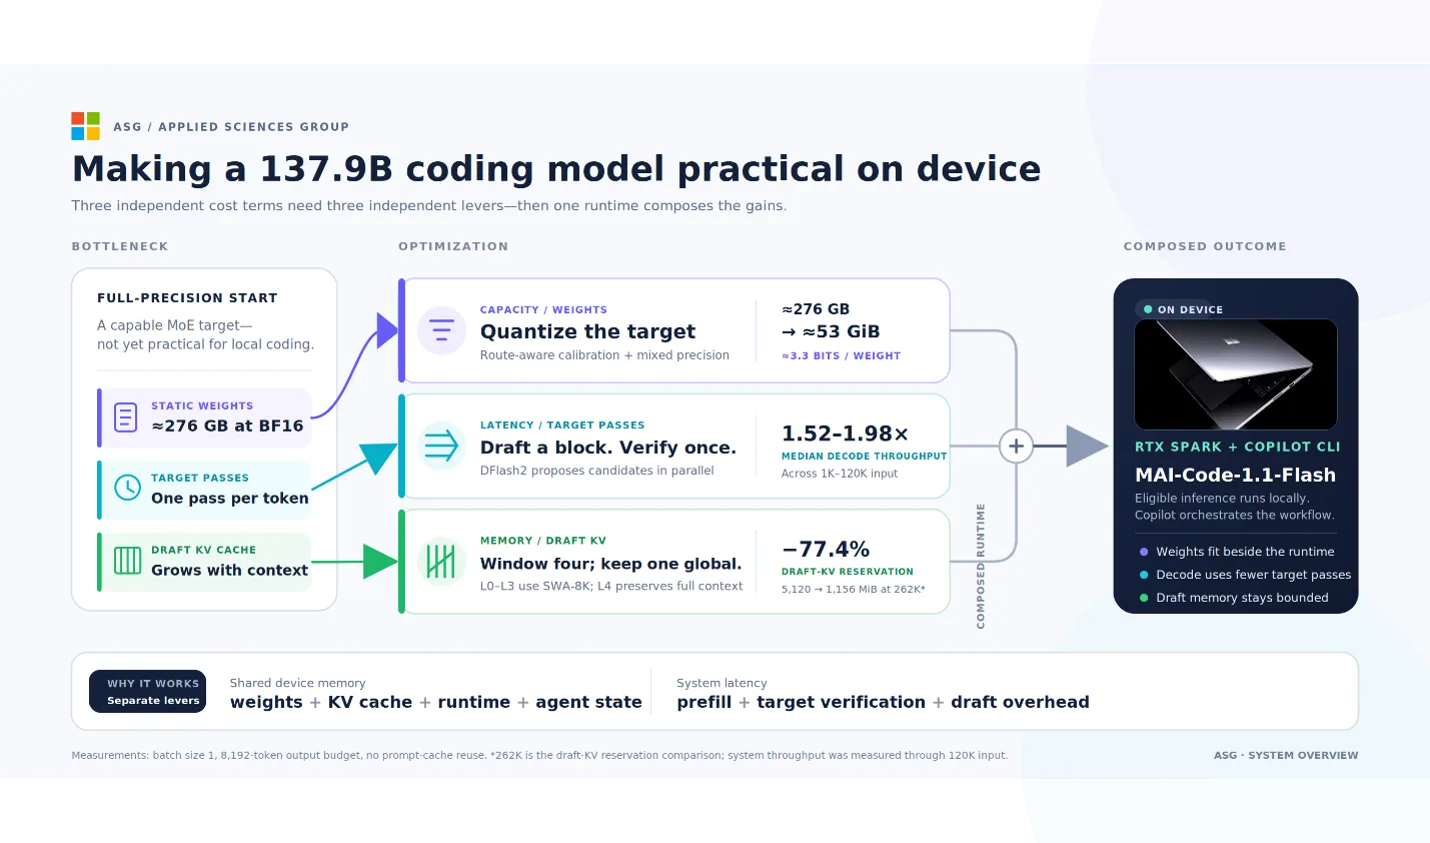
หัวข้อที่มีชื่อว่า “ประเด็นสำคัญ”- น้ำหนักโมเดลลดจากประมาณ 276 GB (16-bit) เหลือ 53.0 GiB (3.31 bpw) และมีรุ่นเล็กลงอีกที่ 46.1 GiB (2.87 bpw)
- ใช้ speculative decoding ด้วย draft model ที่ฝึกเอง ทำให้ decode เร็วขึ้น 1.52 ถึง 1.98 เท่าในค่ายที่วัด
- ที่ input 120K token ความเร็วเพิ่มจาก 25.81 เป็น 51.12 tokens/s (ค่ามัธยฐาน)
- KV cache ของ draft model ถูกลดลง 77.4% ที่ context 262K เพราะ KV cache แย่งหน่วยความจำกับน้ำหนักโมเดล
ต้องจัดสมดุลในการลดขนาดโมเดล
หัวข้อที่มีชื่อว่า “ต้องจัดสมดุลในการลดขนาดโมเดล”Microsoft อธิบายว่าการรันโมเดลใหญ่บนเครื่องตัวเอง ต้องจัดสมดุลสามอย่างภายใต้ข้อจำกัดเรื่องหน่วยความจำของเครื่อง คุณภาพของโมเดล พื้นที่ที่โมเดลกินไป และความเร็วในการตอบ
- ระดับโมเดล: ต้องใช้ mixed precision และการ calibrate อย่างระวัง เพื่อรักษาคุณภาพเมื่อลดบิต
- ระดับ inference: format ที่ใช้บิตต่ำต้องมี kernel ที่มีประสิทธิภาพ ความเร็วถึงจะดีขึ้น
- ระดับระบบ: KV cache โตตามความยาว context และแย่งพื้นที่กับน้ำหนักโมเดล
ข้อสรุปของ Microsoft คือเป้าหมายไม่ใช่ลดบิตให้ต่ำที่สุด แต่ต้องปรับคุณภาพ ขนาดน้ำหนัก ขนาด KV cache และความเร็ว decode ไปพร้อมกัน ใครที่เคยลองเลือก quant ให้พอดี VRAM จะเห็นโจทย์เดียวกัน (อ่านพื้นฐานได้ที่ Quantization และ bpw และ VRAM budget และ GPU offload)
โมเดลและวิธี quantize
หัวข้อที่มีชื่อว่า “โมเดลและวิธี quantize”MAI-Code-1.1-Flash เป็น MoE 137.9B พารามิเตอร์ โดย expert คิดเป็นประมาณ 96.6% ของพารามิเตอร์ทั้งหมด จึงเป็นส่วนที่กินพื้นที่น้ำหนักมากที่สุด (ดูความต่างของ MoE กับ dense ได้ที่ MoE vs Dense)
Microsoft ใช้ mixed precision โดยกำหนดบิตตามบทบาทของ tensor และใช้ข้อมูลความไวจากการ calibrate ช่วยคัดตัวเลือก แต่ไม่ได้ใช้ตัดสินสูตรสุดท้าย ผู้พัฒนาเลือกรุ่นสุดท้ายด้วยการประเมินแบบ end-to-end เพราะหลายรุ่นให้คุณภาพโค้ดใกล้เคียงกันที่ขนาดต่างกัน
ตัวอย่างสูตร Q2-XXS ตามที่ Microsoft อธิบาย:
| ส่วนของโมเดล | สัดส่วนพารามิเตอร์ | ความละเอียดที่ใช้ |
|---|---|---|
| expert gate และ up projection | 64.4% | ประมาณ 2 bit ต่อ weight |
| expert down projection | 32.2% | ประมาณ 4 bit ต่อ weight |
| attention, dense feed-forward, embedding, output, routing, normalization | 3.4% | คงความละเอียดสูงกว่าตามที่จำเป็น |
สองจุดปฏิบัติการที่ Microsoft เปิดตัว:
| รุ่น | ขนาดน้ำหนัก (GiB) | bpw |
|---|---|---|
| Q2-XS (รุ่นที่ปล่อยใช้งาน) | 53.0 | 3.31 |
| Q2-XXS (รุ่นกะทัดรัดกว่า) | 46.1 | 2.87 |
ขนาดข้างต้นเป็นน้ำหนักโมเดลเท่านั้น ไม่รวม KV cache หน่วยความจำ และ runtime อื่น ๆ ในรุ่น 53.0 GiB เปิดให้ใช้ผ่าน Microsoft Foundry และเป็น local model ใน GitHub Copilot
บทเรียนที่ Microsoft สรุปคือ การเลือกบิตเป็นปัญหาเชิงทดลอง การ calibrate ช่วยลดตัวเลือก แต่จุดสุดท้ายต้องวัดกับงานที่โมเดลจะทำจริง โดยเปรียบเทียบหลาย benchmark เช่น SWE-Bench Verified กับ Terminal-Bench 2.1 เพราะรุ่นที่ดูเท่ากันใน benchmark หนึ่งอาจต่างกันใน benchmark อื่น
เร่ง decode ด้วย speculative decoding
หัวข้อที่มีชื่อว่า “เร่ง decode ด้วย speculative decoding”Speculative decoding คือให้ draft model ที่มีขนาดเล็กทำหน้าที่เสนอ token เป็นบล็อกไว้ล่วงหน้า แล้วให้โมเดลหลักตรวจในรอบเดียว Microsoft ฝึก draft model ขึ้นเองสำหรับ MAI-Code-1.1-Flash ด้วยสถาปัตยกรรม DFlash2 (สร้างต่อจาก DFlash) ซึ่งใช้ข้อมูลภายในของโมเดลหลักและ block diffusion ในการทำนาย token เป็นบล็อก
จากการทดสอบบน BigCodeBench, HumanEval และ LiveCodeBench ที่แยกไว้ การเลือก candidate ทำให้ค่า mean accepted tokens (MAT) เพิ่มจาก 4.26 เป็น 4.43 เมื่อใช้ draft ตัวเดียวกัน
KV cache ของ draft ก็ต้องคุม
หัวข้อที่มีชื่อว่า “KV cache ของ draft ก็ต้องคุม”ที่ context ยาว KV cache ของ draft model โตจนแย่งหน่วยความจำกับน้ำหนักโมเดล Microsoft รายงานว่าที่ context 262K ถ้าไม่จำกัด KV cache ของ draft จะใกล้ 70% ของ KV cache ของโมเดลหลัก วิธีแก้คือใช้ sliding-window attention ขนาด 8K ใน 4 ชั้นแรกจากทั้งหมด 5 ชั้นของ draft และเก็บ attention เต็ม context ไว้เฉพาะชั้นสุดท้าย
ผลที่รายงาน (โดยไม่ต้องฝึกใหม่):
| รายการ | ก่อน | หลัง |
|---|---|---|
| KV cache ของ draft ที่ context 262K (MiB) | 5,120 | 1,156 (ลด 77.4%) |
อัตราการยอมรับ token ค่า MAT โดยประมาณ และ decode throughput ต่างจาก draft แบบ full attention ไม่เกิน 2% และในชุดทดสอบ SWE-Bench 30 งานภายใต้การตั้งค่าเดียวกัน ผลผ่านหรือไม่ผ่านตรงกัน 29 จาก 30 งาน (Microsoft ระบุว่าบ่งชี้พฤติกรรมที่ใกล้เคียงกันบนชุดทดสอบนี้)
การทดสอบบน RTX Spark
หัวข้อที่มีชื่อว่า “การทดสอบบน RTX Spark”เงื่อนไขที่ Microsoft ใช้ทดสอบ:
- เครื่อง: RTX Spark, unified memory 128 GB, จัดสรรให้ GPU 64 GB
- โมเดล: Q2-XS เทียบแบบไม่มี draft กับมี draft (DFlash2)
- input 6 ระดับ ตั้งแต่ 1K ถึง 120K token
- แต่ละ request สร้างผลลัพธ์ 8,192 token ทำซ้ำ 3 ครั้ง และรายงานค่ามัธยฐาน
ผลที่ได้:
| รายการ (input 120K) | ไม่มี draft | มี draft (DFlash2) |
|---|---|---|
| decode throughput (tokens/s) | 25.81 | 51.12 |
| end-to-end latency (วินาที) | 527.25 | 382.41 (ลด 27%) |
ตลอดทุกระดับ input ที่ทดสอบ draft เพิ่ม throughput ของ decode ได้ 1.52 ถึง 1.98 เท่า และเมื่อ input โตจาก 1K ถึง 120K token หน่วยความจำ GPU สูงสุดในโหมดที่เปิด draft เพิ่มจาก 59.42 เป็นเพียง 63.50 GB ซึ่งเป็นผลจากการจำกัด KV cache ของ draft ข้างต้น
Microsoft ย้ำว่าตัวเลขเหล่านี้เป็นของการตั้งค่า Q2-XS กับ DFlash2 ในค่ายนี้เท่านั้น ไม่ควรนำไปใช้กับเงื่อนไขการให้บริการอื่น
เรื่องนี้เอาไปใช้กับเครื่องของเราอย่างไร
หัวข้อที่มีชื่อว่า “เรื่องนี้เอาไปใช้กับเครื่องของเราอย่างไร”บทความของ Microsoft เป็นเรื่องราวของเครื่องที่มีหน่วยความจำ 128 GB แต่ภาพรวมที่เกี่ยวกับคนที่มี GPU หรือพีซีอยู่แล้วคือแนวคิดเหล่านี้
- ขนาดไฟล์น้ำหนักอย่างเดียวไม่พอ ต้องเผื่อ KV cache และ runtime ซึ่งโตตาม context (อ่านเพิ่มที่ Context window และ KV cache)
- ในเครื่องที่ทดสอบ น้ำหนักโมเดล 53.0 GiB อยู่ในพื้นที่ของ GPU allocation 64 GB และ peak ของการรันที่เปิด draft อยู่ที่ 59.42 ถึง 63.50 GB นั่นหมายความว่าต้องมีพื้นที่เตรียมให้กับ context/KV Cache อีกเกือบ 10GB
- ตัวเลขบิตต่ำสุดไม่ใช่คำตอบเสมอ Microsoft มองว่าบิตเป็นหนึ่งในตัวแปรของการออกแบบระบบ ร่วมกับ speculative decoding และการคุม KV cache
- ความเร็วในการ decode (TPS) เพิ่มได้จากเทคนิคฝั่ง inference โดยไม่ต้องเปลี่ยนน้ำหนักของโมเดลหลัก (อ่านที่ Prefill vs Decode)
Microsoft ยังเสนอมุมมองว่าโมเดล local และโมเดล cloud เสริมกัน โดย local ทำงานใกล้ข้อมูลและเครื่องมือของนักพัฒนา และไม่มีค่า token ต่อครั้ง ส่วน cloud ยังใช้เมื่อต้องการความสามารถที่สูงกว่า
แหล่งอ้างอิง
หัวข้อที่มีชื่อว่า “แหล่งอ้างอิง”- Karthik Vijayan, “Advancing the Quality-Efficiency Frontier for Coding AI on Windows PCs”, Microsoft Foundry on Windows devblog, 5 พฤศจิกายน 2026: https://devblogs.microsoft.com/foundry-on-windows/coding-ai-on-windows-pcs-quality-efficiency/